一、SCL [2024]
《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》
尽管
multimodal data在提升模型准确性方面的潜力已被认可,但许多大规模工业推荐系统,包括Taobao display advertising system,其模型仍主要依赖sparse ID features。在这项工作中,我们探索了利用multimodal data来增强推荐准确性的方法。我们首先识别出在工业系统中以既有效又cost-efficient的方式采用multimodal data的关键挑战。为应对这些挑战,我们引入了一个两阶段框架,包括:1):pre-training of multimodal representations以捕获semantic similarity。2):将这些representations与现有的ID-based models集成起来。
此外,我们详细介绍了我们的
production system的架构,该系统旨在促进multimodal representations的部署。自2023年中期集成multimodal representations以来,我们观察到Taobao display advertising system取得了显著性能提升。我们相信,我们所收集的见解将为从业者提供宝贵资源,其中从业者希望在其系统中利用multimodal data。传统上,
Taobao display advertising system中使用的recommendation models,与许多其他工业系统一样,主要依赖discrete IDs作为特征。尽管ID-based models被广泛使用,但它们具有内在缺陷,例如无法捕获multimodal data中包含的semantic information。为了解决这些问题,某些工业系统尝试将
multimodal data纳入ID-based models(《Better Generalization with Semantic IDs: A case study in Ranking for Recommendations》、《COURIER: Contrastive User Intention Reconstruction for Large-Scale Pre-Train of Image Feature》)。通常,这些方法采用两阶段框架,包括:1):通过generic or scenario-specific pre-training获得multimodal representations。2):将这些representations集成到推荐模型中。
尽管取得了这些进展,大量工业系统仍然完全依赖
ID features。这通常归因于一种担忧:multimodal data带来的性能收益可能无法补偿其部署成本。这些成本包括pre-training multimodal encoders、为new items增量地generating representations、以及同时对online servers和near-line training systems的其他必要升级。因此,multimodal representations的successful integration取决于能否在提升其性能收益的同时最小化部署成本。为实现这两个关键目标,应解决三个实际挑战:
Design of the pre-training task:multimodal representations在提升性能方面的有效性取决于其提供有意义semantic information的能力,而这是ID features难以捕获的。必须设计pre-training tasks,使multimodal representations能够封装此类semantic information。Integration of multimodal representation:ID features与multimodal representations之间的固有discrepancies,例如training epochs的difference,要求采用能够有效将multimodal representations纳入ID-based model的方法。这些方法应利用每种feature type的优势来提升模型的整体性能。Design of the production system:整个production workflow,包括为new items生成multimodal representations及其在下游任务中的最新应用,都应以高效方式来设计。
为应对这些挑战,我们采用如
Figure 1所示的两阶段框架。在
pre-training阶段,我们提出语义感知对比学习(Semantic-aware Contrastive Learning: SCL)方法。具体而言,我们利用用户的search query和后续purchase action来构建语义相似样本对(semantically similar sample pairs),捕获电子商务场景中与用户最相关的dimensions of semantic similarity。对于负样本,我们从一个大型memory bank中抽取。SCL方法使multimodal representations能够有效度量items之间的semantic similarities。在获得高质量
multimodal representations后,我们提出两种方法将这些representations纳入现有的ID-based model。首先,我们开发了一种名为
SimTier的方法,用于度量target item与用户先前交互过的items之间的相似程度。所得到的SimTier vector随后与其他embeddings拼接起来,并馈入后续层。此外,为解决
multimodal representations与ID embeddings之间的training epochs差异,我们引入MultimodAl Knowledge Extractor: MAKE模块。MAKE模块将multimodal representations相关的parameters的optimization(例如与multimodal representations相连的MLP的参数)与ID-based model的parameters optimization分离,从而使multimodal representations相关的parameters能够更有效地学习。
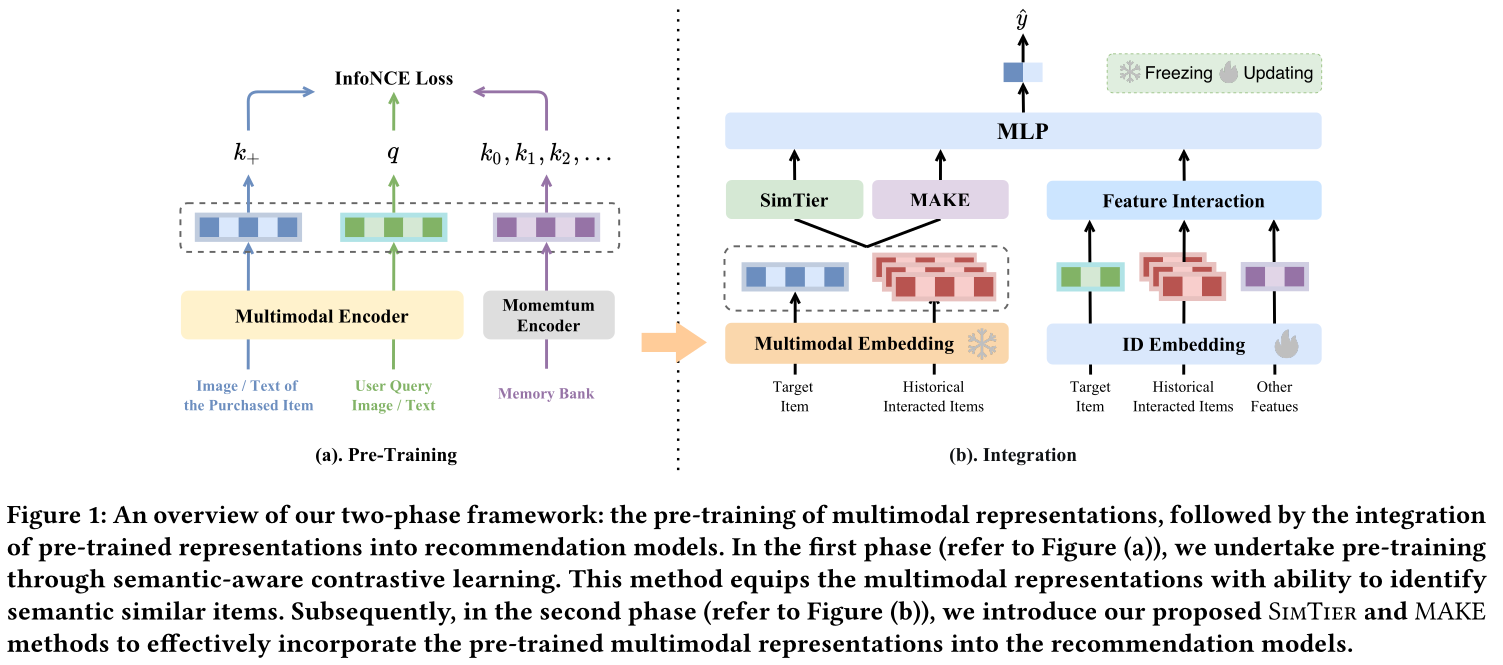
我们还介绍了
production system的设计,该系统促进multimodal representations的部署。具体而言,系统实时地为newly introduced items生成multimodal representations,并确保这些representations立即可供training infrastructure和online prediction server使用。这种设计实现了极低延迟——从introduction of an item到模型使用其multimodal representations仅需几秒钟。自2023年中期以来,multimodal representations已部署在Taobao display advertising system中,带来了显著性能提升。论文就是一些工程技巧的应用,创新点不足。
1.1 相关工作
目前,
ID features构成工业推荐模型的核心。尽管ID features被广泛采用,ID features具有显著局限性,包括难以捕获semantic information、以及持续存在的冷启动问题(《Image Matters: Visually Modeling User Behaviors Using Advanced Model Server》、《Image Feature Learning for Cold Start Problem in Display Advertising》、《Methods and metrics for cold-start recommendations》、《Adversarial gradient driven exploration for deep click-through rate prediction》)。相反,multimodal data提供丰富的semantic information,促使许多研究探索将其纳入推荐模型。一些研究探讨了以端到端方式与
recommendation model training一起学习multimodal representations的潜力(《Deep CTR Prediction in Display Advertising》、《End-to-End Image-Based Fashion Recommendation》、《Where to Go Next for Recommender Systems? ID- vs. Modality-based Recommender Models Revisited》)。然而,此类过程所需的巨大计算资源常常阻碍其在工业系统中的采用。因此,我们关注两阶段范式(《Multimedia features for click prediction of new ads in display advertising》、《Image Matters: Visually Modeling User Behaviors Using Advanced Model Server》、《Ups and Downs: Modeling the Visual Evolution of Fashion Trends with One-Class Collaborative Filtering》、《Images Don’t Lie: Transferring Deep Visual Semantic Features to Large-Scale Multimodal Learning to Rank》、《PinnerSage: Multi-Modal User Embedding Framework for Recommendations at Pinterest》、《Better Generalization with Semantic IDs: A case study in Ranking for Recommendations》、《COURIER: Contrastive User Intention Reconstruction for Large-Scale Pre-Train of Image Features》),并旨在分享我们的方法和宝贵见解。
1.2 预备知识
在深入细节之前,我们首先介绍工业系统中使用的典型
ID-based model结构。推荐模型中的
ID Features:常见推荐模型在包含数十亿ID features的大规模数据集上训练(《XDL: An Industrial Deep Learning Framework for High-Dimensional Sparse Data》、《PICASSO: Unleashing the Potential of GPU-centric Training for Wide-and-deep Recommender Systems》)。这些ID features用于表示users profiles、user historical interacted items、target item(待预测)以及contextual information。例如,我们可以用相应的item ID和category ID表示target item,并通过a sequence of corresponding item IDs and category IDs表示user historical interacted items。ID-based Model的结构:ID-based recommendation model遵循embedding and MLP的架构,通常包含historical behavior modeling模块(《Deep Interest Evolution Network for Click-Through Rate Prediction》、《Deep interest network for click-through rate prediction》)。最开始,所有
ID features都被转换为embeddings。historical behavior modeling模块随后通过分析the embedding of target item与embeddings of the user’s historical interacted items之间的相关性,度量用户对target item的兴趣。具体而言,这些模块通过聚合the embedding of target item和embeddings of the historical interacted items,从而生成fixed-length vectors。这些
fixed-length vectors随后与其他ID embeddings拼接,形成后续MLP的输入,最后产生final prediction。
1.3 Pre-Training of Multimodal Representations
至于
multimodal data,对它的利用(utilization)可以改进historical behavior modeling。具体而言,multimodal data可用于度量target item与users's historical interacted items之间的semantic similarity。以item images为例,它们可用于度量image of the target item与images of historical interacted items之间的视觉相似性(visual similarity)。直观上,更高的semantic similarity表示target item与users’ historical behavior之间更强的相似性,表明用户感兴趣的可能性更高。这一见解强调了designing a pre-training task的重要性,该任务应使multimodal representations能够有效辨别item pairs之间的semantic similarity。
1.3.1 Semantic-Aware Contrastive Learning
为获得能够辨别
semantic similarity的representations,我们提出语义感知对比学习(semantic-aware contrastive learning: SCL)方法,该方法吸引语义sample pairs并排斥语义不相似sample pairs。为实现这一点,必须定义用于监督的语义相似sample pairs和不相似对sample pairs。为理解这一点的重要性,考虑Figure 5中所示的例子,其中三个枕头(pillows)几乎相同,但显示出细微差异,例如图案差异或轻微外观差异。如果语义相似sample pairs的definition不充分,representations可能无法捕获这些细微差异。实际上,这些细微区别常常被专注于捕获通用概念(general concepts)的representations所遗漏。下面,我们将详细阐述为电子商务场景定制的
pre-training dataset的构建,以及contrastive learning过程的optimization策略。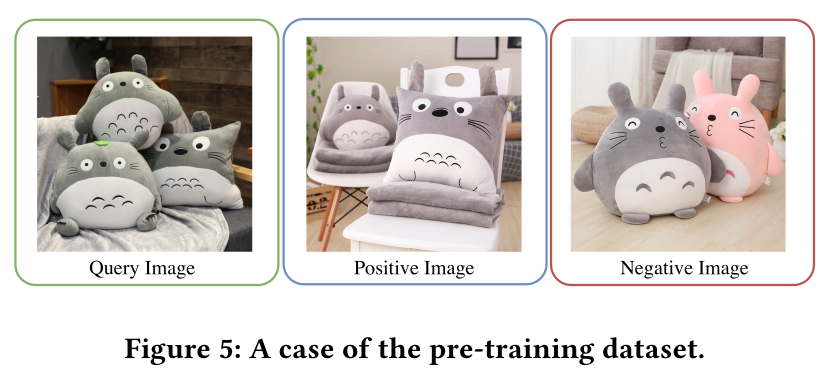
1.3.2 Construction of Pre-Training Dataset
在电子商务背景下,用户的
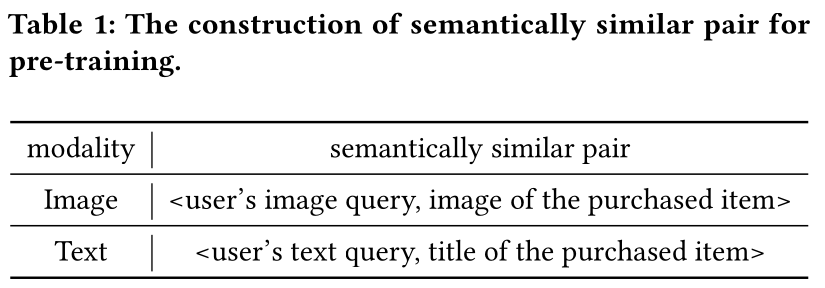
search query和后续purchase action通常表示query与purchased item之间的强烈的semantic similarity。例如,如果用户搜索一张枕头图片并随后购买一个枕头,这一系列行为表明这两张图像(queried image和image of the purchased item)在语义上足够相似,能够满足用户的purchase intentions。因此,如Table 1所示,在训练text encoder时,我们将text of the user’s search query与title of the item they ultimately purchased配对为语义相似sample pairs。类似地,对于图像模态,将用户的image query(从淘宝的image search场景获得)与后续所购买item的图像配对。这种配对策略自然捕获了电子商务场景中与用户最相关的semantic similarity维度,反映了影响其购买决策的元素。对于每个语义相似
sample pairs,我们将所有其他样本视为潜在不相似样本,这可以通过使用当前mini-batch中的样本作为负样本来实现。为了进一步提高模型性能,我们旨在增加训练期间可用的负样本数量。具体而言,我们从MoCo(《Momentum Contrast for Unsupervised Visual Representation Learning》)中获得灵感,采用一种使用动量更新模型的技术,从而便于从更大的memory bank中采样更多负样本。更复杂的negative pairs构建策略,例如识别hard negatives(《FaceNet: A unified embedding for face recognition and clustering》),将在实验章节中详细阐述。论文中引入了三种负样本:
当前
mini-batch内样本:当前batch中,其他样本相对于某个query就是负样本。这是最基础的负样本。MoCo memory bank中的历史负样本:通过Queue,把过去很多batch的key representation保存下来。当前query会和Queue中大量key对比。论文中Queue sizequery可以和约20万个key做对比,负样本数量远大于普通in-batch负采样。Hard negative:如果用户搜索了某个query,点击了某个商品,但最终购买的是另一个商品。那个 “点击了但没买” 的商品,与query和正样本都很相似,但它是负样本。这种样本叫hard negative。
MoCo式负采样:MoCo的关键设计是维护一个队列 (queue),也就是论文里说的memory bank。假设队列大小为encoded key representation,并且通常经过L2归一化。队列按时间顺序更新:当前
mini-batch的样本经过key encoder而被编码。这些
key representations入队。最旧的
key representations出队。队列大小始终保持
这样,每个
query在做InfoNCE对比时,不只和当前batch里的少量样本对比,而是和队列中约20万个key representations对比。为什么要用动量编码器:如果只是简单维护一个队列,会有问题:队列里的旧
key是由旧参数编码出来的,而当前query是由当前参数编码出来的。如果encoder参数变化太快,旧key和当前query就不在同一个representation space里,对比学习会不稳定。MoCo的解决办法是使用两个encoders:query encoder:参数key encoder:参数其中
1,例如0.999。也就是说,key encoder缓慢跟随query encoder变化。这其实是一个递推公式:
当
1000步的因为
MoCo要维护一个很大的负样本队列memory bank。队列里的key是过去很多步由key和新key就来自差异很大的encoder,representation space不一致,对比学习会失效。所以这里需要一个较大的
这样做的好处是:
队列中的旧
key虽然来自过去,但因为key encoder变化很慢,它们仍然和当前query处于相近的representation space。队列可以开得很大,不需要每次重新编码所有负样本;
显存和计算可控,因为队列只存编码向量,不存计算图,也不对队列中的
key反传梯度。
所以论文说 “采用动量更新模型的技术,从而便于从更大的
memory bank中采样更多负样本”,本质就是:动量更新保证队列中历史key与当前query的representation一致,因此可以放心使用超大memory bank作为负样本池。
1.3.3 Optimization
我们使用广受认可的
InfoNCE loss(《Representation learning with contrastive predictive coding》)作为损失函数。给定encoded queryencoded positive samplememory bank中的encoded sample representations的集合,其中memory bank size大小(《Momentum Contrast for Unsupervised Visual Representation Learning》),InfoNCE loss采用点积来度量相似性(所有representations均进行L2归一化)。如下公式所示,当querymemory bank中所有其他样本偏离时,损失值降低。注意,这里的
这里,
196,800。通过这种方式,
SCL方法使representations能够辨别comparable items之间的细微差异,这对推荐模型至关重要。注意,论文使用了两种对比损失:
InfoNCE loss和Triplet Loss。InfoNCE loss是主损失:负责大规模对比学习,利用MoCo memory bank中的大量负样本,让query靠近正样本、远离所有其他key。注意:
in-batch negative并没有被排除,而是被MoCo memory bank统一吸收了。在这里,负样本集合写成了memory bank,而当前mini-batch的样本本身也会进入这个memory bank,所以in-batch negative隐含在其中,只是没有单独强调。Triplet Loss是辅助损失:专门针对<Query, Positive, Negative>三元组中的hard negative,用margin约束强化细粒度区分。
对于
hard negative,SCL对每个<Query, Positive, Negative>三元组应用triplet loss,使模型:拉近Query和Positive,推远Query和Negative。这样模型能区分非常细粒度的差异,比如三个几乎一样的枕头,只是图案或外观略有不同。普通随机负样本可能太容易区分,而
hard negative能迫使模型学到更精细的语义判别能力。常用的
Triplet Loss定义为:其中:
Query;Positive;Negative。margin。其语义是:距离
1.4 Integration with Recommendation Models
将
multimodal representations集成到ID-based recommendation model中的一种直接方法,是将这些multimodal representations与ID embeddings for both the target item and users’ past interacted items拼接(《Image Matters: Visually Modeling User Behaviors Using Advanced Model Server》、《COURIER: Contrastive User Intention Reconstruction for Large-Scale Pre-Train of Image Features》)。这种concatenation之后接入user behavior modeling模块,随后馈入MLP进行final prediction。尽管这种方法很直接,但我们发现性能提升有限。为研究此事,我们分享我们的观察和见解。
1.4.1 Observations and Insights
我们首先分享关于纳入
multimodal representations的观察和见解。Observation 1:简化multimodal representations的用法可提升性能。我们的研究表明,将multimodal representations直接集成到ID-based model中并不能产生最优性能,详见实验章节。该问题出现的原因是,multimodal representations关联的parameters(例如与multimodal representations相连的MLP的参数),在joint training process with the ID embeddings过程中没有得到充分学习(《COURIER: Contrastive User Intention Reconstruction for Large-Scale Pre-Train of Image Features》)。相反,简化multimodal representations用法的策略,例如将其转换为semantic IDs(从而representing the embedding vectors with IDs)(《Better Generalization with Semantic IDs: A case study in Ranking for Recommendations》、《COURIER: Contrastive User Intention Reconstruction for Large-Scale Pre-Train of Image Features》),似乎提供了更好的性能。Observation 2:ID-based models和multimodal-based models存在training epoch discrepancy。在工业场景中,
ID-based models通常只训练one epoch以避免过拟合(《Towards Understanding the Overfitting Phenomenon of Deep Click-Through Rate Model》)。相反,
CV和NLP领域的模型通常训练multiple epochs。
一个自然的问题出现了:一个
multimodal-based recommendation model理想的training epochs是多少?为回答这个问题,我们开发了一个仅使用multimodal representations作为input features、没有任何ID features的推荐模型,并分析其性能如何随training epochs变化。详细
convergence curve如Figure 3所示。我们发现:采用
multimodal data的模型受益于在同一数据集上训练多个epochs,其性能随epochs增加而显著提升。相反,
ID-based models遭受one-epoch overfitting现象,模型性能在第二个epoch开始时急剧下降(《Towards Understanding the Overfitting Phenomenon of Deep Click-Through Rate Model》)。
结果表明,
multimodal representations关联的parameters需要更多epochs才能正确收敛,这与ID-based model的行为形成对比。因此,当将multimodal representations纳入ID-based model并仅训练one epoch时,存在multimodal-related parameters可能训练不足的风险。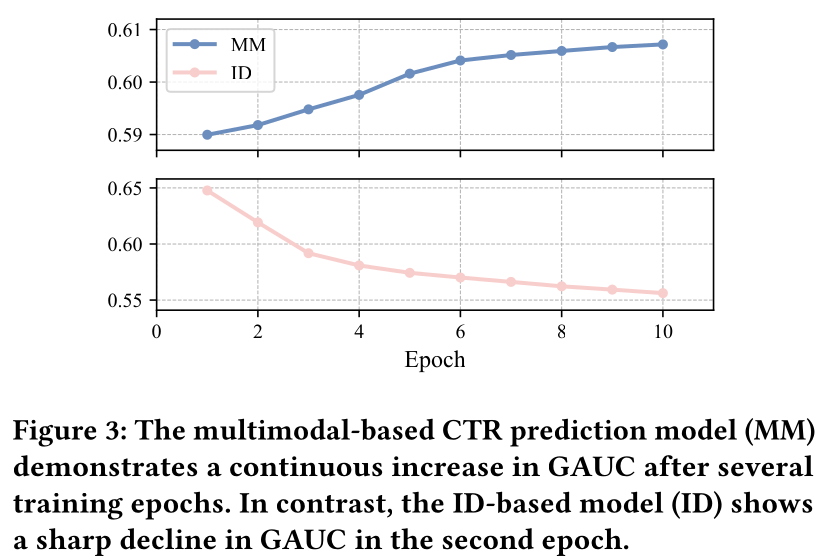
1.4.2 Method I: SimTier
observation 1要求简化multimodal representations的使用。为此,我们提出一种简单却有效的方法SimTier。如Figure 2 (a)所示,SimTier首先计算target candidate item的multimodal representationsuser’s historically interacted items的multimodal representations在计算
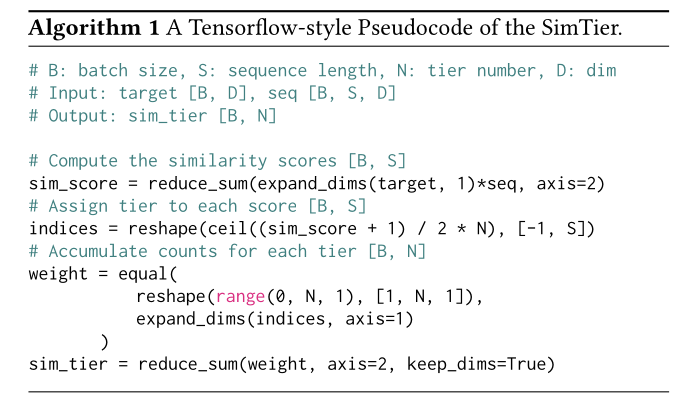
similarity scores之后,我们将score rangepredefined bins。在每个bin内,我们统计落入相应range的similarity scores数量。因此,我们获得一个bin中similarity scores的数量。这样,SimTier有效将一组高维multimodal representations转换为一个target item与user’s historical interactions之间的相似程度。所得embeddings拼接,并馈入后续MLP。我们在Algorithm 1中提供SimTier的伪代码。注意,SimTier可被视为a set-to-set function(《Deep Sets》)。未来工作可以探索将时间信息集成到SimTier中的更高级方法。其实就是以多模态
representation作为桥梁,计算target item和historical items的相似度,然后对相似度集合进行池化操作(这里是分桶池化)。如果替换为最大池化,效果会如何?论文并未说明。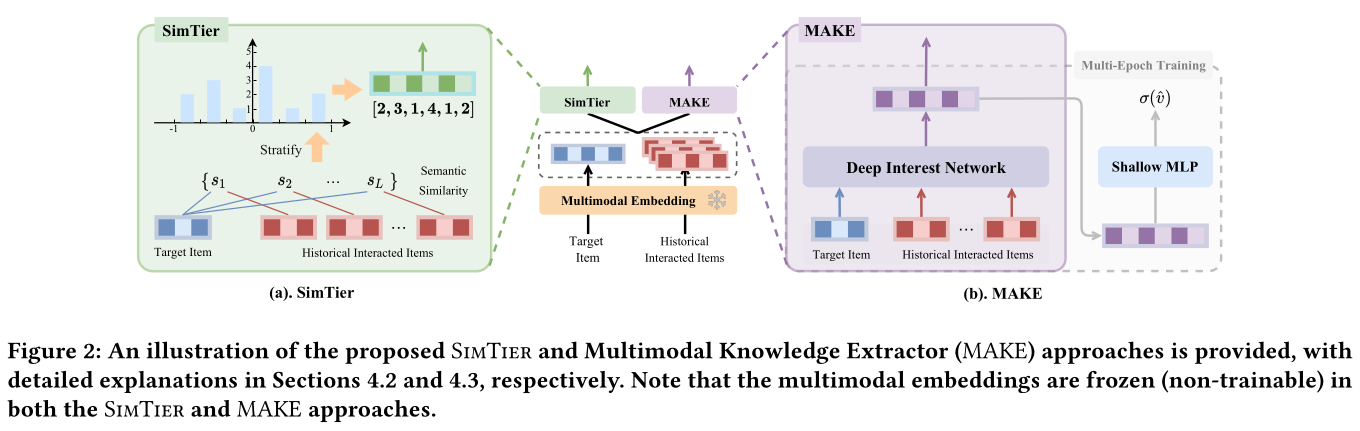
1.4.3 Method II: Multimodal Knowledage Extractor (MAKE)
为解决
ID features与multimodal representations所需training epochs的差异,我们引入多模态知识提取器(MultimodAl Knowledge Extractor: MAKE)模块,将multimodal related parameters的optimization与ID features的optimization解耦。MAKE模块包含两个步骤:1):multi-epoch training以提取有用的多模态知识,2):下游任务对知识的利用。
Multi-epoch training of multimodal related parameters:MAKE模块的目标是预训练parameters related to multimodal representations多个epochs,以确保其收敛。在实践中,我们利用CTR prediction task作为recommendation pre-training task。如Figure 2 (b)所示,我们首先开发一个DIN-based user behavior modeling模块(《Deep interest network for click-through rate prediction》)。该模块处理target item和historical interacted items的pre-trained multimodal representations,产生output之后,
logit然后我们优化
predicted click probability与二元click labelcross-entropy loss,如下公式所示:recommendation pre-training task允许MAKE模块通过多轮训练细化其参数,并从multimodal representations中提取知识注意:这里的
pre-training不是用预训练embedding,而是预训练一个DIN network。然后把这个DIN network整体迁移到下游。Knowledge utilization:在获得向量intermediate outputs与other embeddings拼接,并将该combined data馈入后续层。MAKE模块multi-epoch training的implementation调和了ID embeddings和multimodal representations所需training epochs的差异,从而带来更好的性能。在下游应用时,会把这个
pretrained DIN network直接集成过来。注意,在Figure 2中提示了:multimodal embeddings are frozen (non-trainable) in both the SimTier and MAKE approaches。而pretrained DIN network既可以冻结起来,也可以进行微调(以一个较小的学习率)。
1.5 Online Deployment 的工业设计
在工业环境中,
new items(包括广告)不断被创建。为了保持对这些new items的预测准确性,推荐模型实时获取new items的multimodal representations至关重要。这要求能够持续为new items生成multimodal representations,并由near-line trainer和online server实时利用。我们online system的示意概览如Figure 4所示。为实现multimodal representations的real-time generation,当new items被引入时,系统自动向pre-trained multimodal encoders发起请求,以计算这些new items的multimodal representations。一旦inference完成,这些representations被发送到multimodal index table。在此步骤之后,下游training system和inference servers能够从index table检索multimodal representations,促进near-line training和real-time online prediction能力。该过程确保极低延迟——从item’s introduction到utilization of its multimodal representation by the model仅需几秒钟。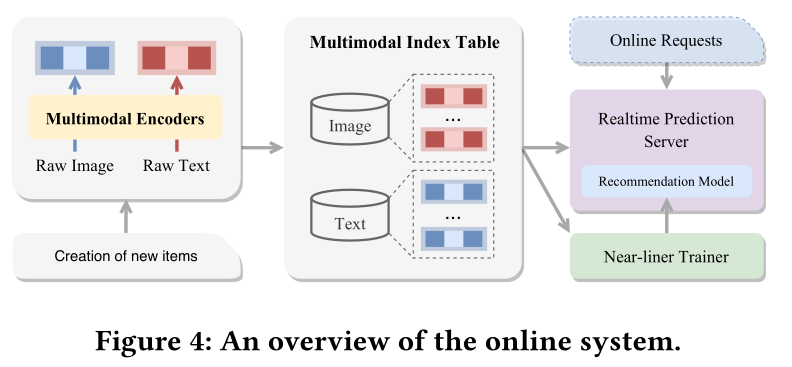
1.6 实验
在本节中,我们深入进行一个案例研究,考察将
image representations集成到CTR prediction模型中,旨在提供全面分析。值得注意的是,我们的方法是通用的,能够容纳多种模态类型(如文本和视频),并适用于推荐系统中的不同阶段。数据集:我们首先详述用于
pre-training阶段和下游integration阶段的数据集。Pre-training Dataset:在pre-training dataset中,每个样本由一个Query(用户的image query)和一个Positive(image of the purchased item)组成。为了进一步提高性能,我们还添加了一个hard Negative(image of the clicked item triggered by the positive item)。pre-training dataset的一个案例见Figure 5。CTR Prediction Dataset。CTR prediction dataset来自Taobao display advertising system,使用一周的impression logs。
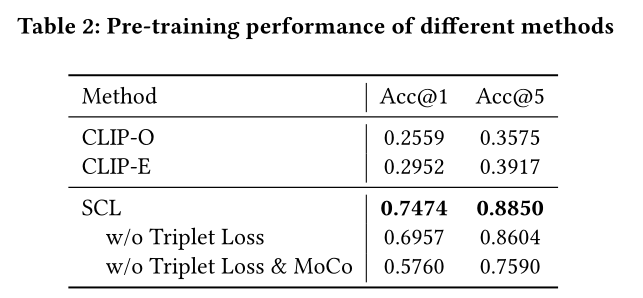
Compared Pre-training Methods:我们采用一系列广泛使用的pre-training方法进行比较。CLIP-O:CLIP-O指使用通用数据集预训练好的CLIP visual encoder(CLIP-ViT-B/16)(《Learning Transferable Visual Models From Natural Language Supervision》)。CLIP-E:CLIP-E是基于CLIP-O模型在电子商务场景中使用aligned item descriptions and item images微调后的版本。SCL:所提出的semantic-aware pre-training方法。SCL方法采用Momentum Contrast: MoCo来扩展negative samples。此外,SCL对每个<Query, Positive, Negative>三元组应用triplet loss(《FaceNet: A unified embedding for face recognition and clustering》),以有效区分hard negatives。
Compared Recommendation Methods:我们采用一系列广泛使用的integration方法进行比较。ID-based Model (production baseline):baseline是支撑我们在线系统的ID-based model。Vector:Vector方法利用pre-trained multimodal representations作为每个item的side-information,并将其与模型内其他ID embeddings拼接起来。SimScore:相似性分数(Similarity Score: SimScore)可视为Vector方法的简化版本。每个historical interacted item相对于target item的semantic similarity score被用作side information。SimTier和MAKE:所提出的SimTier和MAKE方法。
评估指标:我们评估所提出方法的
pre-training性能和CTR prediction性能。评估
Pre-training方法:在我们的大量实验中,我们发现Top-N accuracy: Acc@N与下游推荐模型的性能高度相关。具体而言,Acc@N指标衡量representation识别semantic similar items的能力:其中:
query和正样本。multimodal representations为每个query检索top-N results个结果。符号
1,其他所有情况为0。
评估
Recommendation方法:我们使用AUC和Group AUC: GAUC指标评估CTR prediction模型的有效性,其中更高的AUC/GAUC值表示更优的排序能力。
1.6.1 在 Pre-Training Dataset 上的性能
利用
Accuracy来评估Pre-trained Representations有效性的理由:衡量pre-trained representations有效性最精确的方式,是测量集成multimodal representations后推荐准确率的提升。然而,这一评估过程对于pre-training方法的迭代可能耗时较长,因此需要一种用于更快评估pre-trained multimodal representations的中间指标。在我们的研究中,我们观察到
pre-training accuracy的提升与recommendation performance的提升之间存在强相关性。我们在Figure 6(a)中展示这种关系,可以看到Acc@1的提升与GAUC的提升一致。因此,我们主要依赖pre-training accuracy来判断multimodal representations的质量。探索用于评估pre-trained multimodal representations的其他潜在中间指标仍然是一个有趣的未来工作主题。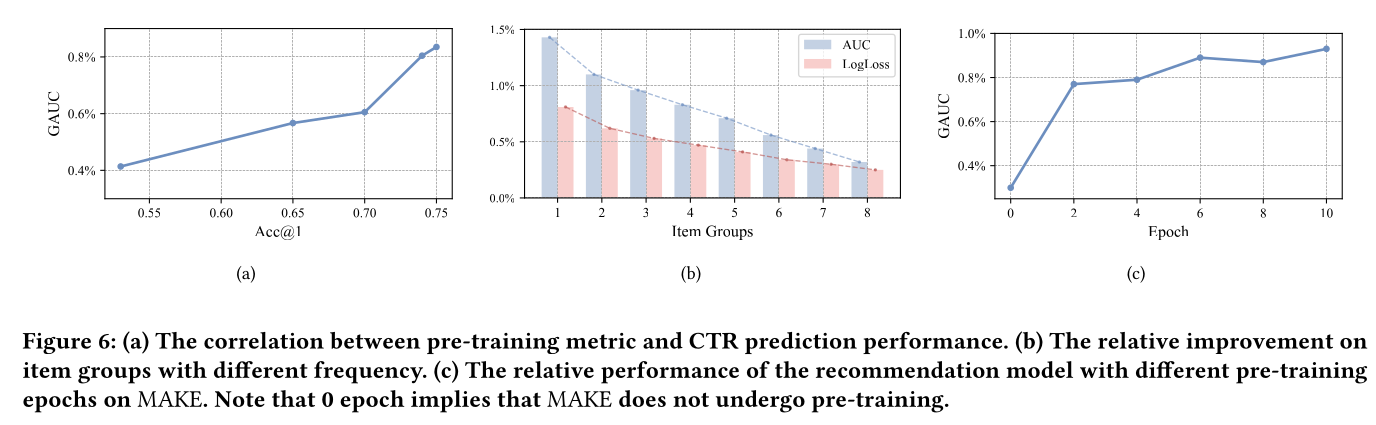
Semantic-Aware Contrastive Learning的重要性:为研究不同pre-training tasks如何影响multimodal representations的质量,我们进行了一系列实验。Table 2中的结果提供了两个重要观察。首先,提出的
SCL pre-training方法超越了其他语义相似度无关(semantic-similarity-agnostic)的方法,强调了semantic-aware learning的必要性。其次,纳入
Momentum Contrast: MoCo(《Momentum Contrast for Unsupervised Visual Representation Learning》)和Triplet Loss(《FaceNet: A unified embedding for face recognition and clustering》)等技术进一步提升了multimodal representations的质量,表明negative sample的选择极大影响性能。`
1.6.2 在 CTR prediction Dataset 上的性能
不同
Integration策略的性能:在CTR prediction数据集上,我们评估提出的SimTier和MAKE与其他方法。整体结果如Table 3所示,从中可以注意到两个观察。首先,
SimTier和MAKE显著优于其他方法。其次,
SimTier和MAKE的组合可以进一步提升性能,与ID-based model相比,GAUC提升1.25%,AUC提升0.75%。
上述结果证明了所提出方法在将
multimodal representations集成到ID-based model中的有效性。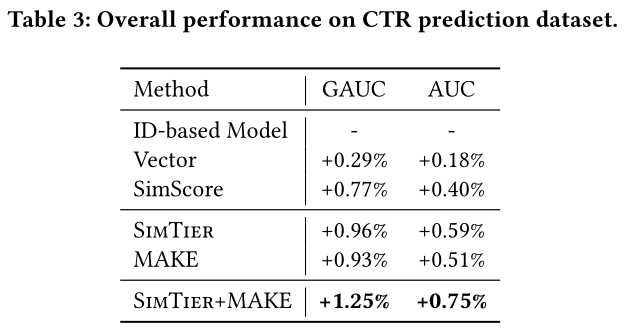
不同
Training Epochs of MAKE的性能:为探索MAKE的multi-epoch pre-training对最终推荐性能的影响,我们进行实验,其中MAKE在集成到推荐模型之前被预训练不同epochs。结果如Figure 6(c)所示。注意,0 epochs意味着MAKE不进行预训练,而是与下游任务联合优化。结果表明,随着MAKE的pre-training epochs数量增加,最终推荐模型的性能也提升。这表明MAKE的multi-epoch training有效增强了模型性能。Infrequent Items的性能:为考察multimodal representations在long-tail items上的泛化能力,我们评估按item出现频率分组后的相对提升。我们将所有items分为八组,Group 1包含训练数据集中频率最低的items,Group 8包含频率最高的items。之后,我们为每组计算AUC的相对提升:其中:
MM表示SimTier和MAKE方法的组合,ID表示ID-based production baseline model。我们还计算
LogLoss的相对提升以衡量校准能力:Figure 6(b)中呈现的结果表明,multimodal representations在所有组中均表现出显著提升,证明了我们的模型在不同类型items上的有效性。同时,我们看到低频items的提升更显著。结果表明,multimodal representations可以解决基于ID-based model在long-tail items上的缺陷,并提升prediction准确性。
1.6.3 在线性能
自
2023年中期以来,multimodal representations已集成到Taobao display advertising system中的pre-ranking models、ranking models和re-ranking models中,带来了显著性能提升。例如,在CTR prediction模型中纳入image representations,整体CTR提升3.5%,RPM提升1.5%,ROI提升2.9%。值得注意的是,对于新广告(过去
24小时内创建),影响更为显著,CTR提升6.9%,RPM提升3.7%,ROI提升7.7%。新广告上的显著收益也验证了multimodal data在缓解冷启动问题方面的有效性。
1.7 结论与讨论
Multimodal-based recommendation已经吸引了数十年的关注。然而,将multimodal representations集成到工业系统中提出了许多艰难挑战,特别是在representation quality、integration methods和system implementation领域——这些挑战在大规模工业系统背景下被放大。在本研究中,我们深入探讨这些挑战,并分享我们用于
pre-training和纳入multimodal representations的方法。此外,我们提供在online deployment过程中获得的见解。我们相信,我们在旅程中积累的策略和见解,将成为那些希望在工业系统中加速采用multimodal-based recommendations的人们的宝贵资源。