一、MUSE [2025]
《MUSE: A Simple Yet Effective Multimodal Search-Based Framework for Lifelong User Interest Modeling》
Lifelong user interest modeling对于工业推荐系统至关重要,然而现有方法主要依赖ID-based features,在long-tail items上泛化能力差,且semantic expressiveness有限。虽然最近的工作探索了在通用搜索单元(General Search Unit: GSU)中使用multimodal representations进行behavior retrieval,但它们通常忽视了fine-grained modeling阶段——即精确搜索单元(Exact Search Unit: ESU)中的multimodal integration。在这项工作中,我们对如何在两阶段lifelong modeling框架的两个阶段中有效利用multimodal signals进行了系统性分析。我们的关键洞察是:在
GSU中简单性(simplicity)就足够了:使用高质量multimodal embeddings的轻量级余弦相似度优于复杂的retrieval机制。相比之下,
ESU需要更丰富的multimodal sequence modeling和有效的ID–multimodal fusion以释放ESU的全部潜力。
在这些原则的指导下,我们提出了
MUSE,一个简单而有效的multimodal search-based的框架。MUSE已部署在Taobao display advertising system中,实现了100K-length user behavior sequence modeling,并在online latency开销可忽略的情况下,在top-line metrics上带来了显著提升。为了促进社区研究,我们分享了工业部署实践,并开源了第一个大规模数据集,该数据集包含ultra-long behavior sequences,同时搭配了高质量的multimodal embeddings。我们的代码和数据可在https://taobao-mm.github.io获取。点击率预测(
Click-Through Rate: CTR prediction)在工业推荐系统中扮演着关键角色。随着user behavior logs随时间累积——通常每个用户超过behaviors——它们包含了丰富的、不断演变的interest patterns。为了利用这些lifelong sequences,现代CTR prediction models采用两阶段架构(《TWIN: TWo-Stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》、《Search-Based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction》):(1):通用搜索单元(General Search Unit: GSU)从full historical behaviors中检索一个简短的且相关的子序列。(2):精确搜索单元(Exact Search Unit: ESU)对该子序列进行精细的user interest modeling以进行final prediction。
然而,现有方法在两个阶段中几乎完全依赖于
ID-based features(《TWIN: TWo-Stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》、《Search-Based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction》)。这导致了两个关键限制:(1):long-tail items或过时items的ID embeddings的学习效果不佳,降低了GSU的retrieval质量。(2):ESU缺乏semantic expressiveness,因为它无法泛化到co-occurrence signals之外。虽然最近的工作(例如,MISS《MISS: Multi-Modal Tree Indexing and Searching with Lifelong Sequential Behavior for Retrieval Recommendation》)将multimodal representations引入GSU,但其在ESU中仍然仅对ID features进行建模,留下了第二个限制未得到解决。
在这项工作中,我们系统地研究了如何充分利用多
multimodal information来增强lifelong user interest modeling,重点关注将multimodal representations同时整合到GSU和ESU中。通过在工业规模数据上的大量实验,我们得出了三个关键见解:在
GSU阶段,multimodal embeddings之间的简单余弦相似度足以进行有效的retrieval。更复杂的相似度评分机制(例如,attention或joint ID–multimodal fusion)带来的提升可以忽略不计。在
ESU阶段,显式的multimodal sequence modeling(例如,通过SimTier《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》)显著提升了性能,而通过将multimodal semantics融合到ID-based attention中(通过我们提出的SA-TA)则获得了进一步的提升。Representation quality在ESU中比在GSU中更重要,通过multimodal embeddings(例如,SCL《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》)产生了最强的结果,其中multimodal embeddings能够捕获细粒度item semantics。
在这些见解的指导下,我们提出了
MUSE(MUltimodal SEarch- based framework for lifelong user interest modeling)——一个简单而有效的范式,将我们的发现统一到一个可部署的系统中(见Figure 1)。具体来说,MUSE在两个阶段都使用frozen SCL-based multimodal embeddings(《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》):(1):在GSU阶段,它通过轻量级的multimodal余弦相似度检索most top-K relevant behaviors。(2):在ESU阶段,它通过dual-path architecture design来融合ID和multimodal signals以进行lifelong user interest modeling:Semantic-Aware Target Attention: SA-TA用高质量的semantic guidance来增强ID-based attention。而
SimTier将multimodal cosine similarity sequence压缩为直方图以捕获semantic relevance。
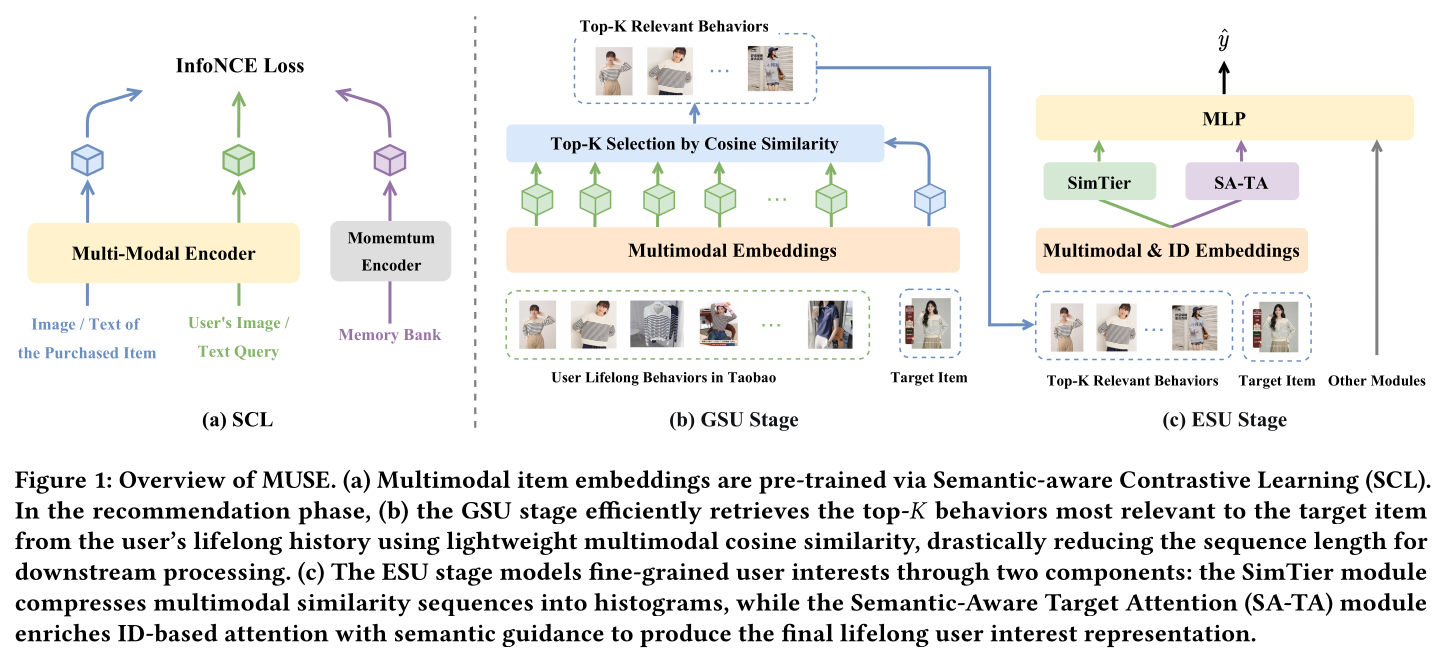
除了算法贡献之外,我们还做出了两个额外的实际贡献:
首先,我们分享了生产部署的经验。自
2025年年中起,MUSE已部署在Taobao display advertising system中。它被集成到online serving pipeline中,在高效处理长达100K-length的lifelong user behavior sequences的同时,带来了可忽略的延迟开销,并实现了显著的top-line metrics提升。其次,为了促进社区研究,我们开源了第一个大规模公共数据集,该数据集包含来自
Taobao displaying advertising system真实用户流量的lifelong user behavior sequences,搭配以高质量的multimodal embeddings。
总之,我们的贡献是:
我们首次对
lifelong user interest modeling中的multimodal integration进行了系统性分析,揭示了GSU(simplicity)和ESU(richness + fusion)的不同设计原则。我们提出了
MUSE,一个体现这些原则并在离线评估和在线评估中均达到SOTA性能的实用框架。我们发布了工业部署实践和一个大规模
multimodal lifelong behaviors数据集,以支持未来的研究。
1.1 相关工作
我们的工作涉及两个活跃的研究方向:
lifelong user interest modeling,multimodal recommendation。Lifelong User Interest Modeling:Modeling ultra-long user behavior sequences对于捕获不断演变的兴趣至关重要。早期方法如MIMN(《Practice on Long Sequential User Behavior Modeling for Click-Through Rate Prediction》)使用memory networks维护user interest states over time。一个重大突破来自于SIM(《Search-Based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction》)和UBR4CTR(《User Behavior Retrieval for Click-Through Rate Prediction》)引入的两阶段框架,该框架将retrieval和modeling解耦:通用搜索单元(
General Search Unit: GSU)从full history中高效检索behaviors。精确搜索单元(
Exact Search Unit: ESU)对该子序列进行精细的sequence modeling以进行final prediction。
后续工作改进了
GSU设计:ETA(《End-to-end user behavior retrieval in click-through rateprediction model》)使用locality- sensitive hashing with Hamming distance进行快速检索。SDIM(《Sampling Is All You Need on Modeling Long-Term User Behaviors for CTR Prediction》)通过hash signatures对items进行分组。TWIN(《TWIN: TWo-Stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》)将Target Attention(《Deep Interest Network for Click-Through Rate Prediction》)扩展到GSU,选择具有最高attention scores的behaviors。然而,由于attention scores是针对behavior aggregation而优化,并非针对behavior selection而优化的,这使得它们对retrieval而言是次优的(《Long-Sequence Recommendation Models Need Decoupled Embeddings》)。
更根本的是,所有这些方法都仅依赖于
ID-based features,继承了众所周知的局限性:对long-tail items的泛化能力差、以及缺乏semantic expressiveness。这些缺点促使了最近的努力——包括我们的工作——将multimodal signals集成到lifelong modeling中。Multimodal Recommendation:多模态信息(例如,图像、文本)在提高推荐准确性方面显示出巨大潜力。AlignRec(《AlignRec: Aligning and Training in Multimodal Recommendations》)在collaborative filtering supervision下将fixed CLIP features与ID embeddings对齐。《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》提出了Semantic-aware Contrastive Learning: SCL,在pre-training期间构建behavior-grounded positive pairs(例如,search query <--> purchased item),然后使用这些fixed representations通过SimTier和MAKE来建模用户兴趣。QARM(《QARM: Quantitative Alignment Multi-Modal Recommendation at Kuaishou》)在pre-training期间将multimodal features与item-item relationships对齐,并通过quantized codes(《Autoregressive Image Generation Using Residual Quantization》、《Recommender systems with generative retrieval》)实现end-to-end optimization。与我们工作最相关的是,
MISS(《MISS: Multi-Modal Tree Indexing and Searching with Lifelong Sequential Behavior for Retrieval Recommendation》)通过引入a multimodal GSU alongside the ID-based GSU,开创了lifelong behavior modeling中的multimodal integration。然而,MISS在ESU中丢弃了multimodal signals,将semantic enrichment限制在GSU retrieval阶段,使得ESU stage容易受到ID embedding limitations的影响。相比之下,我们提出了在
GSU和ESU两个阶段系统性地集成multimodal information。我们的分析揭示了每个阶段不同的设计原则——simplicity在GSU中就足够了,而ESU则受益于显式的multimodal sequence modeling和ID–semantic fusion——从而形成了一个简单而高效的框架MUSE。
1.2 预备知识
本节介绍了全文使用的关键概念和符号,重点是关于用于
CTR prediction的lifelong user behavior sequences modeling以及我们框架中使用的multimodal representations。CTR Prediction with Lifelong Behavior Sequences:CTR prediction估计用户将要点击所展示target item的概率,通常被表述为一个二分类任务。在工业规模的推荐系统中,用户通常拥有ultra-long historical behavior sequences(例如,数百万次interactions)。给定一个用户behavior sequencestarget itemother features其中
click label。现代架构(例如,
SIM《Search-Based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction》和TWIN《TWIN: TWo-Stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》)通过两阶段框架设计来解决lifelong sequence的挑战:(1): 一个通用搜索单元(General Search Unit: GSU),它检索一个简短的且与target相关的子序列(2):一个精确搜索单元(Exact Search Unit: ESU),它在final CTR prediction。
我们的工作专注于用丰富的
multimodal information同时增强GSU和ESU两个阶段。Multimodal Item Representations:为了利用items的丰富的multimodal information(例如,item images and titles),我们考虑了三种pre-trained multimodal embedding方法,所有这些方法都将一个item映射到一个固定维度的向量。OpenCLIP(《Chinese CLIP: Contrastive Vision-Language Pretraining in Chinese》):一个开源的、适配中文的CLIP模型(《Learning Transferable Visual Models From Natural Language Supervision》),通过contrastive learning在200M image–text pairs上预训练好的。它提供了强大的、开箱即用的universal semantic embeddings,但缺乏user interaction signals。I2I (Item to Item):一个在源自Taobao’s user behavior logs的item co-occurrence patterns上训练好的对比模型(contrastive model)。Positive pairs由frequent item–item transitions组成,而negative pairs则通过MoCo(《Momentum Contrast for Unsupervised Visual Representation Learning》)采样。这种方法有效地将collaborative signals注入multimodal embeddings中。SCL (Semantic-aware Contrastive Learning):从用户search–purchase behavior(例如,query image <--> purchased item image)构建positive pairs。使用InfoNCE loss(《Representation learning with contrastive predictive coding》)进行训练,SCL学到能够同时捕获semantic signals和behavioral relevance的embeddings,并已被证明对CTR prediction有效。
所有三种方法都产生
frozen multimodal embeddings,在推理期间通过table lookup进行访问。
1.3 Simple in GSU, Sophisticated in ESU: Principles for Multimodal Lifelong Modeling
在本节中,我们研究如何充分利用
multimodal information来增强lifelong user interest modeling,系统性地专注于将multimodal representations同时整合到GSU和ESU这两个阶段。通过在工业规模数据上的大量实验,我们得出以下关键见解:GSU:Multimodal similarity优于ID-based retrieval,但复杂性带来的提升甚微——简单的内积就足够了。ESU:Multimodal sequence modeling有显著帮助,而ID–multimodal fusion则能带来进一步的提升。设计原则:
Simple GSU + enhanced ESU是最优的;ESU对representation quality远比GSU敏感。
1.3.1 Simple Multimodal Similarity Suffices for Effective GSU Retrieval
GSU的主要作用是从lifelong historical sequences中高效检索与target item最相关的user behaviors。我们分析两个关键的设计选择:(1):用于similarity computation的representation类型。(2):retrieval机制的复杂性。
Multimodal-based GSU vs. ID-based GSU:我们将ID-based GSU与使用multimodal representations(即OpenCLIP、I2I和SCL)的变体进行比较。具体来说,我们使用各自的embedding类型来计算target item与每个historical behavior之间的余弦相似度,并检索top-K most similar behaviors作为GSU的输出。如
Table 1所示,GSUs based on multimodal representations持续优于ID-based baseline,这表明来自multimodal embeddings的semantic signals比discrete IDs能更好地捕获user–item relevance。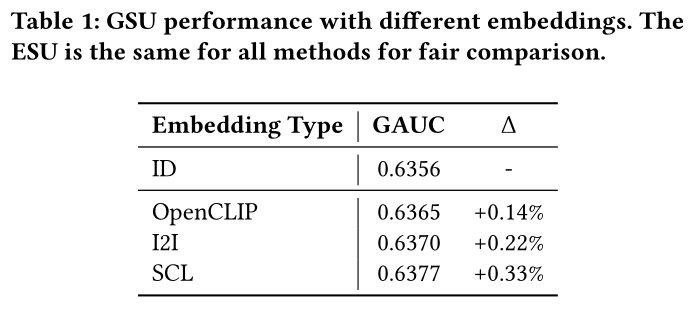
GSU中增加建模复杂度是否能提升性能?我们探索了两种增强策略:(1):在计算相似度之前,应用一个可学习的MLP来转换multimodal embeddings(称为multimodal attention score)。(2):通过fusing ID-based scores(称为ID Cosine或ID attention score)和multimodal semantic similarities进行联合检索。
结果总结在
Table 2中。对于
(1),我们发现attention机制——尽管对ID-based features有效——并不能直接迁移到multimodal similarity modeling,并导致性能明显下降。对于
(2),简单的fusion方法(同时在ID space和multimodal space计算并求和normalized cosine similarities)带来的提升很小。即使使用learnable fusion weights来结合ID-based attention scores和multimodal similarities,该方法也仅能达到与最简单的multimodal inner-product baseline相当的性能,同时伴随着更高的计算开销。
这些发现使我们得出结论:当拥有合适的
multimodal representations时,增加retrieval机制的复杂性并不一定能带来性能提升。相反,轻量级的inner-product similarity就足以实现有效的GSU retrieval。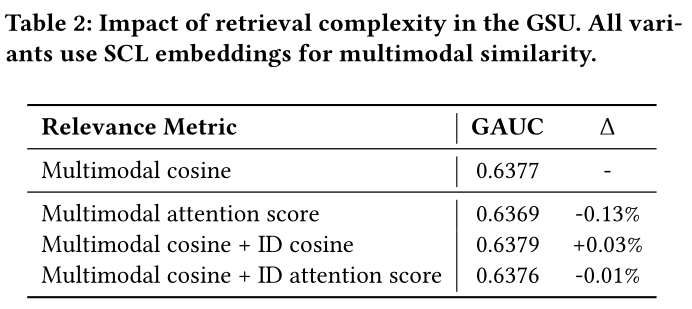
1.3.2 Multimodal Representations Significantly Enhance the ESU
虽然先前的工作已经探索了使用
multimodal representations来改进GSU,但大多数方法在ESU中仍然仅依赖ID-based representations——通常通过Target Attention来聚合historical behaviors——而忽视了multimodal signals在细粒度sequence modeling中的潜力。在这项工作中,我们研究两个关键问题:(1):multimodal representations能否提升ESU性能?(2):在ESU中增加建模复杂度(例如,通过multimodal–ID fusion)是否能带来额外收益,还是说简单的设计就足够了——正如在GSU中观察到的那样?
为了解决这些问题,我们分析两个关键的
design choices:(1):将仅ID-only ESU替换为multimodal-only ESU。(2):在ESU中进一步融合multimodal and ID representations,类似于在GSU中探索的joint retrieval策略。
Multimodal-based ESU vs. ID-based ESU:对于ESU中的multimodal sequence modeling,我们采用SimTier(《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》)作为代表性架构。如Table 3所示,我们评估了SimTier和标准的ID-based Target Attention模块各自、以及组合的效果。结果表明,SimTier无论是单独使用还是与Target Attention结合使用时,都带来了显著的性能提升,突出了在ESU中显式建模multimodal semantics的巨大好处。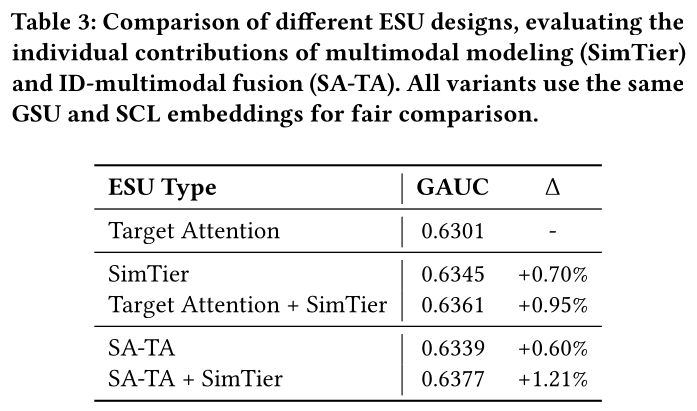
Fusing multimodal and ID representations能带来进一步的提升。我们探索了在ESU中融合multimodal representation和ID representation,类似于在GSU中研究的joint retrieval策略。具体来说,我们将ID-based attention scores与multimodal semantic similarity整合到Target Attention机制中,以产生统一的、语义感知的attention权重。我们将这种增强方法称为Semantic-Aware Target Attention: SA-TA,详细内容见1.4.3节。如
Table 3所示,我们提出的SA-TA在ESU中始终优于原始的ID-only Target Attention,表明multimodal and ID representations提供了互补信号,可以有效地被融合从而增强fine-grained modeling of lifelong user interests。
1.3.3 Multimodal Representation Quality Matters—Especially in the ESU
能够捕获细粒度
item semantics的高质量representations能带来更好的性能。如Table 1所示,模型性能遵循SCL > I2I > OpenCLIP的排序。这是因为SCL embeddings捕获了更细粒度的multimodal semantics(《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》),从而实现了更准确的GSU retrieval和更强的ESU modeling。我们通过附录A.1中的GSU案例研究来可视化这些representations之间的差异。Representation quality对ESU的影响远大于对GSU的影响。如图Figure 2所示,我们通过在不同settings下评估不同的multimodal representations来量化这种效应:(1):在GSU中替换representation,同时在ESU中保持为SCL representation(GSU ONLY);(2):在GSU和ESU中同时替换representation(GSU和ESU)。
当仅改变
GSU representation时,性能保持相对稳定。相比之下,在ESU中改变representation会导致显著的性能差异,其中fine-grained SCL representaions带来了明显的提升。这表明ESU对multimodal representation quality的敏感性远高于GSU,强调了semantic modeling在ESU中的重要性。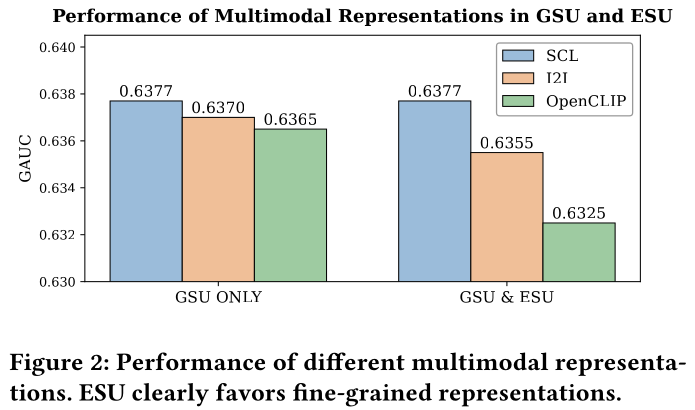
1.4 MUSE: A Simple Yet Effective Multimodal Lifelong Modeling Framework
在
1.3节洞察的指导下,我们提出了MUSE(MUltimodal SEarch-based framework for lifelong user interest modeling),它遵循三个关键原则:(1):利用高质量的SCL representations。(2):采用简单的、基于相似度的GSU。(3):设计一个multimodal-enhanced ESU,既执行显式的multimodal sequence modeling,又执行有效的ID–multimodal fusion。
这种设计在效率和建模能力之间取得了有效的平衡。概览见
Figure 1。
1.4.1 Choice of Multimodal Representations
如
1.3节所示,representation quality对性能影响至关重要——尤其是在ESU中。在候选方法(OpenCLIP、I2I、SCL)中,SCL因其细粒度的语义感知能力(semantic awareness)而产生了最强的结果。因此,MUSE在GSU retrieval和ESU modeling中都采用SCL embeddings。
1.4.2 Multimodal-Based GSU
与我们的发现 “简单的
inner-product similarity在GSU中就足够“ 的结论一致,MUSE使用frozen SCL embeddings,通过余弦相似度计算semantic relevance。具体来说,给定一个
target itemlifelong historical behavior sequenceslookup将每个item映射到其pre-trained multimodal embedding,得到GSU计算target item与每个behavior item之间的相似度:然后,我们选择具有最高
top-K behaviors来形成子序列retrieval与我们的洞察一致,即当拥有高质量的multimodal embeddings时,复杂的机制不会带来收益。
1.4.3 Multimodal-Enhanced ESU
与
GSU相反,我们的分析表明,ESU需要显式的multimodal sequence modeling以及有效的fusion of ID and semantic signals,以充分利用lifelong behavior数据。为此,MUSE的ESU由两个互补组件组成:(1):一个multimodal sequence modeling模块(SimTier),它捕获retrieved behavior sequence中的细粒度semantic relevance patterns。(2):一个multimodal semantic-aware ID attention模块(SA-TA),它用multimodal semantic guidance增强传统的ID-based attention。
通过
SimTier进行显式Multimodal Sequence Modeling:SimTier(《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》)不是处理原始的multimodal embeddings,而是操作target item与GSU-retrieved behaviorssemantic similarity sequenceESU受益于modeling the structure of semantic relevance,而不是individual embeddings。具体来说,
similarity rangebins)。SimTier将similarity sequencesentry统计有多少个similarity scores落入相应的bin。这个直方图作为user’s multimodal interest distribution的紧凑而富有表现力的representation:这种方法构成了我们显式的
multimodal sequence modeling——它将multi-level semantic patterns(例如,有多少behaviors是highly/weakly relevant的)捕获在一个单一向量中。它捕获了
target item与user history interest的多模态相似性。Semantic-Aware Fusion in ID-Based Attention (SA-TA):虽然SimTier有效地捕获了multimodal semantics,但ID path对于捕获collaborative filtering signals仍然是必不可少的。然而,如1.3节所述,ID-only attention在lifelong user behaviors中的long-tail items上存在泛化能力差的问题。为了解决这个问题,我们提出了如
Figure 3所示的语义感知目标注意力(Semantic-Aware Target Attention: SA-TA),它将ID-based attention scores与multimodal semantic similarity signals融合。给定ID embeddingstarget)和behaviors),标准的Target Attention(《Deep Interest Network for Click-Through Rate Prediction》)计算如下:SA-TA使用multimodal similarity vectorfused attention scores:其中:
final ID-based lifelong user interest representation通过以下方式获得:这种设计实现了我们的洞察,即
ID和multimodal signals是互补的——SA-TA使用multimodal semantic similarity来增强ID attention,特别是对于sparse items。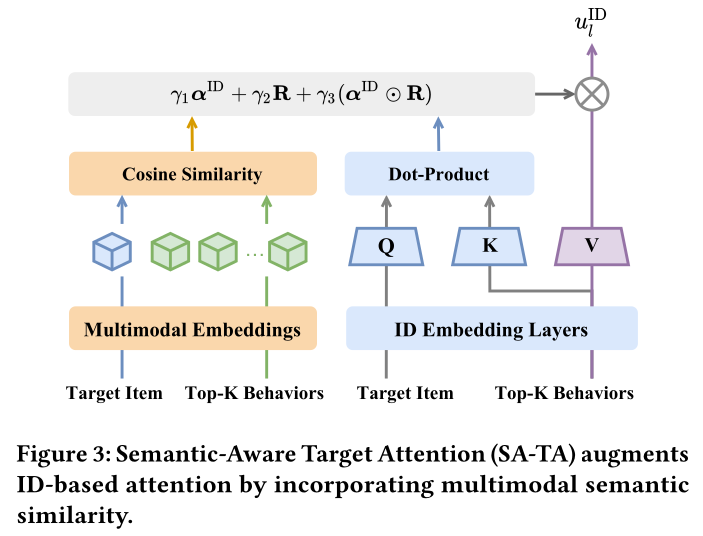
最后,完整的
lifelong user interest representation通过拼接两个paths形成:prediction tower中进行CTR prediction。总之,
MUSE的ESU直接实现了第1.3节的两个关键发现:(1):显式的multimodal sequence modeling显著优于ID-only baselines。(2):在attention中fusing ID and multimodal signals从而实现进一步的提升。
1.5 System Deployment
工业规模的推荐系统必须在严格的
latency预算内(通常是几百毫秒)从数十亿的items的corpora中返回个性化结果。为了满足这一约束,production systems通常采用多阶段pipeline:一个
candidate generation(matching)阶段,检索一个可控规模的集合(大约items)。随后是一个计算密集型的
ranking阶段,对candidates应用精细建模。
在
Taobao display advertising system中,我们将MUSE部署在ranking阶段,以有效地建模长达100K interactions的lifelong user behavior sequences。主要的性能瓶颈来自于获取这些long behavior sequences、以及它们在GSU中的embeddings所需的大量网络通信,这可能导致系统超出其latency budget。请注意,这个瓶颈与candidate items无关,因为一旦request到达,用户就是固定的。为了消除这个瓶颈,我们将GSU feature/embedding fetching从关键的ranking path中解耦出来,使其与matching stage异步并行执行,并将embeddings缓存在GPU内存中。在ranking stage,我们执行similarity computation、Top-K Selection和ESU modeling:Pre-fetching of GSU:与matching并行,GSU server从remote storage中检索user behavior sequence和multimodal embeddings,并将它们缓存在GPU memory中。Pre-fetching通常比matching完成得更快,因此其latency被完全隐藏。Top-K Selection of GSU:在ranking期间,模型使用cached embeddings来计算相似度,并选择与target最相关的top-K historical interactions,以馈入到ESU中。请注意,similarity computation和top-K selection可以与ranking阶段的其他feature-processing操作并行执行,产生的latency可以忽略不计。ESU modeling:在selected top-K sub-sequence基础上,ranking模型在ESU内应用SimTier和SA-TA,并产生最终的CTR prediction。
通过上述异步设计,
MUSE在production环境中带来的增量latency可以忽略不计。其高效的两阶段设计将资源消耗控制在预算之内。自2025年年中部署以来,MUSE已处理了大部分流量,提供了稳定的性能和显著的提升。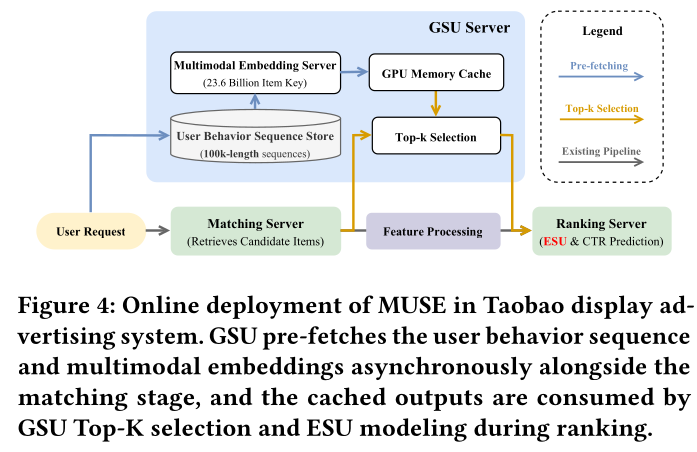
1.6 Dataset Construction
MUSE框架针对工业规模的推荐场景,这些场景需要通过ultra-long behavior sequences和丰富的multimodal item content来建模lifelong user interests。这种能力对于Taobao display advertising platform这样的真实世界系统至关重要。然而,现有的公共推荐数据集(
《KuaiRec: A Fully-observed Dataset and Insights for Evaluating Recommender Systems》、《A Content-Driven Micro-Video Recommendation Dataset at Scale》、《Tenrec: A large-scale multipurpose benchmark dataset for recommender systems》)通常要么缺乏long user behavior sequences,要么缺乏全面的multimodal features。为了全面评估和展示MUSE的有效性,我们在两个自建数据集上进行实验,这两个数据集均源自Taobao display advertising system,都具有long user behavior sequences和multimodal item representations。第一个是我们的
production dataset,完全反映真实世界的流量,并用于在工业环境中验证MUSE的性能。第二个是精心策划的
academic dataset,为研究目的进行了仔细采样和匿名化处理。值得注意的是,我们将开源这个高质量的数据集,以促进社区对multimodal recommendation和lifelong user interest modeling的研究。
1.6.1 Industrial Production Dataset
industrial dataset由Taobao display advertising system中的impression logs构建。对于我们的实验,我们使用一周的数据:前六天用于训练,最后一天用于测试。该数据集中的每个样本都包含数百个精心设计的特征。如Table 4总结,该数据集包含来自0.19B用户的3.71B样本,每个用户拥有100K historical behavoirs。该数据集能够对像MUSE这样的lifelong modeling方法进行严格的离线评估。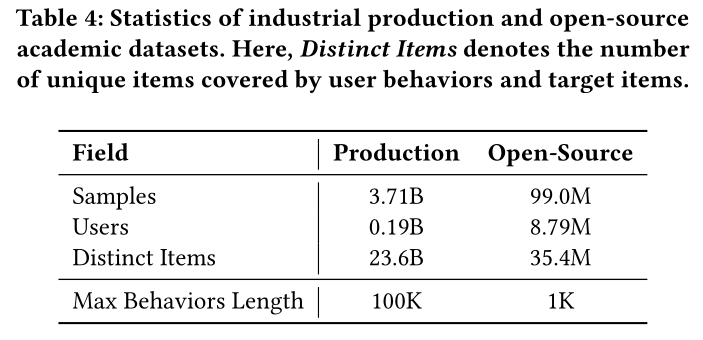
1.6.2 Open-Source Academic Dataset
为了促进可重复的研究,我们发布了一个保护隐私的开源
academic dataset。它包括一组简洁的关键特征和长达数千次interactions的user behavior sequences。由于product images and titles的版权限制,我们不提供原始的multimodal content。相反,我们为所有items提供SCL-based multimodal embeddings(《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》)——如第1.3节所验证,这些高质量representations能够捕获semantic relevance和behavioral relevance。该数据集包含以下组成部分:
User features:匿名化的user ID, age, gender, city, and province。Item features:item ID, category, item city, and province。Behavior sequences:用户的historical sequence最多包含1K behaviors,每个behavior由其item ID标识。每个item仅由一个128维的SCL embedding来表征。Label:一个指示click (1) or non-click (0)的二元标签。
如
Table 4所示,开源数据集包含来自8.86M用户的107M样本,覆盖了275M unique items。最大序列长度限制为1K,以在research utility和distribution feasibility之间取得平衡。我们相信,这个将
long user behavior sequences与high-quality multimodal embeddings相结合的数据集,将能够系统性地探索multimodal lifelong interest modeling。该数据集以及preprocessing scripts和baseline implementations现已公开可用(https://huggingface.co/datasets/TaoBao-MM/Taobao-MM、https://github.com/TaoBao-MM/MUSE)。
1.7 实验
我们进行了全面的实验,以在
CTR prediction的背景下评估MUSE。Baselines:我们将MUSE与以下SOTA且广泛采用的lifelong interest modeling方法进行比较:DIN(《Deep Interest Network for Click-Through Rate Prediction》):该方法引入了一种Target Attention机制,从historical behaviors中建模user interest,是short-sequence interest modeling中最广泛采用的模型。SIM-Hard(《Search-Based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction》):该方法采用两阶段方法进行long-sequence modeling。在
GSU阶段,它检索与target item具有相同category的top-K behaviors。在
ESU阶段,它应用DIN来建模用户的细粒度兴趣(fine-grained interest)。
SIM-Soft(《Search-Based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction》):该变体将SIM-hard GSU阶段中category-based retrieval替换为embedding-based similarity search,同时在ESU阶段仍使用DIN进行user fine-grained interest modeling。TWIN(《TWIN: TWo-Stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》):该方法提出了一种高效的Target Attention机制,同时适用于GSU阶段和ESU阶段,从而在GSU阶段就实现了attention-based retrieval。MISS(《MISS: Multi-Modal Tree Indexing and Searching with Lifelong Sequential Behavior for Retrieval Recommendation》):该方法采用了一种hybrid retrieval策略:一个ID-based Co-GSU和一个multimodal-based MM-GSU。在ESU阶段,它使用ID-based DIN进行user interest modeling。
实现细节:
为了公平比较,所有方法共享相同的网络架构,包括
embedding layers和upper MLP tower,除了long-term behavior modeling模块。所有方法都统一使用
SCL(《Enhancing Taobao Display Advertising with Multimodal Representations: Challenges, Approaches and Insights》)作为multimodal representation。每个模型训练一个
epoch(《Towards Understanding the Overfitting Phenomenon of Deep Click-Through Rate Models》、《RecIS: Sparse to Dense, A Unified Training Framework for Recommendation Models》)。对于
DIN,由于其processing long sequences的瓶颈,我们使用最近的50 behaviors。对于两阶段模型(SIM、TWIN、MISS、MUSE),GSU从lifelong behavior sequence中检索50 behaviors用于ESU。production dataset的full behavior sequence length上限为5,000,open-source dataset为1,000。我们严格按照原始论文复现了每种方法的
GSU。对于
SIM-soft和SIM-hard,我们采用与MUSE相同的ESU(SA-TA和SimTier)。考虑到TWIN使用了一种特殊的Target Attention变体以提高计算效率,我们保留了其原始设计,并将SimTier集成到TWIN的ESU中。对于MISS,我们保留其原始的ID-only ESU,以说明multimodal-enhanced ESU的显著效果。在
open-source dataset上,对于所有parameter groups我们使用Adam训练所有模型:embedding layers使用2.0e-3的学习率,而DNN parameters使用2.0e-4的学习率。batch size为8,000。
Evaluation Metrics:我们采用Group AUC: GAUC——一个已被证明与在线指标更一致的指标(《Joint Optimization of Ranking and Calibration with Contextualized Hybrid Model》、《One Model to Serve All: Star Topology Adaptive Recommender for Multi-Domain CTR Prediction》、《Deep Interest Network for Click-Through Rate Prediction》)。
1.7.1 整体性能
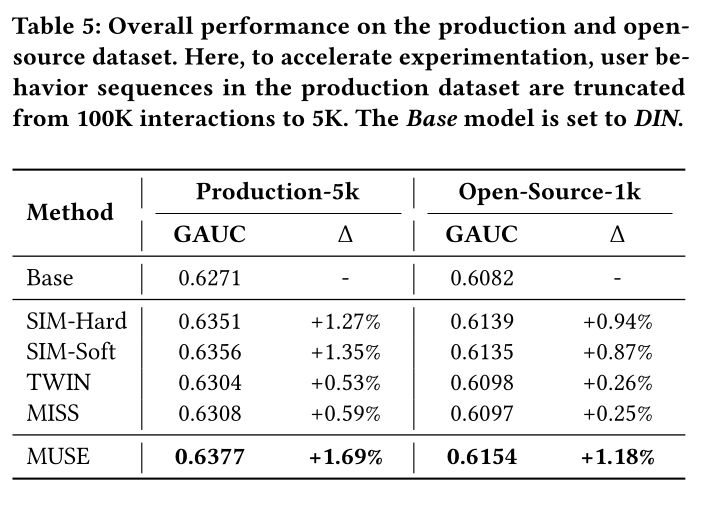
Table 5显示了所有模型在production dataset和open-source dataset上的性能,其中MUSE始终取得最佳结果。这些比较进一步验证了第1.3节中建立的见解,证实了我们方法的有效性。首先,
multimodal-based GSU优于ID-based GSU。当搭配以相同的ESU时,MUSE的性能优于ID-based similarity search的SIM-hard和SIM-soft。在这里,
SIM-Hard/SIM-Soft/TWIN使用与MUSE相同的ESU。其次,复杂的
GSU机制几乎不能带来任何改进。TWIN采用attention机制来建模target-behavior relevance,但性能有限,部分原因是ID embedding inner products的attention scores不可靠,特别是对于long-tail items。回想一下,在第1.3.1节中,我们还在GSU中使用了fused attention scores of SA-TA,引入了额外的计算开销,但并未优于MUSE的更简单的multimodal semantic similarity search。最后,
multimodal-enhanced ESU带来了显著的改进。尽管MISS引入了额外的multimodal GSU阶段,但它未在ESU阶段利用multimodal information,导致了次优的结果。
1.7.2 Behavior Sequence Length 的影响
我们评估了
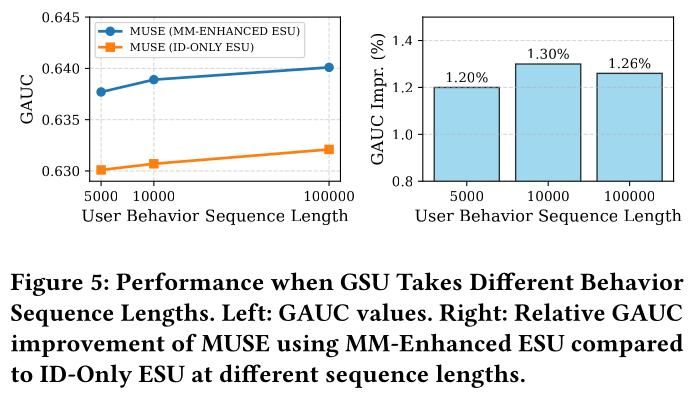
MUSE在不同behavior sequence length下的有效性。如Figure 5所示,我们观察到:(1):MUSE的性能随着序列长度的增加而显著提高,从5K behaviors扩展到100K behaviors带来了+0.38%的GAUC增益。(2):在所有长度下,multimodal-enhanced ESU始终大幅优于ID-only ESU。这与我们的洞察一致,即ESU受益于高质量的multimodal representations。
1.7.3 Different Users and Items 上的性能
为了评估
MUSE在不同user activity levels上的表现,我们按behavior sequence length将用户划分为九个大小相等的组。如Figure 6 (a)所示,relative GAUC improvement从Group 1(最短)到Group 9(最长)单调增加,证实了MUSE从丰富的behavioral context中获益最多。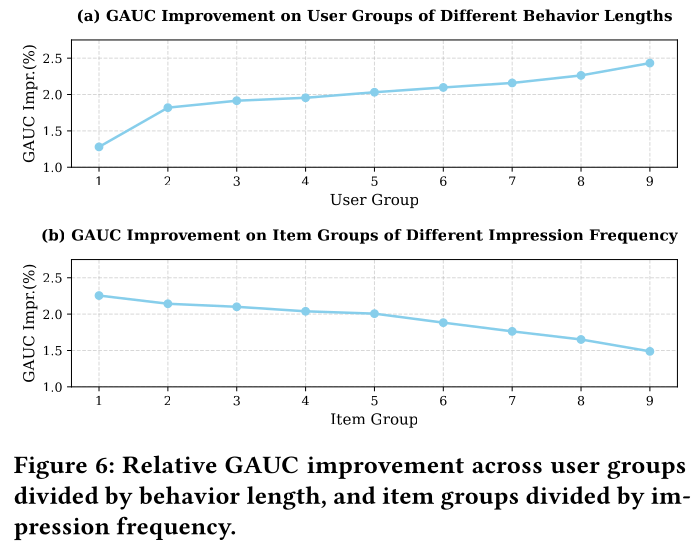
以类似的方式,我们将
items划分为九个大小相等的组,从Group 1(最不流行)到Group 9(最流行),并计算每组的relative GAUC improvement。如Figure 6 (b)所示,MUSE在冷门items上获得了更高的增益,展示了multimodal information的强大泛化能力。
1.7.4 Online A/B Test 结果
我们于
2025年年中在Taobao display advertising system中实现了MUSE(序列长度为100K),并通过长期的A/B test评估了其在线性能。production baseline是基于SIM with behavior length of 5K。如Table 6所示,部署MUSE with the 100K-length version带来了显著的性能提升,CTR提升了+12.6%,RPM(Revenue Per Mille)提升了+5.1%,ROI(Return On Investment)提升了+11.4%。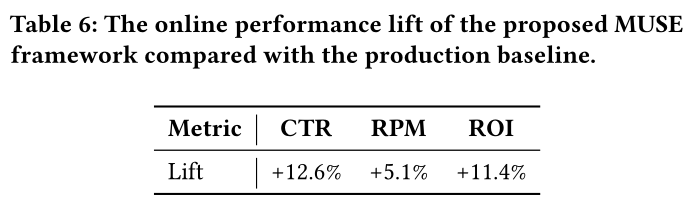
1.8 结论
在这项工作中,我们系统地研究了如何有效地将
multimodal representations集成到lifelong user interest modeling中。通过大量实验,我们揭示了两阶段架构的不同设计原则:通用搜索单元(
General Search Unit: GSU)受益于简单性(simplicity)——高质量的multimodal embeddings加上inner-product similarity就足够了。而精确搜索单元(
Exact Search Unit: ESU)则需要显式的multimodal sequence modeling以及effective fusion of ID and semantic signals。
在这些见解的指导下,我们提出了
MUSE,一个简单而有效的框架,在离线评估和在线评估中均达到了SOTA的性能。自2025年年中起,MUSE已部署在Taobao display advertising system中,以可忽略的延迟开销带来了显著的top-line business metrics提升。此外,我们发布了工业部署实践和第一个大规模开源数据集,该数据集包含ultra-long behavior sequences,搭配以SCL-based multimodal embeddings,以支持未来的研究。我们希望我们的分析、框架和资源能够激发学术界和工业界在multimodal-enhanced lifelong interest modeling方面产生更有效、更高效的方法。
1.9 A 附录
1.9.1 A.1 GSU 案例研究
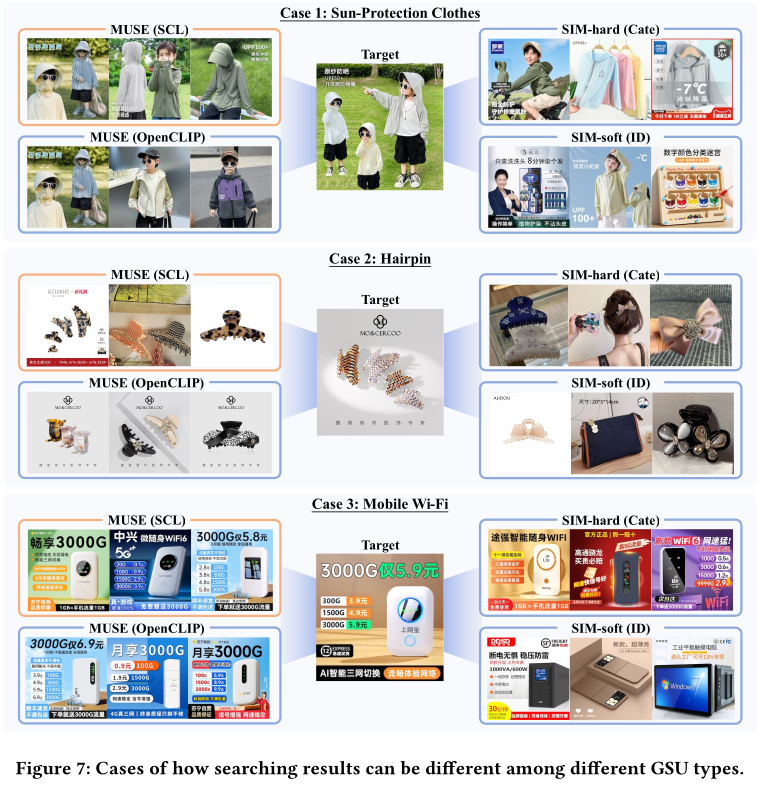
我们在
Figure 7中展示了三个案例,以说明不同GSU类型在diverse target items(即儿童防晒衣children’s sun-protection clothes、发夹hairpin和移动Wi-Fi)上的不同搜索结果:MUSE with SCL:multimodal GSU with SCL embeddings能够精确捕获区分individual items的视觉细节,展现出细粒度的semantic matching能力。它能准确地检索出在款式、形状、颜色、质地等方面与target item高度相似的historical items。MUSE with OpenCLIP:相比之下,GSU based on OpenCLIP embeddings以更粗糙的粒度进行搜索,关注整体的图像内容。它通常根据irrelevant background或contextual similarity而不是item本身来检索items。例如,在case 1中的儿童模特(child model),case 2中的商标(trademark),以及case 3中的文字"3000G"在检索过程中被过度强调。SIM-hard:category-based GSU能正确识别与target item属于同一category的items,但忽略了如颜色和款式等细粒度属性,而这些往往是用户最关心的方面。SIM-soft:ID-based GSU优先考虑在users’ interaction histories中与target item频繁共现的items,导致high popularity bias和low semantic relevance。例如,case 1中的儿童玩具(children’s toys)、case 2中的女性用品(women’s products)和case 3中的电子设备(electronic devices),被检索出来的主要原因都是与target item的co-occurrence,而不是与target item的semantic similarity。