一、Zenith [2026]
《Zenith: Scaling up Ranking Models for Billion-scale Livestreaming Recommendation》
准确地
capturing feature interactions在推荐系统中至关重要,近期趋势表明,scaling up模型容量可能是实现next-level predictive performance的关键驱动因素。尽管先前工作已经探索了各种模型架构来捕获多粒度的feature interactions,但相对较少的注意力被放在高效的feature handling、以及在不过度增加推理延迟的情况下扩展模型容量上。在本文中,我们通过提出Zenith来解决这一问题。Zenith是一种可扩展的且高效的ranking架构,能够以最小runtime overhead来学习复杂的feature interactions。Zenith被设计为使用Token Fusion模块和Token Boost模块处理少量且高维的Prime Tokens,由于其improved token heterogeneity,相比其他SOTA的ranking方法表现出更优的scaling laws。其现实世界有效性通过将该架构部署到TikTok Live得到证明,TikTok Live是一个领先的在线直播平台,吸引了全球数十亿用户。我们的A/B测试表明,Zenith在online CTR AUC and Logloss上达到+1.05% / -1.10%,并在Quality Watch Session / User上实现+9.93%的增益,在Quality Watch Duration / User上实现+8.11%的增益。推荐系统在现代在线平台中扮演着至关重要的角色,帮助用户发现相关内容、产品或服务。
feature interaction已被认为是推荐模型中的关键机制。近年来,深度学习已成为建模此类interactions的强大范式。通过学习hierarchical, non-linear representations of users, items, and other context information,深度神经网络可以捕获复杂的feature interactions和高阶的correlations。随着越来越大规模
user behavior datasets的可用性、以及大型语言模型中scaling laws所展示的有效性(《Scaling laws for neural language models》),近期研究也关注scaling recommendation models。一些工作致力于扩展sparse feature embeddings(《Persia: An open, hybrid system scaling deep learning-based recommenders up to 100 trillion parameters》、《High-performance, distributed training of large-scale deep learning recommendation models》),而另一些工作则专注于增强embedding之上的dense model components或sequence modeling layers(《Understanding scaling laws for recommendation models》、《Wukong: Towards a Scaling Law for Recommendation Models》)。尽管取得了这些进展,基于深度学习的推荐系统随着模型规模增加仍面临关键挑战。
首先,许多神经网络架构,例如
transformer,最初是为自然语言处理等任务设计的。虽然在其原生领域高效,但它们并未直接针对推荐场景的unique characteristics进行优化——特别是日益庞大且多样的sparse feature embeddings,这些embeddings需要仔细的token-level handling。Hiformer(《Hiformer: Heterogeneous feature interactions learning with transformers for recommender systems》)已表明,原始注意力机制对于ranking模型而言表达力不足,但还需要更多工作来获得进一步洞见。其次,大多数现有工作没有提供灵活的设计从而用于
scaling up。相反,它们只能scale up层数或内部隐藏单元(《Dcn v2: Improved deep & cross network and practical lessons for web-scale learning to rank systems》、《DHEN: A Deep and Hierarchical Ensemble Network for Large-Scale Click-Through Rate Prediction》、《Wukong: Towards a Scaling Law for Recommendation Models》)。这种暴力scaling方法通常导致收益递减,并使跨不同feature sets和frameworks的部署复杂化。论文中批评的暴力
scaling主要是 “增加层数” 或“增加 “hidden units”。这种做法通常预设了一个相对固定的输入结构和特征交互方式。一旦换一套
feature set:输入embedding维度、token数量、特征分组方式可能都要重新设计;原本调好的层宽、深度、学习率、正则化等超参可能全部失效。一旦切换不同的框架:从一个框架迁移到另一个框架时,可能需要重写或重新优化大量算子。
所以,这句话的本质是:
暴力
scaling让模型规模增长与特征集、框架实现深度耦合,导致每换一套特征或一个框架,都要重新做结构适配、超参调整和工程优化。而
Zenith试图通过Prime Token和模块化tokenwise设计,把这种耦合解开。
第三,现实世界大规模在线推荐系统需要同时处理数百万请求,同时将延迟保持在毫秒级,这使得传统模型难以在不产生过高计算成本的情况下保留复杂架构的收益。
为应对这些挑战,我们提出
Zenith(Optimized Efficient Neural Interaction with Tokenwise Handling),一种新颖的ranking模型架构,在不损害在线性能的情况下丰富模型表达力。Zenith背后的关键理性是将少量的、高维的feature tokens视为基本处理单元(fundamental processing units)。具体来说:我们的
starting embedding layer将input sparse features投影为separate embeddings,并将相同category内的feature embeddings(例如,user demographic features、user past interaction sequences)组合成更高维的Prime Tokens,与原始特征数量相比,token数量显著减少。为了处理这些
Prime Tokens,我们设计了两个专用组件:Token Fusion模块和Token Boost模块。Token Fusion模块通过建模input token之间的pairwise interactions来镜像a cross network。而
Token Boost模块独立地处理每个token,保留并refine其individual semantics。正如我们将在本文中展示的,独立处理每个Prime Token对于在interaction layers之间保持token heterogeneity以获得更好的scaling up潜力至关重要,同时显著减少计算开销。
Zenith相对于其他SOTA的ranking架构在各种模型规模下的优越性,通过我们在TikTok Live推荐平台上的离线和在线评估得到证明,该平台服务全球数十亿用户。总结来说,本文的主要贡献是:
我们提出
Zenith,一种新颖的ranking模型架构,具有Prime Token设计和tokenwise handling。我们提供了关于token heterogeneity在scaling up ranking models中重要性的洞见,并展示我们的设计如何细致地增强这一重要属性。我们分别介绍
Zenith中Token Fusion模块和Token Boost模块的两种有效设计。具体来说:我们为
Token Fusion提出Retokenized Self-Attention (RSA)和Tokenwise Multi-Head Self-Attention (TMHSA)。我们为
Token Boost提出Tokenwise SwiGLU (TSwiGLU)和Tokenwise Sparse Mixture of Experts (TSMoE)。
这些设计在模型参数和计算方面相对于
SOTA的ranking架构表现出更优的scaling laws。我们基于
TikTok Live推荐平台数十亿真实世界user interaction data提供了离线评估和在线A/B测试结果。与基线相比:所提出的新架构在离线
AUC/logloss上达到+1.05% / -1.10%。所提出的新架构在在线
A/B测试中在Quality Watch Session / User上达到+9.93%,在Quality Watch Duration / User上达到+8.11%。
这些结果充分展示了其在工业生产环境中的强大实际有效性。
整体思路类似于
TokenMixer,有一点值得关注:token heterogeneity在scaling up ranking models中很重要。Zenith可以理解为:参数化的TokenMixer,及
1.1 相关工作
Feature Interaction in Recommender Systems:推荐系统通常依赖丰富的、multi-domain的feature inputs。建模这些特征之间的interactions对于准确预测至关重要。在早期系统中,手工制作的
cross features通常用于显式捕获此类interactions(《Practical lessons from predicting clicks on ads at facebook》)。因子分解机(
Factorization Machines: FM)(《Factorization machines》)作为建模pairwise feature interactions的经典方法出现,尽管它们缺乏建模高阶关系的能力。随着深度神经网络(
DNN)的出现,研究人员观察到DNN可以隐式地建模高阶feature interactions。这启发了结合显式建模和隐式建模的混合方法。Deep&Wide(《Wide & deep learning for recommender systems》)将线性组件与DNN结合。而
DeepFM(《DeepFM: A factorization-machine based neural network for CTR prediction》)和DLRM(《Deep Learning Recommendation Model for Personalization and Recommendation Systems》)将FM集成到deep架构中。xDeepFM(《xdeepfm: Combining explicit and implicit feature interactions for recommender systems》)和DCN(《Deep & cross network for ad click predictions》、《Dcn v2: Improved deep & cross network and practical lessons for web-scale learning to rank systems》)等模型引入enhanced cross-networks来捕获高阶显式的interactions。
Attention-based Feature Interaction Architectures:随着attention机制在多个领域取得成功,attention-based的模型在feature interaction modeling中受到关注。AutoInt(《Autoint: Automatic feature interaction learning via self-attentive neural networks》)采用multi-head self-attention layers。而
InterHAt(《Interpretable click-through rate prediction through hierarchical attention》)和ACN(《Attentive capsule network for click-through rate and conversion rate prediction in online advertising》)等模型通过task-specific enhancements来扩展了这一设计。
通过将
input features转换为unified tokens,可以有效地应用attention layers(《Hiformer: Heterogeneous feature interactions learning with transformers for recommender systems》、《DHEN: A Deep and Hierarchical Ensemble Network for Large-Scale Click-Through Rate Prediction》、《Wukong: Towards a Scaling Law for Recommendation Models》)。然而,注意力机制最初是为自然语言设计的,其中tokens相对独立且语义清晰。相比之下,推荐系统中的feature tokens通常依赖上下文且语义纠缠(semantically entangled)。Hiformer(《Hiformer: Heterogeneous feature interactions learning with transformers for recommender systems》)通过引入heterogeneous attention layer来解决这一差距。然而,仍存在若干开放问题,例如减轻更深层中的
token homogeneity,以及实现tokens之间的显式信息交换。Scaling Laws in Ranking Models:来自大型语言模型(LLM)的findings表明,增加模型规模可显著提高性能(《Scaling laws for neural language models》)。这一趋势也在大规模ranking模型中观察到。Wukong(《Wukong: Towards a Scaling Law for Recommendation Models》)经验性地验证了scaling laws也适用于推荐模型。虽然
expanding embedding sizes和increasing hidden layer dimensions是直接的scaling方法,但DLRM(《Deep Learning Recommendation Model for Personalization and Recommendation Systems》)和DHEN(《DHEN: A Deep and Hierarchical Ensemble Network for Large-Scale Click-Through Rate Prediction》)等工作表明,在计算约束下堆叠diverse architectural modules也可以产生性能增益。专家混合(
MoE)框架(《Modeling task relationships in multi-task learning with multi-gate mixture-of-experts》)最初为multi-task learning而提出,已被证明在各个领域有效。MoE模型通过引入多个expert subnetworks来增加容量,其中只有a subset of experts在inference期间被激活。这种sparse activation策略,称为Sparse MoE(《Glam: Efficient scaling of language models with mixture-of-experts》、《Switch transformers: Scaling to trillion parameter models with simple and efficient sparsity》),允许在将模型扩展到数十亿参数的同时进行高效的训练和推理,使其成为scaling large ranking models的有前景技术(这些large ranking models需要严格的推理延迟)。
尽管有这些进展,仍缺乏对不同
scaling策略有效性的系统分析,特别是在结合modular stacking和MoE架构方面。虽然Wukong(《Wukong: Towards a Scaling Law for Recommendation Models》)在固定FLOPs或参数预算下探索了model depth和hidden dimension size的影响,但它主要关注简单scaling方法——例如增加层数或宽度——并未考虑更高级的组合,如不同token interaction策略和sparse activations based on MoE。Generative Recommenders:另一条工作线关注生成式推荐器(Generative Recommenders: GRs)。与传统推荐系统预测user–item interaction scores不同,GRs基于user behavior sequence直接生成future items。尽管近期有进展,GRs不太可能完全取代传统方法。在实践中,由于generative modeling过程,GRs在训练效率和推理延迟方面面临重大挑战(《A survey on generative recommendation: Data, model, and tasks》)。此外,传统推荐模型可以通过充当reward models来补充GRs从而指导generation(《Onerec: Unifying retrieve and rank with generative recommender and iterative preference alignment》)。因此,GRs代表一个并行研究方向,不在本文的研究范围之内。
1.2 方法
1.2.1 设计概览
如
Figure 1所示,我们提出的ranking模型架构Zenith(Optimized Efficient Neural Interaction with Tokenwise Handling)由一个tokenization layer和stacked neural network layers组成。tokenization layer同时处理sparse categorical features和dense features,将它们投影为一组紧凑的高维representations,我们称之为Prime Tokens。每个
neural network layer随后处理这些Prime Tokens,并包含两个核心组件:Token Fusion (TF)模块和Token Boost (TB)模块。
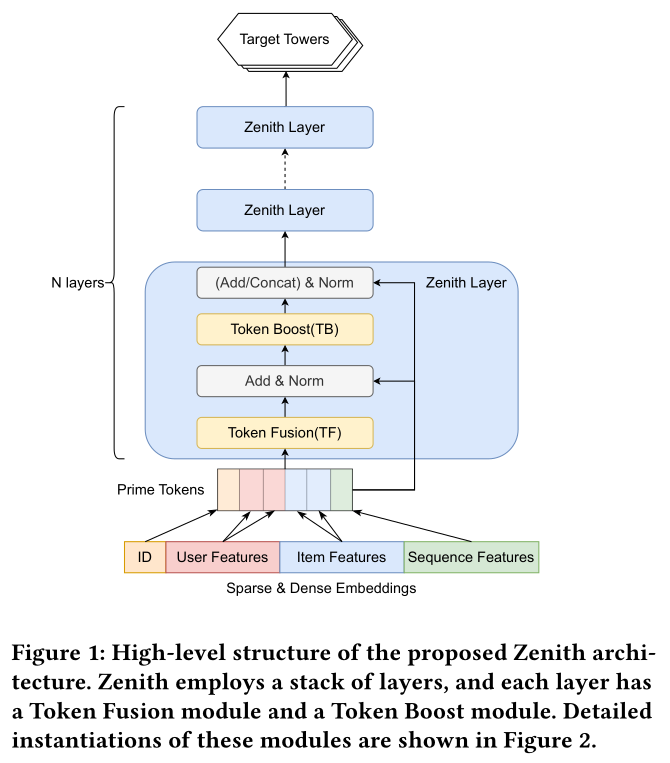
Token Fusion模块捕获feature interactions,其作用类似于传统feature crossing。然而,与因子分解机(Factorization Machines: FM)或Cross Networks等显式方法不同,Token Fusion网络专为处理Prime Tokens而定制。它执行显式的inter-token crossing和隐式的intra-token feature fusion,使模型能够在训练期间选择性地关注最相关的interactions。接下来,
Token Boost模块应用tokenwise transformations以增强token heterogeneity并提高整体模型表达力。如第1.3.2节详述,在scaling up model depth时,保持token heterogeneity至关重要。传统全连接前馈网络(fully connected feed-forward networks: FCFFN)随着层的加深而倾向于同质化token representations,但我们提出的Token Fusion模块通过鼓励每个token专注于distinct information来缓解这一点,从而在层间保持heterogeneity。在以下小节中:
我们将首先介绍
the prime tokenization of features,然后是Token Fusion模块和Token Boost模块。这些模块组件可以用各种架构选择来实例化,我们将为每个组件介绍两种有效设计,共同制定
Zenith和Zenith++版本的架构。虽然Zenith++在更大模型规模下提供更优的scalability和性能,但Zenith更易于实现且需要更少的超参数调优,同时也优于现有基线。我们还将讨论实践中使用的
additional training和inference optimizations。
1.2.2 Prime Tokenization of Features
先前工作(
《DHEN: A Deep and Hierarchical Ensemble Network for Large-Scale Click-Through Rate Prediction》、《Wukong: Towards a Scaling Law for Recommendation Models》)已证明feature tokenization的有效性。对于我们的直播推荐setting,我们发现少量更高维的Prime Tokens比using one or more tokens for each input feature效果更好。因此,在标准的feature bucketization and embedding lookups之后,feature embeddings使用多层感知机(MLP)被映射到a global token space。语义相似的特征(例如,
user demographic features)首先被拼接,然后被映射到单个prime token。只有重要的特征,如
user ID和sequence features,被映射到单独的token。sequence features以整个序列为单位整体映射成一个Prime Token。序列内部的所有event信息被编码聚合到该token中,而不是每个event单独成为一个Prime Token。注意,可以存在多个
sequences,例如click sequence、conversion sequence等等。
结果,
input features将映射为tokens,其中feature interactions不同,Token Fusion模块在训练期间自动学习过滤和聚合relevant token interactions。因此,与通常计算所有feature pairs的explicit interactions的传统模型相比,这种方法显著降低了资源消耗。此外,这使我们能够使用更复杂的tokenwise方法来增强对每个Prime Token的理解。我们的详细
tokenization策略如下:(1):ID features被分配单独的token。ID类型特征(例如,user ID、item ID)的embeddings对大多数interaction pairs至关重要,因此值得explicit token representation。(2):Tokens应保留完整feature embeddings。单个feature embedding不应被分割到多个tokens中。保持feature embeddings的完整性对于有效的token fusion至关重要。(3):Remaining tokens应基于语义分组,并保持信息负载平衡。对于non-ID特征,我们对embeddings进行分组,使每个token包含相似数量的语义相似的feature embeddings,确保tokens之间信息分布平衡。
1.2.3 Token Fusion
Token Fusion模块的功能类似于传统feature interaction机制,关键区别在于我们设计中的每个Prime Token可以聚合来自多个特征的信息。Figure 2a展示了Zenith中使用的Token Fusion设计,以及Zenith++中采用的增强版本。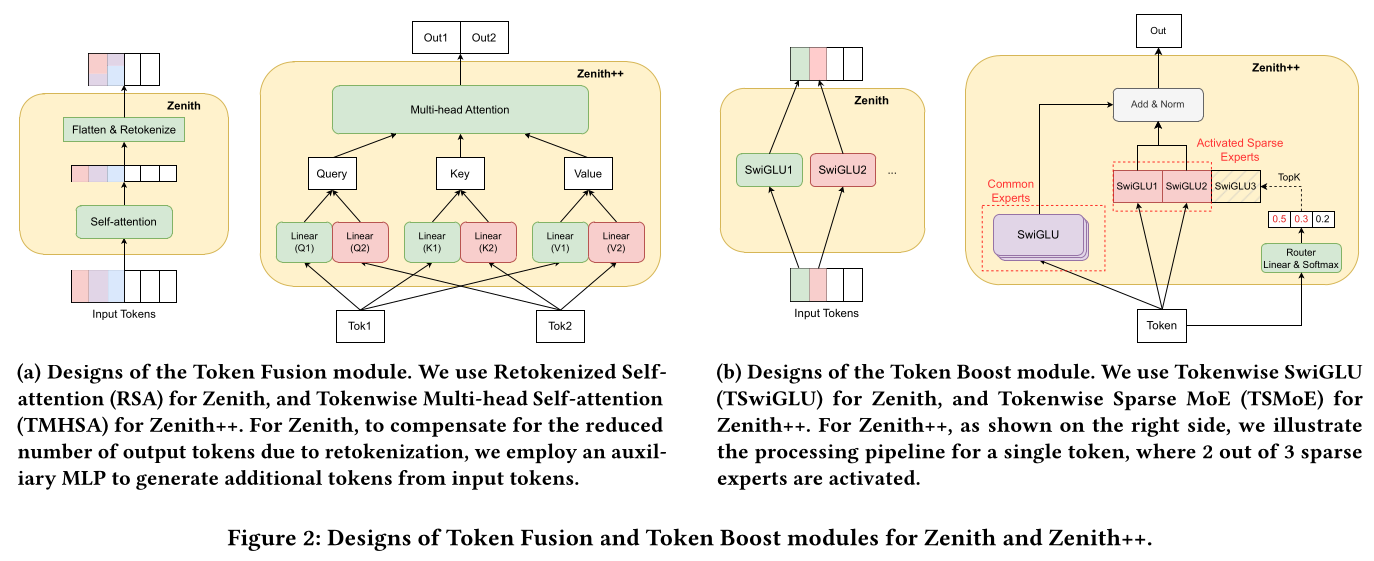
Retokenized Self-Attention (RSA):在Zenith中,我们采用Retokenized Self-Attention网络,它由一个self-attention模块后接一个retokenization组件以促进token interaction(Figure 2a, left)。self-attention机制通过引入value组件和可学习weight matrix扩展了传统FM结构,使模型能够关注input的不同部分。由于我们的
Prime Token设计,每个token可能编码多个features,其中这些features需要进一步的interaction。为解决这一点,我们引入retokenization模块,其中Prime Tokens交换信息,允许原本嵌入在同一token内的features相互融合,以便在下一self-attention层中进行后续interactions。input Prime Tokens是一个矩阵tokens数量,token维度。我们通过下式计算self-attention interaction:其中:
这就是简化版的
self attention:query投影矩阵和key投影矩阵都是单位矩阵、移除了softmax、没有除以然后我们将
tokenize为retokenization是一种computation-free的操作,它增加每个token的contextual richness,并使得同一Prime Token内的feature crossing成为可能。由于
tokens,我们使用MLP将原始输入Tokenwise Multi-Head Self-Attention (TMHSA):对于Zenith++,我们将Fused Self-Attention网络升级为Tokenwise Multi-Head Attention用于token fusion。TMHSA通过为每个Prime Token分配不同的query、key和value投影矩阵,显著增强模型表达力,从而使模型能够容纳显著更多参数。与传统注意力机制在token间共享投影权重不同,tokenwise attention为每个token引入unique projections,在不显著增加计算成本的情况下实现更丰富交互。由于
TMHSA为Prime Tokens提供足够容量以充分交互和交换信息,我们移除了Zenith++中的retokenization模块。具体来说,将第
token表示为representation为multi-head attention layer的输出计算为:其中:
attention heads数量,head的维度。token- and head-specific的。
经过残差之后,
Token Fusion的输出(也就是Token Boost的输入)与传统
multi-head attention区别:传统
multi-head attention也是token-wise来计算的,但是不同token共享相同的参数。这里采用
token-wise不同的参数。
1.2.4 Token Boost
Token Boost模块在增强模型表达力和增强token heterogeneity方面发挥关键作用,正如我们稍后将在第1.3.2节中展示的,这对于高效scaling up至关重要。Prime Token design使每个token能够捕获丰富的且多样化的信息,有效地充当a collection of specialized experts,类似于Mixture-of-Experts网络中的experts。为补充这一点,我们的Token Boost模块设计以tokenwise parameterizations为中心,其中每个token都有自己的token boost网络。Tokenwise SwiGLU (TSwiGLU):对于Token Boost的Zenith版本,我们使用Tokenwise SwiGLU(Figure 2b left):其中:
对于
SwiGLU/FFN,通常都是注意,不同的
token具有自己的tokenwise parameterizations的。Hadamard)乘积。这种逐元素乘积增加了乘法交互(multiplicative interactions)的阶数,类似于DCN-V2网络(《Dcn v2: Improved deep & cross network and practical lessons for web-scale learning to rank systems》)中的那些,这促使我们选择SwiGLU作为前馈神经网络的骨干。
由于
Zenith的tokens组成,我们通过应用于MLP重新生成剩余的tokens。Zenith的final output输出为:这里有个残差操作。
Tokenwise Sparse Mixture-of-Experts (TSMoE):为了进一步提高模型的scaling效率,Zenith++将标准前馈神经网络替换为Tokenwise Sparse Mixture-of-Experts,灵感来自标准Sparse Mixture-of-Experts(《Glam: Efficient scaling of language models with mixture-of-experts》、《Switch transformers: Scaling to trillion parameter models with simple and efficient sparsity》)。如Figure 2b right所示,该模块包含两类专家:shared experts:始终参与计算。sparse experts:根据token-specific routing decisions选择性地被激活。
这种设计在不增加额外计算开销的情况下实现显著更大的模型容量。
令
shared (common) experts总数,sparse experts总数,token激活的sparse experts数量,tokenexperts:其中:
tokenrouting weight matrix)。activated expert indices。用于
tokenMoE-enhanced FFN的输出为:其中:
shared expert和第activated sparse expert,每个都使用TSwGLU函数实现,与Zenith相同。这里,每个
token经过Sparse MoE后,我们获得Token Boost的输出Layer Normalization:.
1.2.5 Training and Inference Optimizations
Zenith依赖于fused-token representations和tokenwise computations。虽然这些tokenwise操作提高了建模灵活性,但它们也增加了矩阵乘法总数,降低了modern accelerators上的吞吐量。引入SparseMoE layer增加了两个进一步复杂问题:(i):expert-activation不平衡,少数experts接收大部分流量。(ii):routing computation solely to the selected experts的开销。即,把计算只分派给被选中的专家,这一过程本身带来的额外开销。
我们通过若干互补策略解决这些问题,详见以下各节。
Efficient Tokenwise Computations:为消除每个token触发独立矩阵乘法时累积的kernel-launch开销,我们采用NVIDIA cuBLAS库(《Introducing Grouped GEMM APIs in cuBLAS and More Performance Updates》)中可用的GroupedGEMM原语。GroupedGEMM将tokenwise GEMM操作打包为a single batched call,为我们的tokenwise design带来显著更高的GPU占用率和端到端吞吐量。Learning-Rate Warm-up:训练早期,Sparse-MoE router倾向于将大多数tokens导向仅一两个experts,剥夺其他experts的梯度信号。我们通过an extended learning-rate warm-up (LR warmup)来抵消这种崩溃:训练从base learning rate的仅0.1%开始,并在前一百万步内线性增加到标称值。由此产生的low-gradient regime使randomly initialized router有时间探索diverse routing patterns,之后专家负载(expert loads)变得良好平衡,每个expert接收足够训练数据。Auxiliary Losses:为了进一步鼓励experts之间工作负载平衡,我们引入两个辅助损失项。第一个是负载平衡损失(
load balancing loss)(《Switch transformers: Scaling to trillion parameter models with simple and efficient sparsity》),它惩罚router’s output probabilities与the actual number of tokens routed to each expert之间的不匹配:其中:
batch size,token数量)。sparse experts总数,token激活的sparse experts数量。experttokens的比例。token选择了expert1;否则为0。因为每个
token激活experts,所有experttoken的激活份额” 中的占比。满足expertgating网络针对第token分配给expert
这个损失函数惩罚的是实际路由比例
token选中,router给它的平均概率optimization过程会促使router调整概率,让所有专家的负载更均衡,避免“赢者通吃”。为了进一步防止专家崩溃(即一个专家主导路由决策),我们采用了第二个项——称为
z-loss(《St-moe: Designing stable and transferable sparse expert models》),以阻止router产生过大的logits:其中:
router在位置pre-softmax输出(即,logit)。
1.3 评估
我们评估所提出的
Zenith架构(包括Zenith和Zenith++实现)与其他流行架构在不同模型规模下的表现。为展示我们方法的实际有效性,所有模型都部署在TikTok Live推荐平台上。数据集。我们利用
TikTok Live推荐平台ranking阶段的production数据集进行训练和评估,该数据集包含流式方式的真实世界user-item interaction数据。数据集统计如Table 1所示。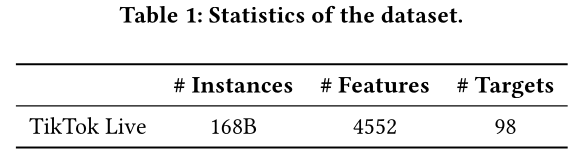
评估指标:我们采用多个指标全面评估每个模型的计算成本和预测性能:
模型规模:我们用以下指标量化模型大小和计算开销:
#Params:模型中的总参数数量,包括所有层的可训练权重。sparse embedding table在我们的实验中跨模型共享,不纳入比较。GFLOP:单次推理所需的浮点运算总数(以十亿计)。这提供了计算量负载的更准确度量,尤其当并非所有参数都被激活使用时。
模型性能:我们报告
main CTR target的以下标准模型性能指标:LogLoss:预测概率与ground truth的对数损失。AUC:Area Under the ROC Curve,衡量模型将正样本排在负样本之上的能力。UAUC:用户平均AUC,对每个用户的AUC分数取平均,以反映个性化排序质量。
所有结果均报告原始值、以及相对于
baseline model的相对改进。
Baselines & Hyperparameters:我们选择了一些广泛使用的DLRM以及近期强基线,包括DCN-V2(《Dcn v2: Improved deep & cross network and practical lessons for web-scale learning to rank systems》)、DHEN(《DHEN: A Deep and Hierarchical Ensemble Network for Large-Scale Click-Through Rate Prediction》)和Wukong(《Wukong: Towards a Scaling Law for Recommendation Models》)。我们调优超参数以实现基线的scaling,如下所示:DCN-V2:我们通过增加层数、以及在Cross Network中使用MLP来替代单个投影矩阵来scale up模型。我们在Deep Network之后应用了sequential modeling with a Deep Network。DHEN:我们使用了DCN-V2的cross network和multi-head self-attention模块的组合。我们通过增加DHEN层数以及size of the MLPs attached after each interaction module来scale up模型。Wukong:我们通过增加Wukong层数并增加其FM Block中MLP的隐藏单元数量来scale up模型。
对于
Zenith和Zenith++,我们采用32 Prime Tokens,从原始feature embeddings分组而来,包括3 tokens based on ID features、13 tokens based on sequence features、以及16 other tokens based on other generalizable features。每个Prime Token的维度范围从256 ~ 1024,层数范围从2 ~ 8,取决于模型规模。Training:对于所有模型,我们使用RMSPropV2优化器,学习率为0.01,动量为0.99999,初始化因子为0.015625,并配合学习率预热。
1.3.1 离线结果
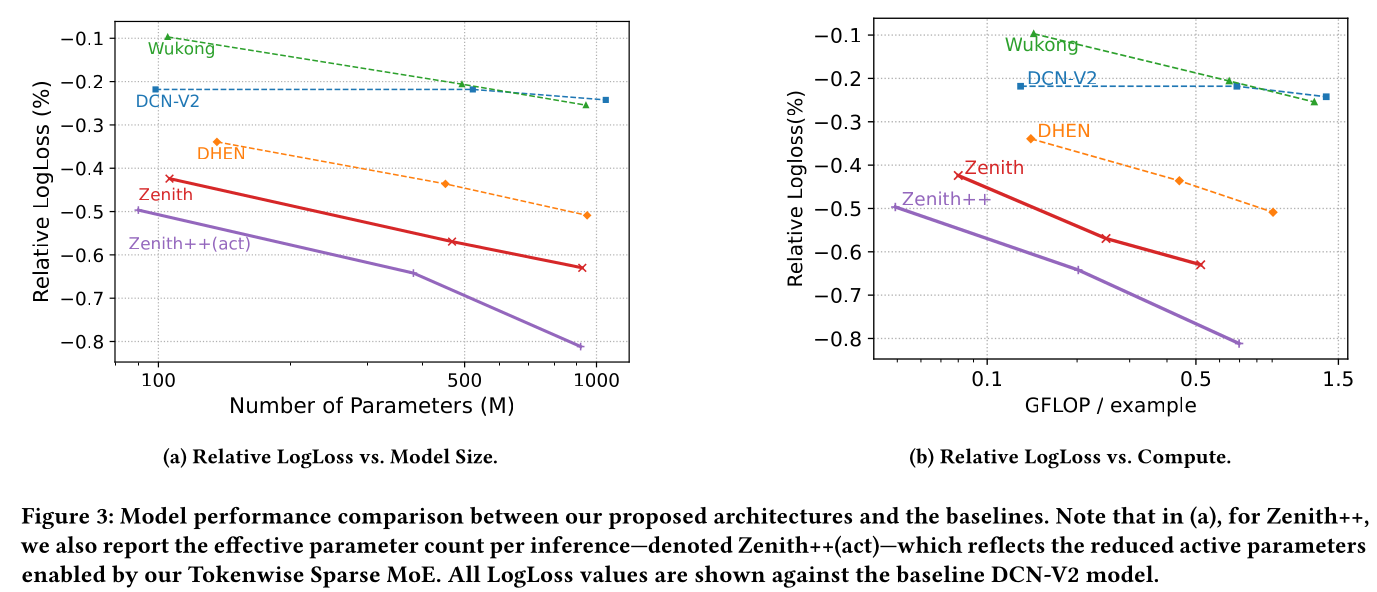
Figure 3展示了不同模型规模和计算预算下relative LogLoss的比较分析。我们从两个角度报告结果:(a):性能与模型规模的关系。(b):性能与inference-time FLOPs的关系。
基线是一个
22.8M参数的DCN-V2模型。尽管
DCN在scale up到100M参数时表现出适度增益,但进一步增加DCN层数或scale up其MLP不再产生额外改进。相比之下,
Wukong比DCN更有效的scale up,但仅在500M参数或更多规模时才优于它,且性能增益仍然有限。Wukong采用大型MLP将interaction results映射回tokens,这产生高参数成本并导致低效参数利用——将其优势限制在very large scales。DHEN将DCN-v2的cross network与self-attention集成在一起,在所有尺度上持续提供比DCN和Wukong更强的性能,LogLoss改进约为0.3% ~ 0.5%。DHEN也表现出良好的scalability。然而,其收益仍然不大,且其混合架构由于涉及异质组件(heterogeneous components)而增加了tuning的复杂性。我们提出的
Zenith模型在不同尺度上持续优于所有基线,相比DCN基线实现0.42% ~ 0.63%更低的LogLoss。凭借我们的高效设计,包括使用Prime Tokens减少input token数量、以及用于轻量级token fusion的retokenization,Zenith在采用最少training FLOPs的同时实现更好性能。当与最佳基线DHEN在同等计算水平比较时,Zenith将LogLoss改进0.15% - 0.2%,这在现实世界场景中代表显著增益。此外,Zenith更简单且模块化的架构使生产环境中的operator-level optimizations和tuning更容易。Zenith++通过引入TMHSA和TSMOE进一步增强模型性能。这些组件引入sparsity和per-token computation,以在降低计算成本的同时保持表达力。结果,Zenith++在保持整体FLOPs受控的同时在性能上超过Zenith。平均而言,Zenith++在激活相似数量参数时比Zenith实现0.08%更低的LogLoss。值得注意的是,在500M参数或更少规模下,Zenith++实际上使用更少FLOPs。此外,这些曲线表明Zenith++具有更大的进一步scaling的潜力。
如
Table 2所示,Zenith和Zenith++在所有模型规模下持续实现最高AUC和UAUC。在小规模设置中,
Zenith显著优于DCN-V2、Wukong和DHEN。在中等规模下,
Zenith++(总参数916M中仅383M激活参数)相比DCN基线实现0.78%的UAUC增益,优于所有其他模型。鉴于其强性能和高效计算,我们采用此版本Zenith++进行真实世界在线A/B测试。在大规模下,
Zenith++(总参数1822M中920M激活)交付最佳结果,达到AUC增益0.55%和UAUC增益0.97%,确立Zenith++为SOTA架构。
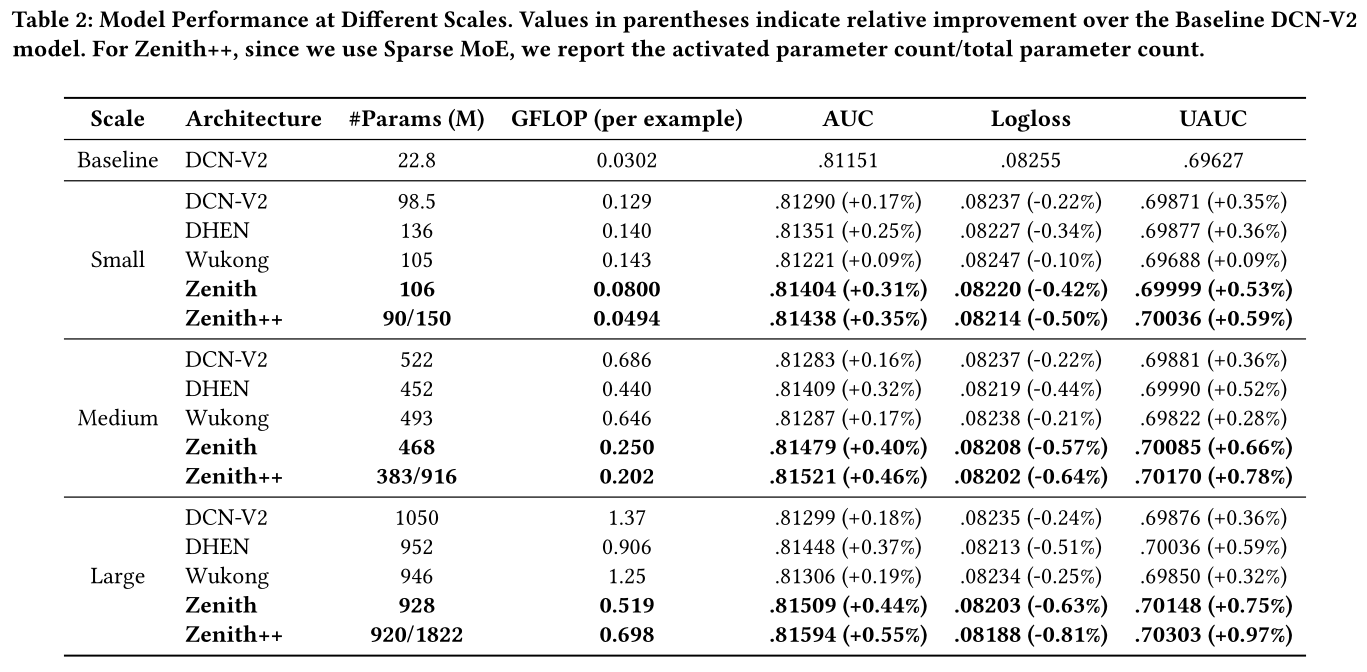
总体而言,
Zenith模型表现出更强scalability和更高效率。在所有尺度上,Zenith不仅降低prediction loss,还提供有利的compute-performance权衡,使其成为现实世界大规模推荐系统(如TikTok Live)的理想架构。
1.3.2 Token Heterogeneity
我们现在强调我们
tokenwise parameterization方案在Token Boost模块中的关键优势,这使Zenith和Zenith++都获得了优越的scaling laws。最初,我们尝试在
Token Boost模块中应用传统的non-tokenwise SwiGLU and SMoE,但在50M参数规模后遇到显著性能饱和。我们尝试将Prime Token维度从512增加到768,将token数量从8增加到16,并将层数从4增加到6,所有这些都使总参数数量翻倍,却没有性能增益。这些观察促使我们深入研究架构,理解Prime Tokens在模型中如何相互作用。令人惊讶的是,如Figure 4a和Figure 4c所示,我们发现Prime Tokens在几层feature interaction后几乎变得同质(homogeneous)。这表明模型无法通过堆叠更多interaction layers从而从feature tokens中提取additional information,解释了性能饱和。为解决这一点,我们需要确保
Prime Tokens在每个interaction layer后保持异质(heterogeneous),携带distinctive information以供进一步提取。我们通过升级传统SwiGLU和SMOE模块为tokenwise parameterization来解决这一点。这提供了所需模型容量,使每个Prime Token能够捕获不同信息,导致即使在多层feature interaction后仍具有强的token heterogeneity。如Figure 4b和Figure 4d所示,使用tokenwise parameterization后,Token Boost模块显著降低了平均绝对相似性(average absolute similarity)——在Zenith中从0.5降至0.06,在Zenith++中从0.68降至0.47,使两个变体都能进一步scale up而不达到性能瓶颈。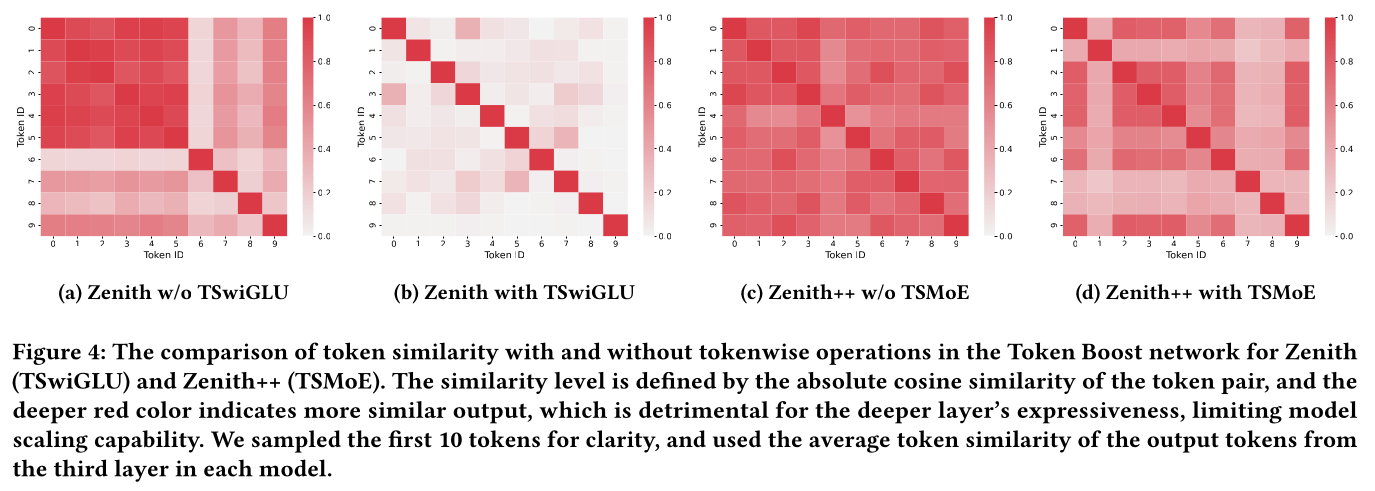
1.3.3 Ablation Study
我们进行消融研究以评估
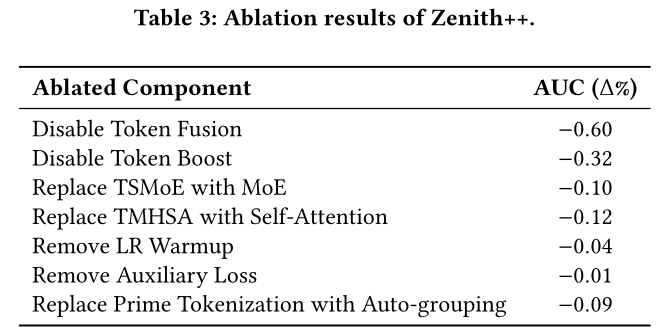
Zenith++中关键design choices的影响。如表Table 3总结:TSMOE和TMHSA都对模型性能有实质贡献,而Learning Rate Warmup和Auxiliary Loss等训练技术提供额外增益。这确认每个组件都发挥积极作用,其中架构设计产生最显著改进。同时,将
prime tokenization替换为基于MLP的Auto-grouping方法仅导致0.09%的AUC下降,表明即使没有expert-tuned feature tokenization,Zenith也具有鲁棒性。Prime Tokenization是 Zenith中手工设计的特征分组方式。论文前面提到,他们按照规则把原始特征映射成32个Prime Tokens:包括3 tokens based on ID features、13 tokens based on sequence features、以及16 other tokens based on other generalizable features。这种设计依赖领域专家经验,需要人工决定哪些特征放一起、哪些单独成token。MLP-based auto-grouping approach是指用MLP自动学习分组。也就是不再手工指定特征如何分组,而是用一个MLP自动把原始特征embedding映射/聚合成若干个tokens。这是一种更自动、更少人工干预的tokenization方式。expert-tuned feature tokenization指人工调优的feature tokenization,即上面那种由专家根据语义和重要性设计的Prime Tokenization。
1.3.4 Online A/B Results
为充分验证所提出架构在现实世界场景中的有效性,我们进行了为期一个月的在线
A/B测试,比较DCN-V2基线和我们的Zenith++ (383/916M)模型在TikTok Live上的表现,TikTok Live是一个领先的在线直播平台,吸引了全球数十亿用户。我们呈现在线性能指标——AUC和Logloss,以及直播推荐的两组关键业务指标——Quality Watch Session / User和Quality Watch Duration / User:Quality Watch Session定义为深度观看会话(例如,大于1分钟)或伴随积极用户行为(例如,点赞、评论、关注、分享、礼物等)的观看会话。Quality Watch Duration定义为用户在其Quality Watch Sessions中花费的总时间。
结果如
Table 4所示。Zenith在在线AUC和logloss上显著优于基线,并在Quality Watch Session / User上实现+9.93%的增益,在Quality Watch Duration / User上实现+8.11%增益。这些结果突显了我们新颖排序架构的实质性现实世界影响。Online A/B test效果很好,最大的原因是DCN-V2基线比较弱了。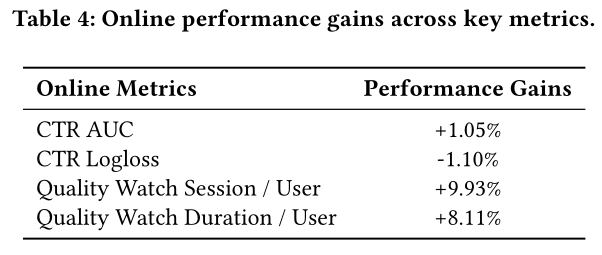
1.4 结论
在这项工作中,我们提出
Zenith,一种为大规模推荐系统量身定制的scalable且高效的神经架构。通过引入Prime Tokens概念并设计专用Token Fusion模块和Token Boost模块,Zenith有效平衡模型表达力和计算效率,相比现有方法表现出优越的scaling laws。我们还强调了token heterogeneity在scaling up ranking models中的重要性,并展示了在架构设计中促进它的实用方法。我们希望我们的工作将成为通过个性化推荐优化用户体验的重要一步。
1.5 附录
1.5.1 A. 复杂度分析
在本节中,我们提出所提出的
Zenith和Zenith++模型的正式复杂度分析。Zenith:令token数量,token维度,SwiGLU的隐层维度。self-attention interaction计算Retokenization步骤将Token Boost模块应用SwiGLU激活,权重轻量级
MLP处理剩余tokens,增加final output包括残差连接和归一化,成本可忽略。
总体而言,模型有
Zenith++:在
tokenwise attention中,tokens中的每一个对heads中的每一个head都有唯一投影矩阵,导致总参数数量为tokenwise projectionsattention computation对于
sparse MoE layer,routing weights贡献shared experts和sparse experts总共贡献token的路由和专家计算需要
由于