一、S3-Rec [2020]
《S3-Rec: Self-Supervised Learning for Sequential Recommendation with Mutual Information Maximization》
近年来,深度学习在序列推荐(
《 sequential recommendation》)方面取得了显著进展。现有的神经序列推荐模型通常依赖item prediction loss来学习model parameters或data representations。然而,用这种loss来训练好的模型容易出现数据稀疏问题(data sparsity problem)。由于它过于强调final performance,在序列推荐中,context data和sequence data之间的关联(association)或融合(fusion)没有得到很好的捕获和利用。 为了解决这个问题,我们提出了S3-Rec模型,即基于自注意力神经架构的Self-Supervised learning for Sequential Recommendation。我们方法的主要思想是:利用固有的data correlation来导出自监督信号,并通过pre-training方法增强data representations,以改进序列推荐。对于我们的任务,我们设计了四个辅助自监督目标,利用互信息最大化(mutual information maximization: MIM)原则来学习attribute、item、subsequence和sequence之间的相关性。MIM提供了一种统一的方式来描述不同类型数据之间的相关性,特别适合我们的场景。在六个真实世界数据集上进行的大量实验表明,我们提出的方法优于现有的SOTA方法,尤其是在训练数据有限的情况下。此外,我们将自监督学习方法扩展到其他推荐模型,也提高了它们的性能。近年来,许多在线平台取得了巨大成功,如
Amazon和Taobao。在在线平台中,用户行为是动态(dynamic)的,并且会随着时间而演变。因此,捕获用户序列行为的动态对于做出合适的推荐至关重要。为了准确描述用户兴趣并提供高质量的推荐,序列推荐任务在文献中得到了广泛研究。 通常,序列推荐方法从用户的历史行为中捕获有用的序列模式(sequential patterns)。深度学习对这一动机进行了广泛探索。各种使用循环神经网络(recurrent neural network: RNN)、卷积神经网络(convolutional neural network: CNN)和自注意力机制的方法被提出来学习用户偏好的good representations,并刻画sequential user-item interactions。 此外,研究人员将丰富的上下文信息(如item attributes)纳入神经序列推荐器(neural sequential recommenders)。已经证明,考虑上下文信息对于提高序列推荐系统(sequential recommender systems)的性能很重要。 尽管现有方法在一定程度上被证明是有效的,但有两个主要缺点可能会影响推荐性能:第一,它们依赖
item prediction loss来学习整个模型。当纳入上下文数据时,所涉及的参数也通过唯一的optimization objective进行学习。已经发现,这种优化方式很容易出现数据稀疏等问题。第二,它们过于强调
final performance,而在data representations中,上下文数据(context data)和序列数据(sequence data)之间的关联(association)或融合(fusion)没有得到很好的捕获。例如,来自各个领域的越来越多的证据所示,有效的data representation(例如,pre-trained contextualized embedding)是提高现有模型或架构性能的关键因素。因此,需要重新思考learning的范式,以开发更有效的序列推荐系统。
为了解决上述问题,我们借鉴自监督学习(
self-supervised learning)的思想来改进序列推荐。自监督学习是一种新兴的范式,旨在让模型从原始数据的固有结构中学习。自监督学习的一般框架是:首先直接从原始数据中构建训练信号,然后使用额外设计的优化目标对模型参数进行预训练。如前所述,有限的监督信号和无效的data representations是现有神经序列方法的两个主要学习问题。幸运的是,自监督学习似乎为这两个问题都提供了一个有前景的解决方案:它利用固有的data correlation来设计辅助训练目标,并通过具有丰富自监督信号的pre-trained方法来增强data representations。然而,对于序列推荐,上下文信息以不同的形式或具有不同的固有特性来特性存在,包括item、attribute、subsequence或sequence。开发一种统一的方法来描述这种data correlations并不容易。对于这个问题,我们受到最近提出的互信息最大化(mutual information maximization: MIM)方法的启发。通过最大化这些视图的encoded representations之间的互信息,该方法在捕获原始输入的不同视图(或parts)之间的相关性方面特别有效。 为此,在本文中,我们提出了一种新颖的基于MIM的自监督学习方法来改进序列推荐,称为S3-Rec。基于自注意力推荐架构,我们建议:首先使用自监督信号对序列推荐器进行预训练,然后根据推荐任务对模型参数进行微调。主要的创新点在于pre-training阶段。具体来说,我们精心设计了四个自监督优化目标,分别用于捕获item-attribute、sequence-item、sequence-attribute和sequence-subsequence之间的相关性。这些优化目标以MIM的统一形式开发。因此,S3-Rec能够以通用的方式描述不同粒度级别或不同形式之间的相关性。它也能够灵活地适应新的数据类型或新的相关性模式(correlation patterns)。通过这种预训练方法,我们可以有效地融合各种上下文数据,并学习attribute-aware contextualized data representations。最后,将学到的data representations馈入到神经推荐器中,神经推荐器将根据推荐性能而被优化。 为了验证我们提出的S3-Rec方法的有效性,我们在六个不同领域的真实世界推荐数据集上进行了广泛的实验。实验结果表明,与许多有竞争力的方法相比,S3-Rec达到了SOTA的性能,尤其是在训练数据有限的情况下。我们还表明,我们的S3-Rec能够有效地适应其他类别的神经架构,如GRU和CNN。我们的主要贡献总结如下:
据我们所知,这是首次将基于
MIM的自监督学习应用于改善序列推荐任务。我们提出了四个自监督优化目标(
self-supervised optimization objectives),以最大化不同形式或粒度的上下文信息的互信息(mutual information of context information)。在六个真实世界数据集上进行的大量实验证明了我们提出的方法的有效性。
1.1 基础概念
问题描述:假设我们有一组用户
itemsitem。用户数量和item数量分别表示为items交互序列:item。为了方便起见,我们使用itemartist)、专辑(album)和流行度(popularity)等辅助信息。所有属性构成一个属性集合基于上述符号,我们现在定义序列推荐任务。正式地,给定用户的历史行为序列
itemnext item。互信息最大化:我们方法中的一个重要技术是互信息最大化(
Mutual Information Maximization : MIM)。它基于互信息(mutual information)这个核心概念发展而来,互信息用于衡量随机变量之间的依赖关系。给定两个随机变量直接最大化互信息通常是难以处理的。因此,我们采用
InfoNCE,它基于噪声对比估计(Noise Contrastive Estimation: NCE)。InfoNCE定义为:其中:
input的不同视图。encoded representations之间的内积;或者,一个图像及其局部区域的encoded representations之间的内积。proposal distribution
请注意,
InfoNCE与交叉熵相关。如果InfoNCE类似于最大化标准交叉熵损失:该方程表明:
InfoNCE与最大化partition function)。基于此公式,我们可以利用特定的item及其属性,或一个序列及其包含的items。
1.2 方法
现有研究主要强调使用单一的
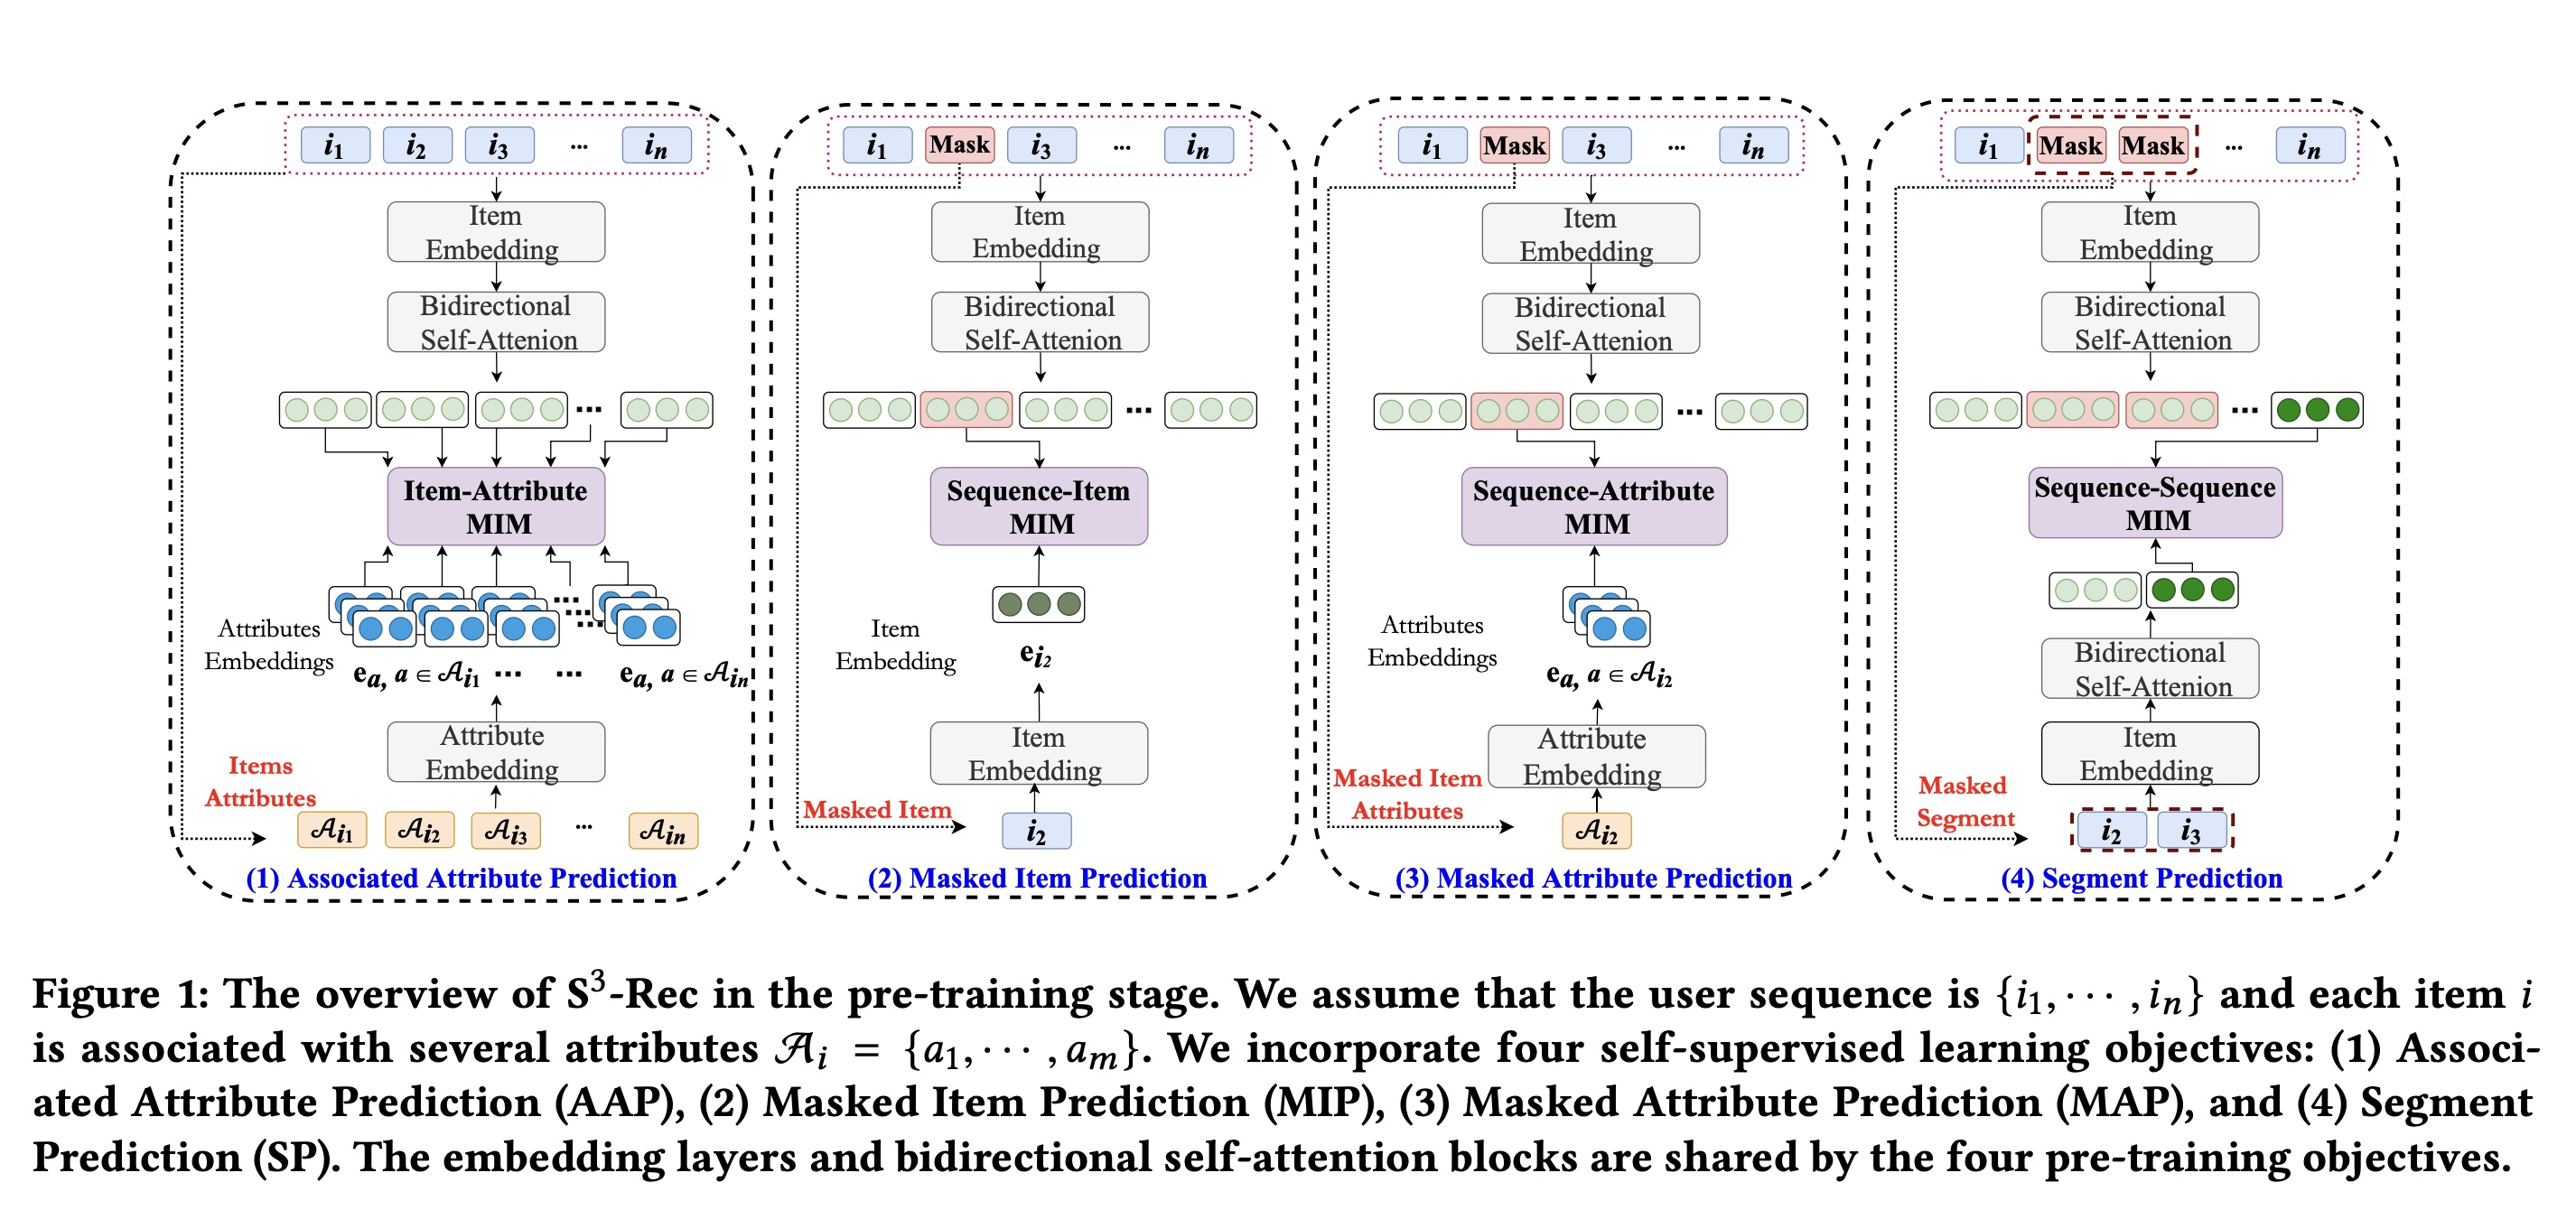
item-level优化目标来强调sequential characteristics的效果。受MIM最近进展的启发,我们从不同的角度出发,通过最大化原始数据不同视图之间的互信息来开发神经序列推荐器。 我们方法的基本思想是:纳入几个精心设计的自监督学习目标(self-supervised learning objectives)来增强原始模型。为了开发这些目标,我们利用input的固有特性中反映的有效的correlation信号。对于我们的任务,我们考虑不同粒度级别的信息,包括attribute、item、segment(即子序列)和sequence,这些被视为输入的不同视图。通过捕获multi-view correlation,我们将这些自监督学习目标与最近在语言建模中提出的pre-training框架统一起来。S3-Rec的概述如Figure 1所示。在以下部分中,我们首先介绍我们提出的方法的base model,该模型基于Transformer架构开发。然后,我们将描述如何利用attribute、item、segment和sequence的correlation信号,基于InfoNCE方法来增强data representations。最后,我们对我们的方法进行讨论。(1)图有问题:Item Embedding不需要经过Bidirectional Self-Attention而直接馈入Item-Attribute MIM即可。这四个任务如何训练?根据论文的实验部分,这四个任务是通过共同训练来进行的:四个损失(即
AAP、MIP、MAP和SP)的权重分别设置为0.2、1.0、1.0和0.5。注意:预训练是双向
Transformer,main task是单向Transformer。
1.2.1 Base Model
我们通过堆叠
embedding layer、self-attention blocks和prediction layer,开发了序列推荐模型的基本框架。Embedding Layer:在embedding mapping阶段,我们维护一个item embedding matrixattribute embedding matrixitem或attribute的高维one-hot representation投影到低维dense representations。给定一个长度为item sequence,我们从look-up来形成input embedding matrix此外,我们引入一个可学习的
position encoding matrixitem sequence的input representation。通过这种方式,sequence representationembedding矩阵求和得到:attribute embedding matrixitem形成一个embedding矩阵item attributes的数量。Self-Attention Block:基于embedding layer,我们通过堆叠多个self-attention blocks来开发item encoder。一个self-attention block通常由两个子层组成,即一个multi-head self-attention layer和一个point-wise feed-forward network。multi-head self-attention机制用于从不同的representation子空间中有效地选择性提取信息。具体来说,multi-head self-attention定义为:其中:
head对应的可学习的参数矩阵。attention function实现为scaled dot-product操作:其中:
input embedding matrix的线性变换,
由于
multi-head attention函数主要基于线性投影构建。我们通过应用point-wise feed-forward network赋予self-attention block非线性。计算定义为:其中:
在序列推荐中,只能利用当前
time step之前的信息,因此我们对multi-head self-attention函数的output应用掩码操作,以去除connections。受BERT启发,在预训练阶段,我们移除掩码机制,以获取item sequence中每个item的双向context-aware representation。从两个方向整合上下文信息对于sequence representation learning是有益的。Prediction Layer:在S3-Rec的最后一层,我们计算在user history的上下文下,用户在第item其中:
item embedding matrixitemrepresentation。事实上
target item除了item idtarget item的属性信息,是不是对任务更有帮助?根据后面的Modeling Item-Attribute Correlation,item embedding已经融合了attribute信息,因此仅使用target item的item id是可以的。L-layer self-attention block在第self-attention blocks的数量。
1.2.2 Self-supervised Learning with MIM
基于上述
self-attention模型,我们进一步利用互信息最大化(MIM)引入额外的自监督信号,以增强input data的representations。我们采用pre-training的方式,基于multi-view correlation构建不同的损失函数。Modeling Item-Attribute Correlation:我们首先最大化items和attributes之间的互信息。对于每个item,其attributes提供了关于它的细粒度信息。因此,我们旨在通过建模item-attribute correlation来融合item-level和attribute-level的信息,期望将有用的属性信息注入到item representations中。给定一个
itemitem本身及其相关属性视为两个不同的视图。形式上,设emebdding layer得到的item embedding,embedding。我们通过对比学习框架(contrastive learning framework)设计一个损失函数,来最大化这两个视图之间的互信息。根据公式Associated Attribute Prediction: AAP损失:其中:
我们采样
negative attributesitemground-truth attributes\表示set subtraction操作。函数
bilinear network)实现:其中:
sigmoid函数。
为了清晰起见,我们给出了单个
item的loss的定义loss扩展到整个item set。Modeling Sequence-Item Correlation:传统的序列推荐模型通常被训练用于预测item item。这种方法只考虑了item sequence从左到右的sequential characteristics。然而需要注意的是,在训练过程中模型实际上可以观察到整个交互序列。受类似BERT的masked language model: MLM的启发,我们提出通过完形填空任务来对item sequence中的双向信息进行建模。对于我们的任务,完形填空设置如下:在每个training step中,我们随机掩码input sequence中一定比例的items(即用special tokens“[mask]” 来替换它们)。然后,我们根据双向的上下文,从原始序列中预测masked items。 因此,我们考虑的第二个损失是利用input sequences的双向上下文来恢复actual item。为此,我们准备了Base Model的一个pre-trained版本,它是一个双向Transformer架构。举例来说,假设我们在序列itemmasked itemdata representations。根据Masked Item Prediction: MIP损失:其中:
irrelevant item。其中:
Self-Attention Block章节中相同的方式并通过双向Transformer架构得到的第learned representation。
Modeling Sequence-Attribute Correlation:在对item-attribute correlation和sequence-item correlation进行建模之后,我们进一步考虑直接将attribute信息与sequential contexts进行融合。具体来说,我们采用与Modeling Sequence-Item Correlation类似的方法,基于surrounding contexts来恢复masked item的attributes。给定一个masked itemsurrounding contextsattribute setMIM)的两个不同视图。因此,我们可以通过以下方式开发Masked Attribute Prediction: MAP损失:其中:
negative attributes。其中:
需要注意的是,现有方法很少直接对
sequential context和属性信息之间的correlation进行建模。然而,我们希望显式地对这种correlation进行建模,以获得更有意义的监督信号,这对于改进多粒度信息的data representations是有用的。注意:这里是通过
surrounding contexts的item id(而不是属性),来预测masked item的属性。Modeling Sequence-Segment Correlation:如上文所示,完形填空学习(Cloze learning)策略在我们的预训练方法中,对于融合sequential contexts和target information起着关键作用。然而,item sequence与word sequence的一个主要区别在于:单个target item可能与surrounding contexts的相关性并不高。例如,用户购买某些商品可能仅仅是因为它们在打折。基于这种考虑,我们将完形填空策略从单个item扩展到item subsequence(即segment)。显然,一个item segment比单个item更能反映清晰的、稳定的用户偏好。因此,我们采用与Modeling Sequence-Item Correlation类似的策略,从surrounding contexts恢复item subsequence。我们期望以此来增强自监督学习信号,并提高pre-trained performance。令
itemMIM)公式来恢复缺失的item segment,即所谓的Segment Prediction: SP损失:其中:
corrupted negative subsequence。其中:
learned representations。为了学习Transformer来获得序列中最后一个位置的state representations。
1.2.3 学习与讨论
在这部分,我们介绍
S3-Rec用于序列推荐的学习过程及相关讨论。学习过程:
S3-Rec的整个过程包括两个重要阶段,即pre-training阶段和fine-tuning阶段。我们在两个阶段分别采用双向Transformer和单向Transformer架构。在预训练阶段,我们通过考虑四种不同类型的相关性来优化自监督学习目标。
在微调阶段,我们利用预训练阶段学到的参数来初始化单向
Transformer的参数,然后利用从左到右的监督信号来训练网络。我们采用pairwise rank loss来优化其参数:其中,我们将每个
ground-truth itemnegative item
讨论:我们的工作提供了一种新颖的自监督方法,通过
pre-trained models从输入中捕获固有的数据相关性,并将其作为额外信号。这种方法具有很强的通用性,许多现有方法都可以纳入这个框架。下面我们进行简要讨论。Feature-based方法,如因子分解机(Factorization Machine: FM)和AutoInt,主要通过context features之间的交互来学习data representations。final prediction是根据user and item features之间的实际交互结果来做出的。在S3-Rec中,associated attribute prediction lossmasked attribute prediction lossattributes之间的交互进行建模,而是专注于捕获attribute信息与item/sequential contexts之间的关联。我们工作的一个主要区别在于,利用特征交互作为额外的监督信号来增强data representations,而不是用于直接进行预测。Sequential models方法,如GRU4Rec和SASRec主要侧重于按从左到右的顺序对contextual items和target item之间的序列依赖关系(sequential dependencies)进行建模。S3-Rec额外引入了一个预训练阶段,利用四种不同类型的自监督学习信号来增强data representations。特别是,masked item prediction lossGRU4Rec、SASRec在捕获序列依赖关系方面有类似的效果,不同之处在于它还可以利用双向序列信息。Attribute-aware sequential models方法,如TransFM和FDSA利用contextual features来改进序列推荐模型,这些特征被视为辅助信息,用于增强representation of items or sequences。在我们的S3-Rec中,attribute与items or sequential contexts进行融合,这能够达到与之前方法相同的效果。此外,pre-trained data representations也可以用于改进现有方法。
1.3 实验
数据集:我们在从四个真实世界平台收集的六个数据集上进行实验,这些数据集具有不同的领域和稀疏度水平。预处理后这些数据集的统计信息总结在
Table 1中。Meituan数据集:该数据集包含2014年1月至2020年1月美团平台在北京的六年交易记录。我们选择类别、位置以及从客户评论中提取的关键词作为attributes。Amazon Beauty, Sports, and Toys:这三个数据集来自Amazon评论数据集。在本研究中,我们选择了三个子类别:“美妆”、“运动与户外” 和 “玩具与游戏”,并将商品的fine-grained categories和品牌作为attributes。Yelp数据集:这是一个用于商业推荐的流行数据集。由于其规模非常大,我们仅使用2019年1月1日之后的交易记录。我们将商业类别作为attributes。LastFM数据集:这是一个音乐艺术家推荐数据集,包含用户对艺术家的tagging behaviors。在该数据集中,用户给艺术家的tags被用作attributes。
对于所有数据集,我们按对
interaction records按照user进行分组,并按交互时间戳升序排序。遵循以往研究,我们仅保留5-core datasets,并过滤掉低于5条interaction records的冷门items和不活跃用户。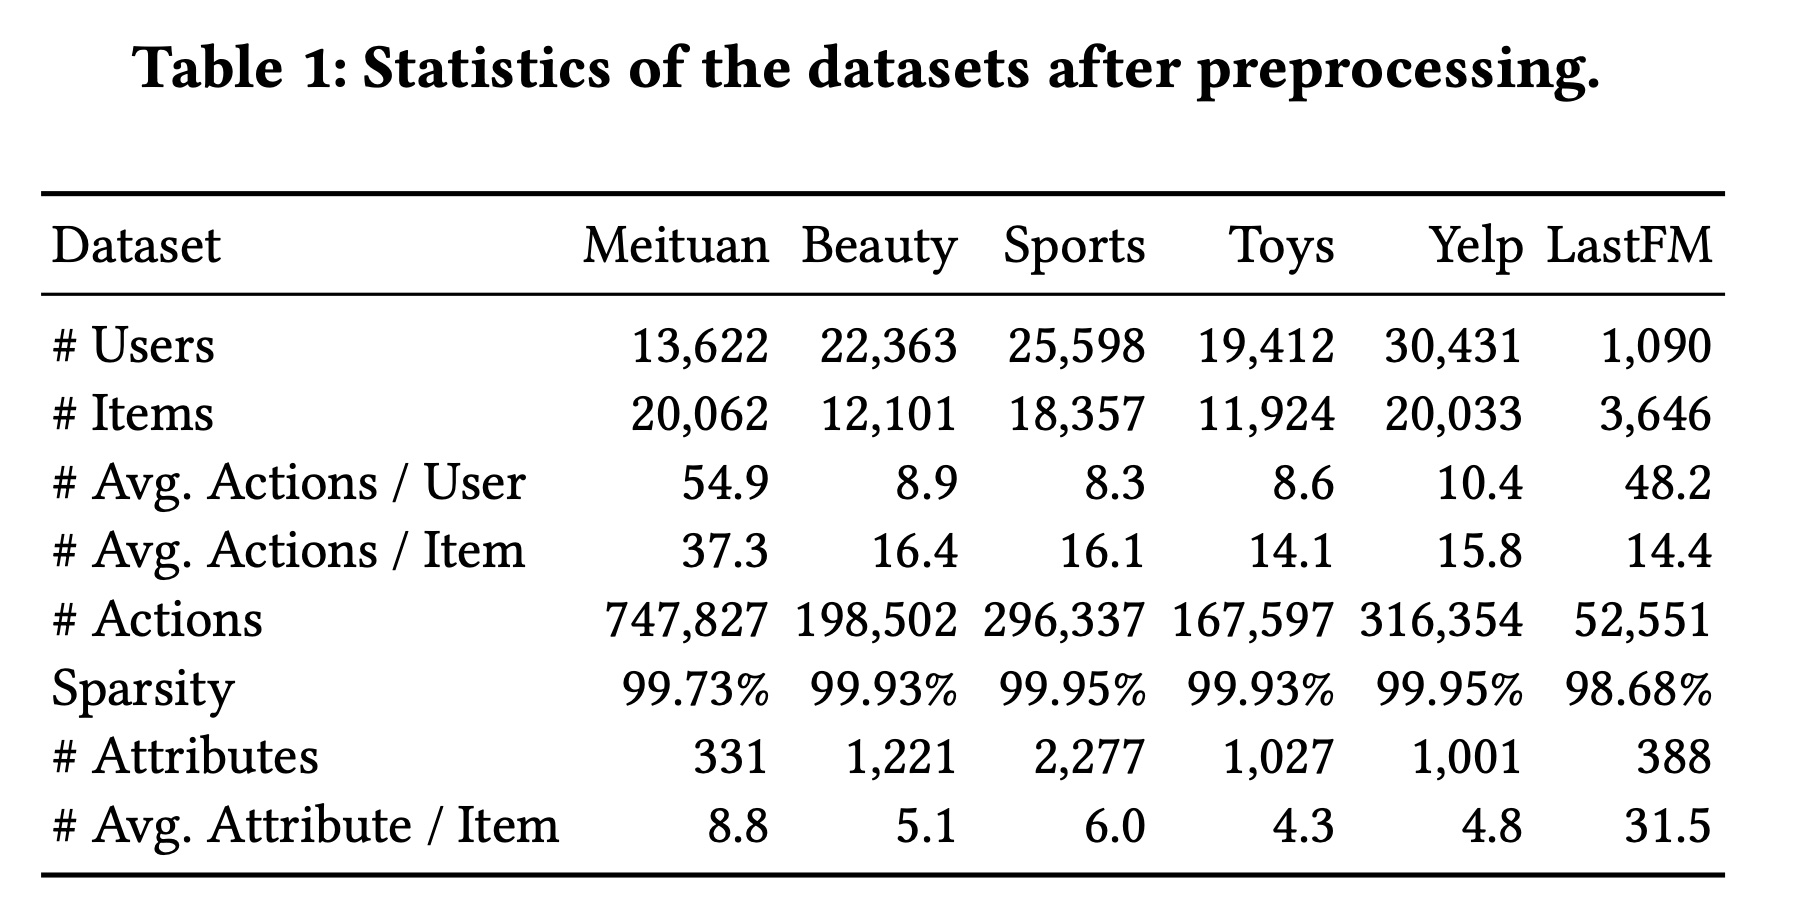
评估指标:我们采用
top-k Hit Ratio: HR@k、top- k Normalized Discounted Cumulative Gain: NDCG@k、以及Mean Reciprocal Rank: MRR来评估性能,这些指标在相关工作中被广泛使用。由于HR@1等于NDCG@1,我们报告HR@{1, 5, 10}、NGCG@{5, 10}和MRR的结果。遵循以往工作,我们采用留一法(
leave-one-out)进行评估。具体来说,对于每个user interaction sequence,最后一个item用作测试数据,倒数第二个item用作验证数据,其余数据用于训练。由于item set较大,使用所有items作为测试的candidates非常耗时。按照常见策略,我们将ground-truth item与99个用户未交互过的随机采样negative items进行配对。我们根据items的ranking来计算所有指标,并报告所有测试用户的平均得分。Baseline Models:PopRec:一种非个性化的方法,根据交互次数来衡量的流行度对items进行排名。FM:使用factorized model来描述变量之间的pairwise interactions。AutoInt:利用多头自注意力神经网络来学习特征交互。GRU4Rec:应用GRU对user click sequence进行建模,用于session-based recommendation。我们使用embedding向量而不是one-hot来表示items。Caser:一种CNN-based的方法,通过应用水平卷积和垂直卷积操作来捕获高阶马尔可夫链,用于序列推荐。SASRec:一种self-attention based的序列推荐模型,使用multi-head attention推荐next item。BERT4Rec:通过双向self-attention机制,使用完形填空目标损失进行序列推荐。HGN:最近提出的方法,采用hierarchical gating networks来捕获用户的长期兴趣和短期兴趣。GRU4Rec的改进版本,利用attributes来提高性能。SASRec的扩展,将representations of item and attribute拼接起来作为模型的输入。FDSA:构建一个feature sequence,并使用feature-level self-attention block对特征转移模式(feature transition patterns)进行建模。这是序列推荐中的SOTA模型。
实现细节:
对于
Caser和HGN,我们使用作者提供的源代码。对于其他方法,我们使用PyTorch实现。所有超参数均按照原始论文的建议进行设置。对于我们提出
S3-Rec,我们将self-attention blocks的数量和attention heads的数量均设置为2。embedding维度为64,最大序列长度为50(遵循《Self-Attentive Sequential Recommendation》)。需要注意的是,我们的训练阶段包含两个阶段(即预训练阶段和微调阶段),预训练阶段学到的参数用于初始化微调阶段模型的embedding layers和self-attention layers。在预训练阶段,
item的掩码比例设置为0.2;据经验实验,四个损失(即AAP、MIP、MAP和SP)的权重分别设置为0.2、1.0、1.0和0.5。我们使用
Adam优化器,学习率为0.001,预训练阶段的batch size = 200,微调阶段的batch size = 256。我们对模型进行100 epochs预训练,然后在推荐任务上进行微调。
代码和数据集可在链接:
https://github.com/RUCAIBox/CIKM2020-S3Rec上获取。
1.3.1 实验结果
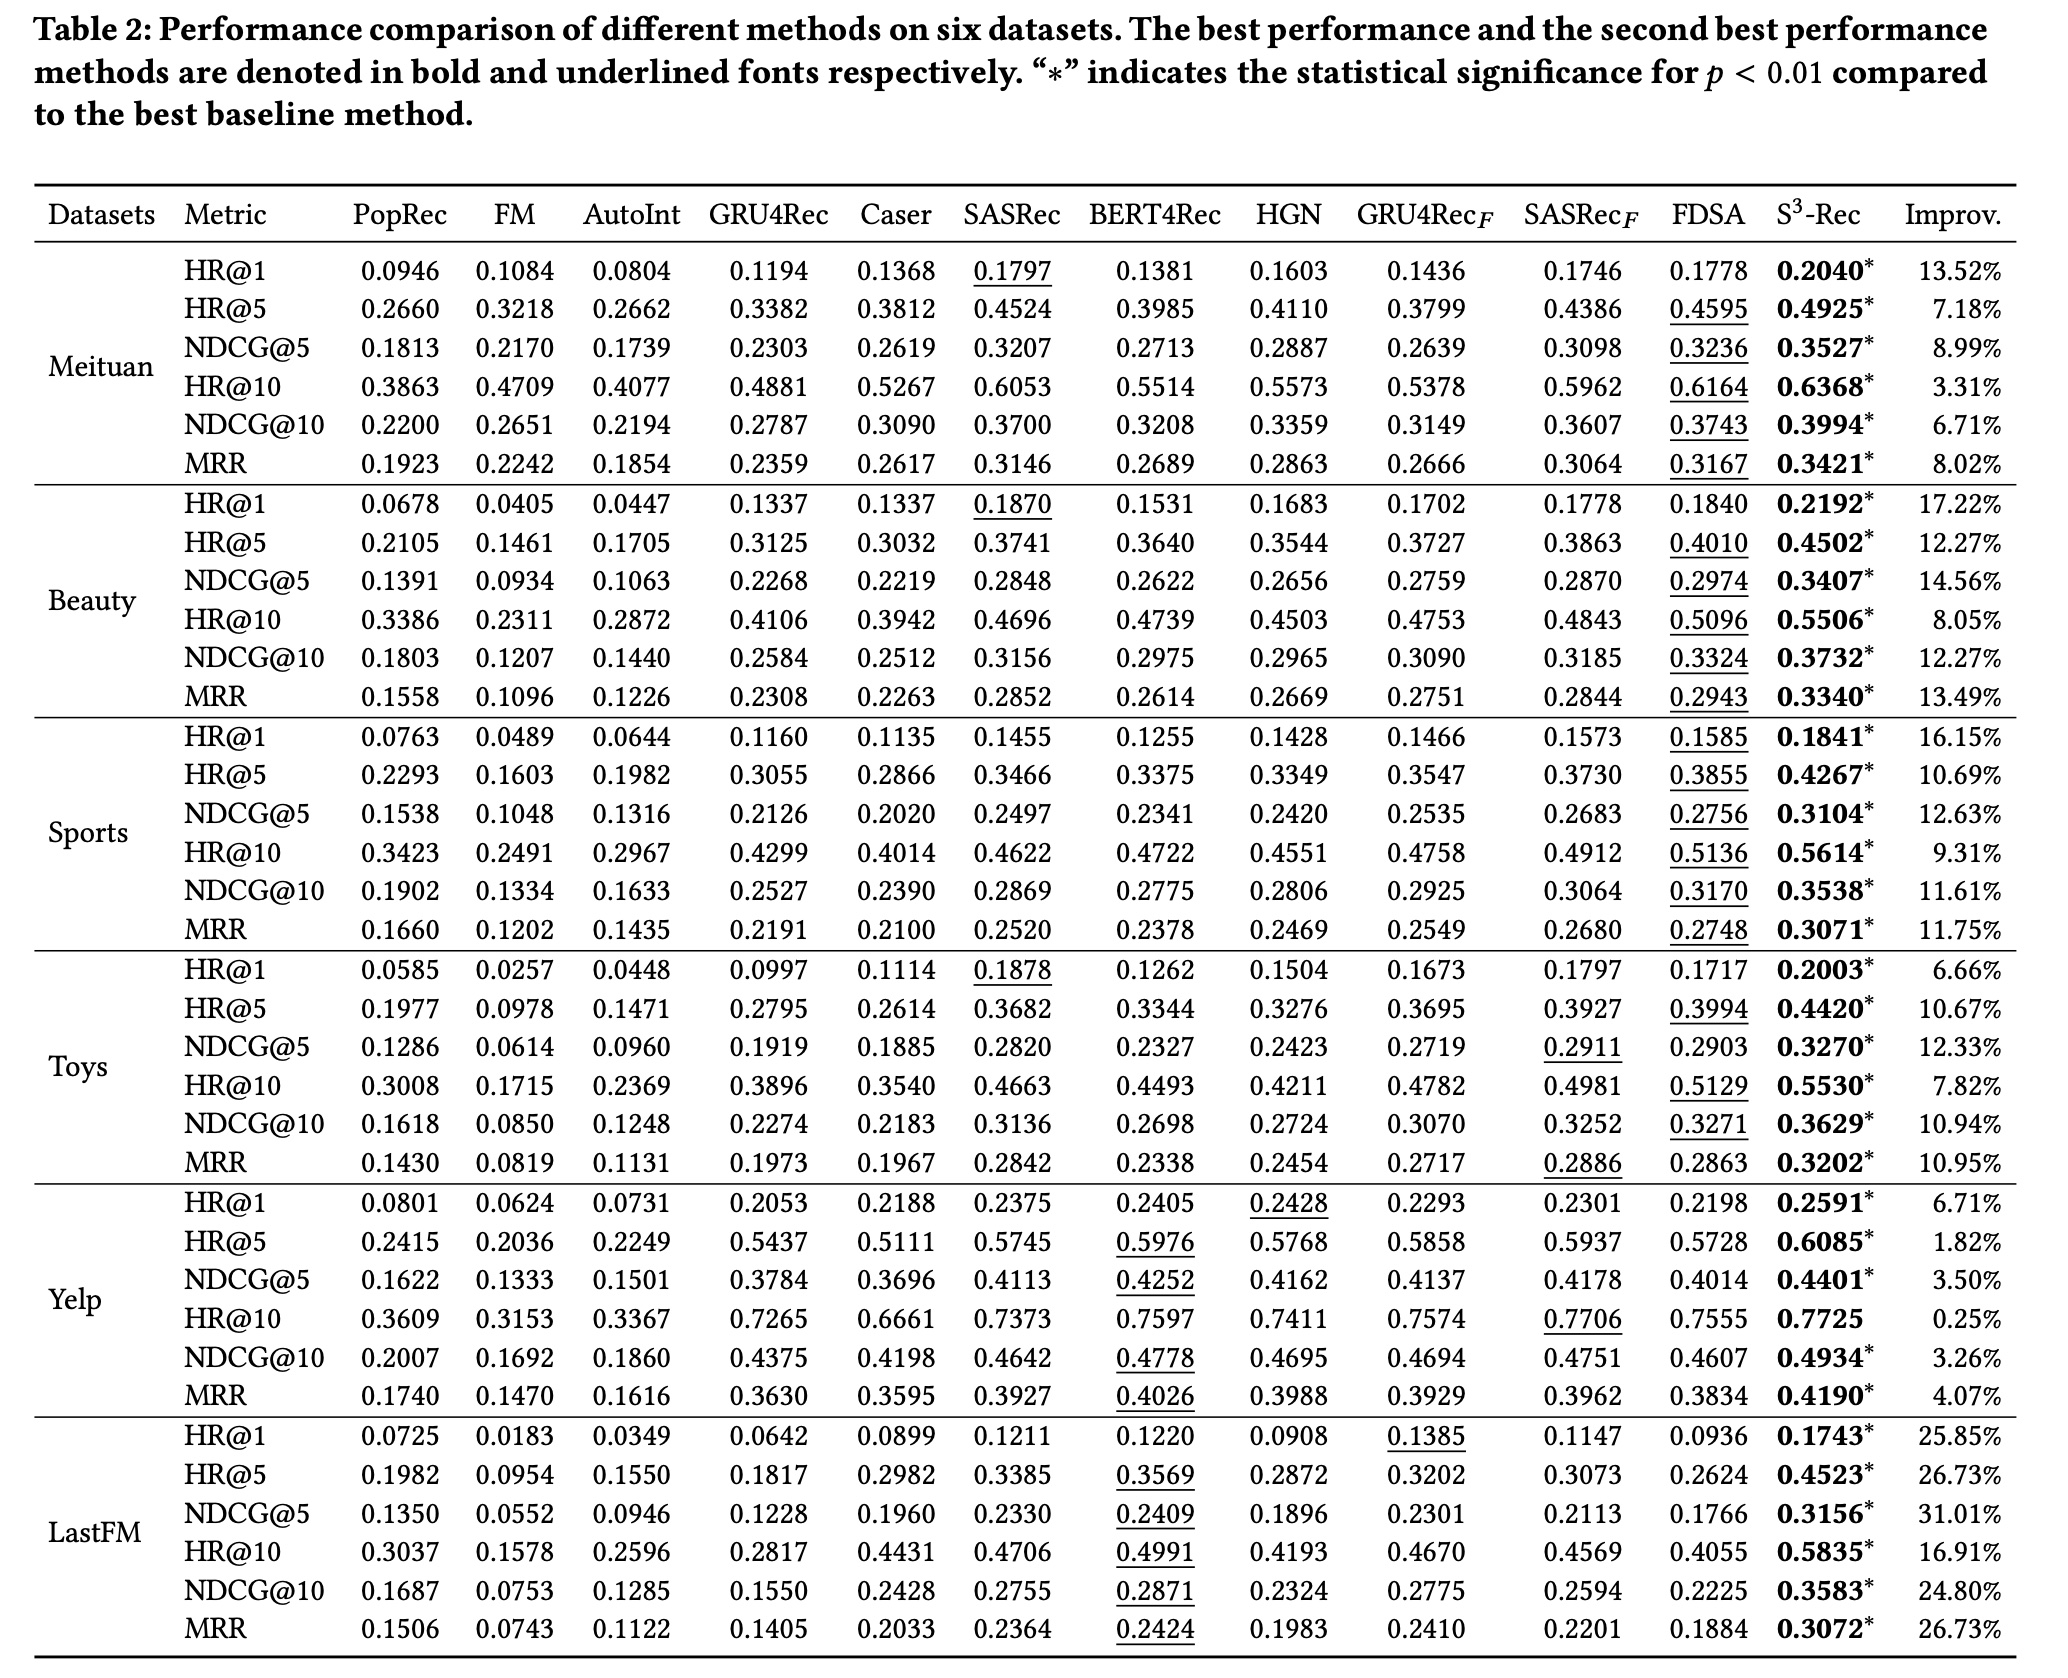
不同方法在所有数据集上的结果如
Table 2所示。基于这些结果,我们可以发现:对于三个
non-sequential的基线方法,在所有数据集上的性能顺序是一致的,即PopRec > AutoInt > FM。由于
product adoption中的 “富者更富” 效应,PopRec是一个鲁棒的基线。在大多数数据集上,
AutoInt的表现优于FM,因为multi-head self-attention机制具有更强的model attributes的能力。然而,在Meituan数据集上,AutoInt的性能比FM差。一个潜在的原因是,multi-head self-attention可能会从attributes中引入更多噪声,因为这些attributes是从美团平台的评论中提取的关键词。
一般来说,
non-sequential recommendation方法的性能比序列推荐方法差,因为在我们的任务中考虑序列模式(sequential pattern)很重要。有点不太符合预期,基于规则的、非个性化的
PopRec居然超越了AutoInt和FM。可能是因为模型的超参数没有优化好。对于序列推荐基线方法:
SASRec和BERT4Rec分别利用单向的和双向的self-attention机制,并且比GRU4Rec和Caser取得了更好的性能。这表明self-attention架构特别适合对序列数据进行建模。然而,在使用传统的next-item prediction loss进行训练时,它们的改进并不稳定。此外,
HGN取得了与SASRec和BERT4Rec相当的性能。这表明hierarchical gating network能够很好地对紧密相关的items之间的关系进行建模。但是,当直接将
attribute信息注入GRU4Rec和SASRec(即Yelp数据集上有性能提升,但在其他数据集上却产生负面影响。一个可能的原因是,简单地拼接item representations及其attributes representations无法有效地融合这两种信息。在大多数情况下,
FDSA在所有基线方法中取得了最佳性能。这表明feature-level self-attention blocks能够捕获到有用的sequential feature interaction patterns。
最后,通过将我们的方法与所有基线进行比较,可以明显看出,
S3-Rec在六个数据集上的表现始终优于它们,且优势明显。与这些基线不同,我们采用自监督学习来增强representations of the attribute, item, and sequence从而用于推荐任务,其中包含四个预训练目标,通过互信息最大化(MIM)对多种data correlations进行建模。这一结果也表明,自监督方法对于提高用于序列推荐的self-attention架构的性能是有效的。
1.3.2 进一步分析
接下来,我们继续研究
S3-Rec在更详细的分析中是否表现良好。消融研究:我们提出的自监督方法
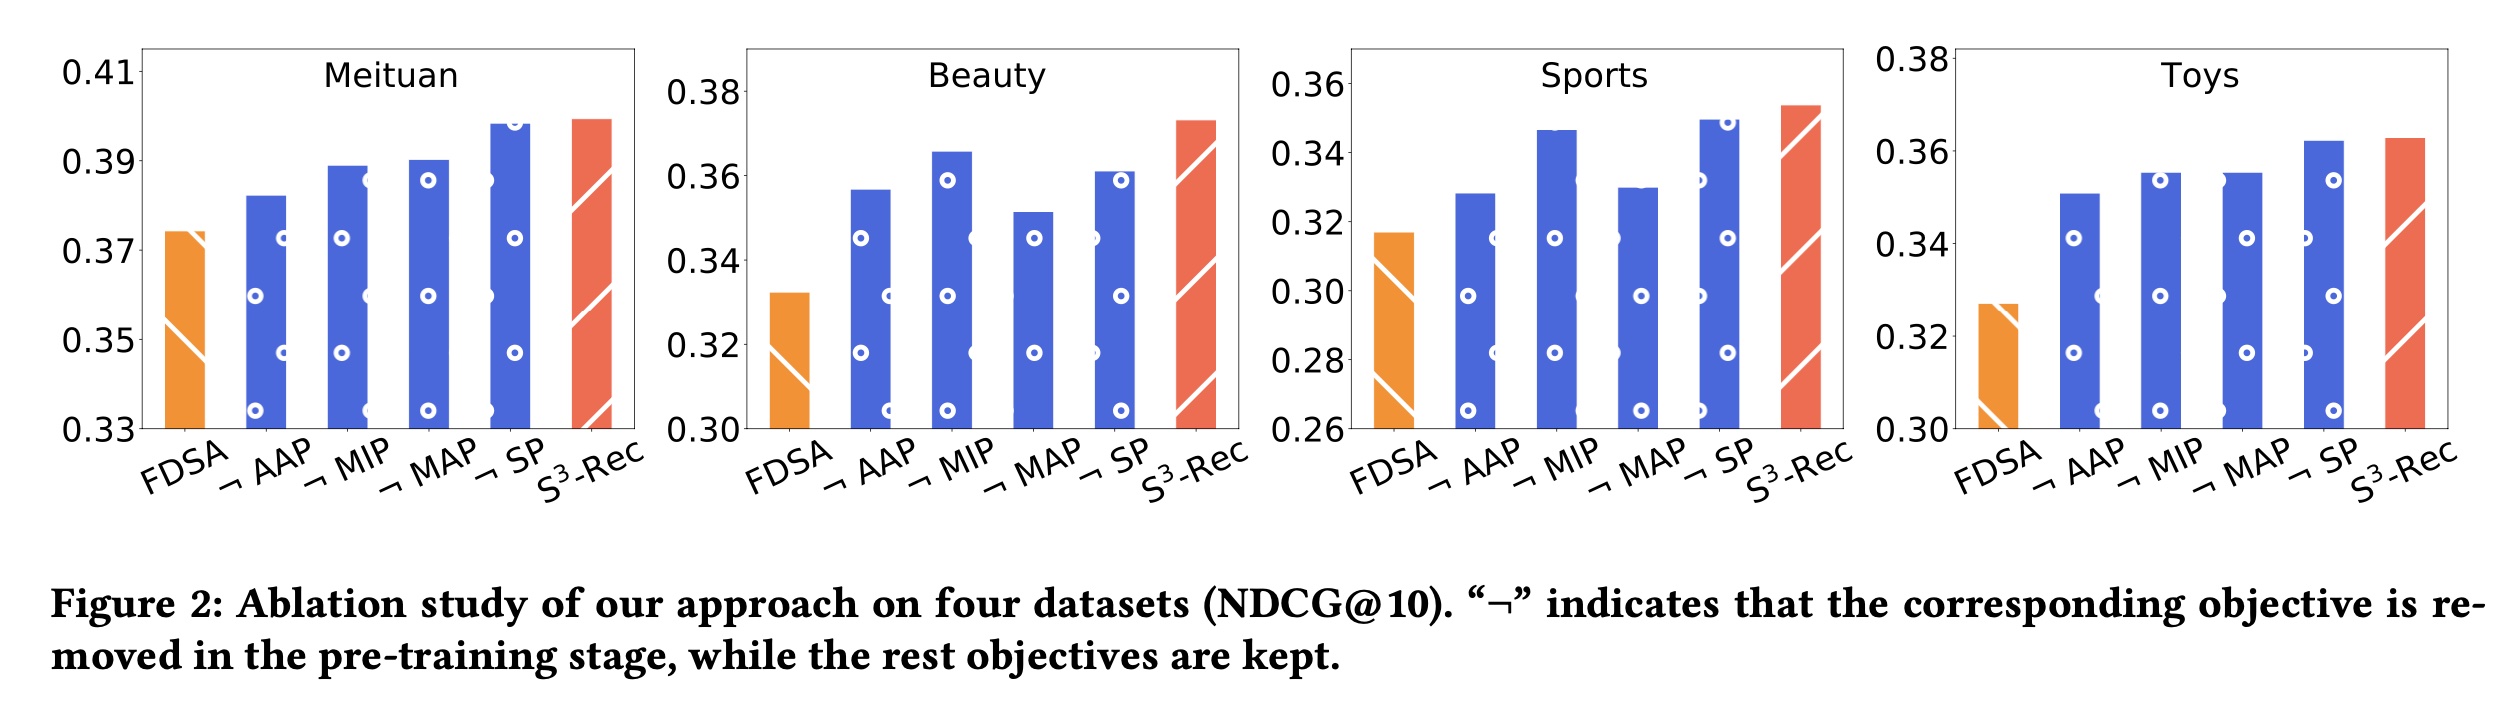
S3-Rec基于互信息最大化(MIM)设计了四个预训练目标。为了验证每个目标的有效性,我们在美团、美妆、运动和玩具数据集上进行消融研究,分析每个目标的贡献。本评估采用NDCG@10指标。同时还提供了最佳基线FDSA的结果作为比较。从
Figure 2的结果中,我们可以观察到:去除任何一个自监督目标都会导致性能下降。这表明所有目标都有助于提高推荐性能。
此外,这些目标的重要性在不同数据集上有所不同。总体而言,
AAP(Associated Attribute Prediction)和MAP(Masked Attribute Prediction)比其他目标更重要。在所有数据集上,去除这两个目标中的任何一个都会导致性能大幅下降。一个可能的原因是,这两个目标利用attributes信息增强了representations of item and sequence。
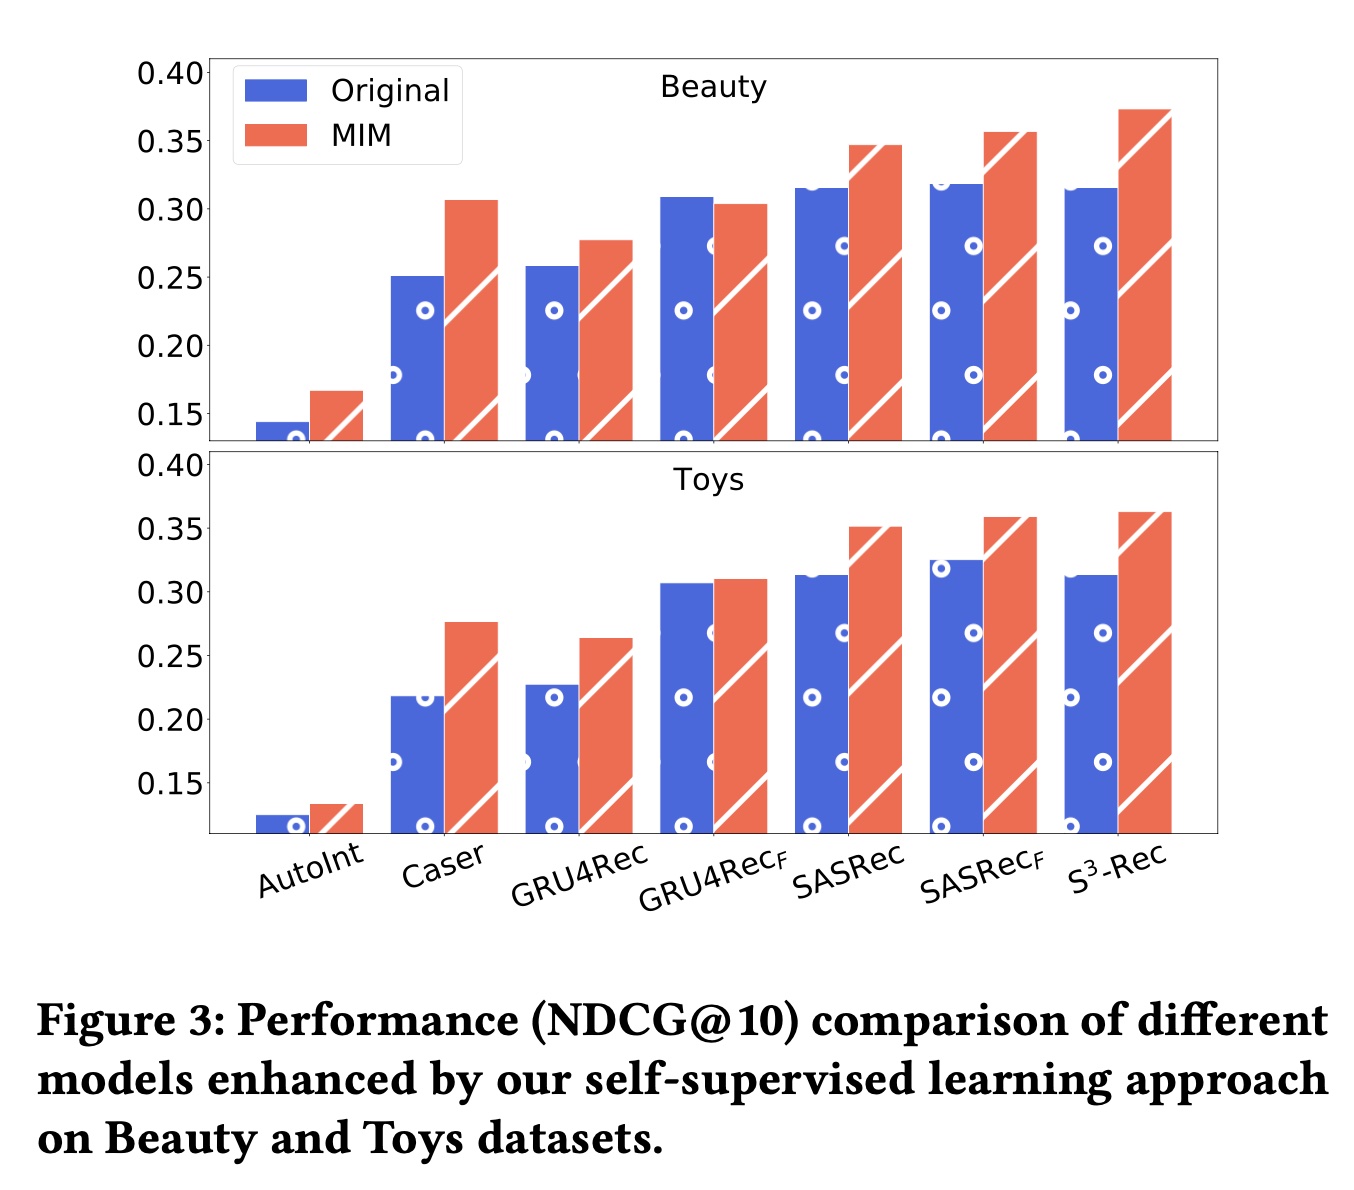
将自监督学习应用于其他模型:由于自监督学习本身是一种学习范式,它通常可以应用于各种模型。因此,在本部分中,我们进行了一项实验,以检验我们的方法是否能为其他模型带来改进。我们使用自监督方法在美妆和玩具数据集上对一些基线模型进行预训练。对于
GRU4Rec、SASRec和GRU4Rec和SASRec是单向模型,因此在预训练阶段我们维持单向的encoder layer。对于AutoInt和Caser,由于它们的架构不支持某些预训练目标,我们仅利用pre-trained parameters来初始化embedding layers的参数。美妆和玩具数据集上
NDCG@10的结果如Figure 3所示。首先,经过我们的方法预训练后,所有基线模型都取得了更好的性能。这表明自监督学习也可以应用于提高它们的性能。
其次,
S3-Rec在预训练后优于所有基线模型。这是因为我们的模型采用了在预训练阶段中的双向Transformer encoder,更适合我们的方法。第三,我们可以看到
GRU-based的模型的改进程度比其他模型小。一个可能的原因是RNN-based的架构限制了自监督学习的潜力。
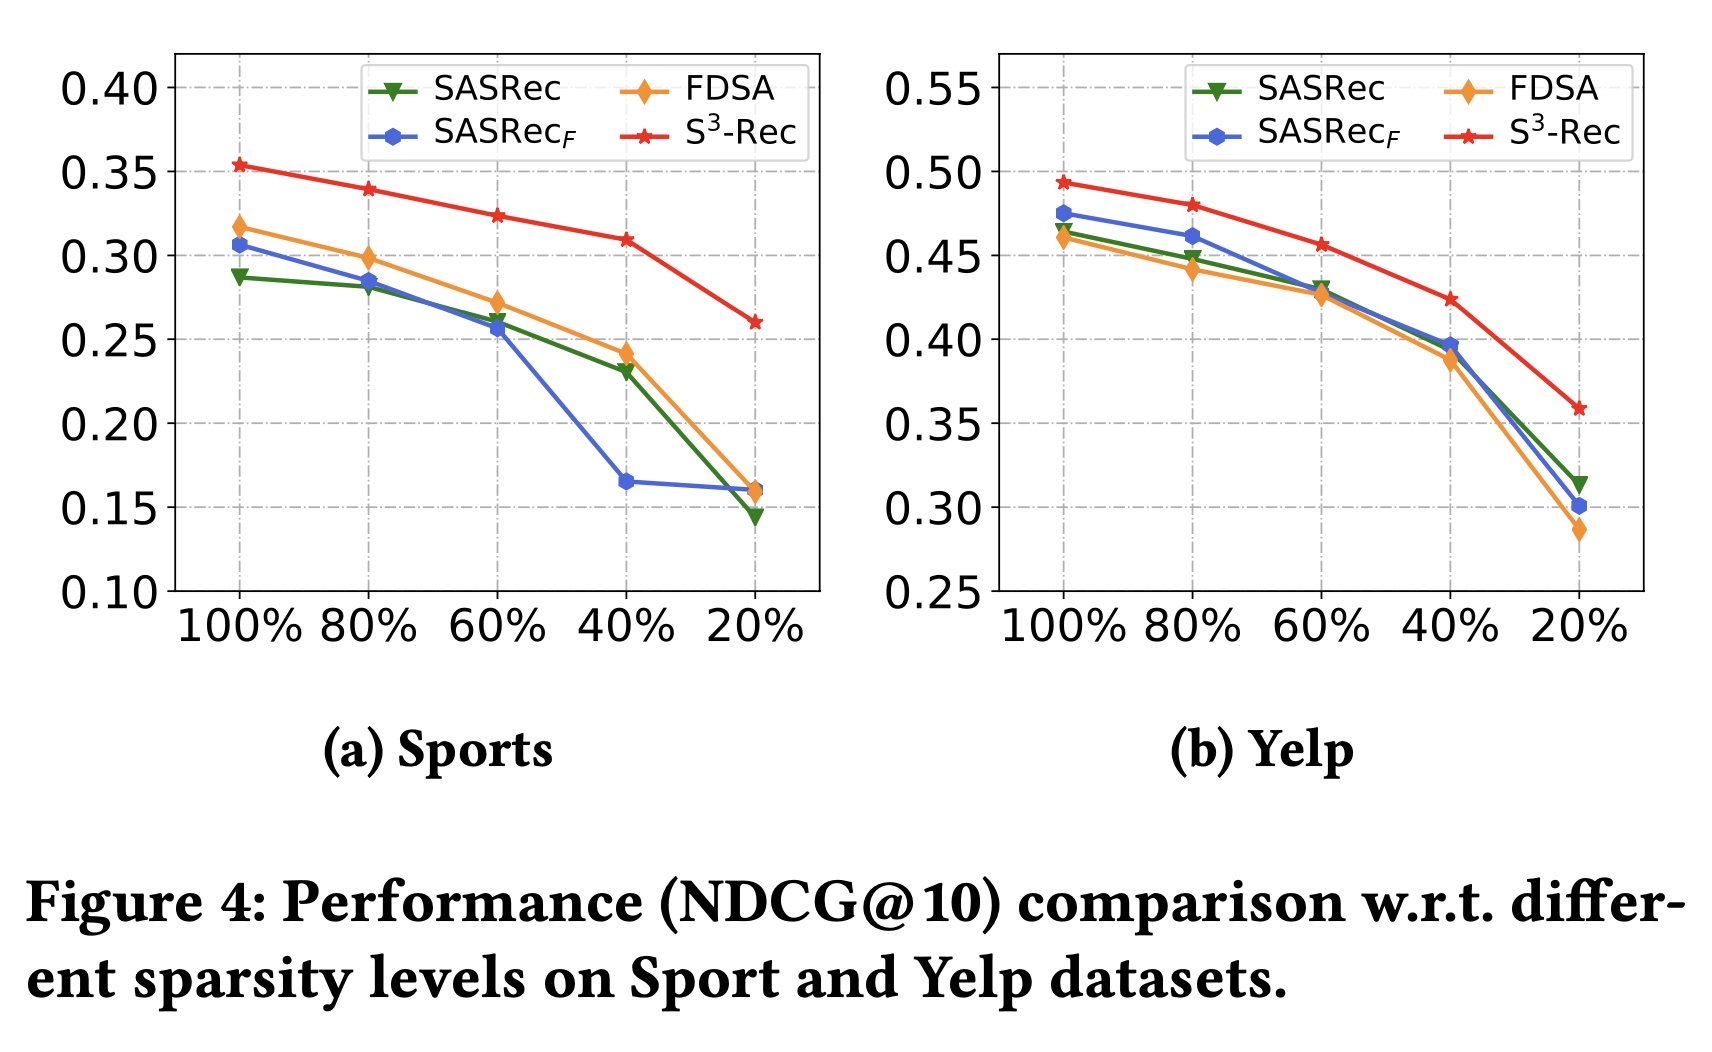
不同训练数据量下的性能比较:传统的推荐系统需要大量的训练数据,因此在实际应用中可能会受到冷启动问题的影响。我们的方法可以缓解这个问题,因为所提出的自监督学习方法可以更好地利用输入中的
data correlation。我们通过使用完整数据集的不同比例(即20%、40%、60%、80%和100%)来模拟数据稀疏场景。Figure 4展示了在运动和Yelp数据集上的评估结果。正如我们所见,当使用较少的训练数据时,性能会大幅下降。
然而,
S3-Rec在所有情况下都始终优于基线,尤其是在极端稀疏水平(20%)下。这一观察结果表明,S3-Rec能够通过自监督方法更好地利用数据,在一定程度上减轻了序列推荐中数据稀疏问题的影响。
不同预训练
epochs下的性能比较:我们的方法包括预训练阶段和微调阶段。在预训练阶段,我们的模型可以学习enhanced representations of the attribute, item, subsequence, and sequence从而用于推荐任务。预训练epochs会影响推荐任务的性能。为了研究这一点,我们使用不同的预训练epochs对模型进行预训练,并在推荐任务上进行微调。Figure 5展示了在美妆和玩具数据集上的结果。水平虚线表示without pre-training时的性能。我们可以看到:我们的模型在first 20 pre-training epochs中受益最大。之后,性能提升幅度较小。基于这一观察结果,我们可以得出结论,通过少量的预训练
epochs,我们的自监督学习方法可以很好地捕获不同视图(即the attribute, item, subsequence, and sequence)之间的相关性。因此,enhanced data representations可以提高序列推荐的性能。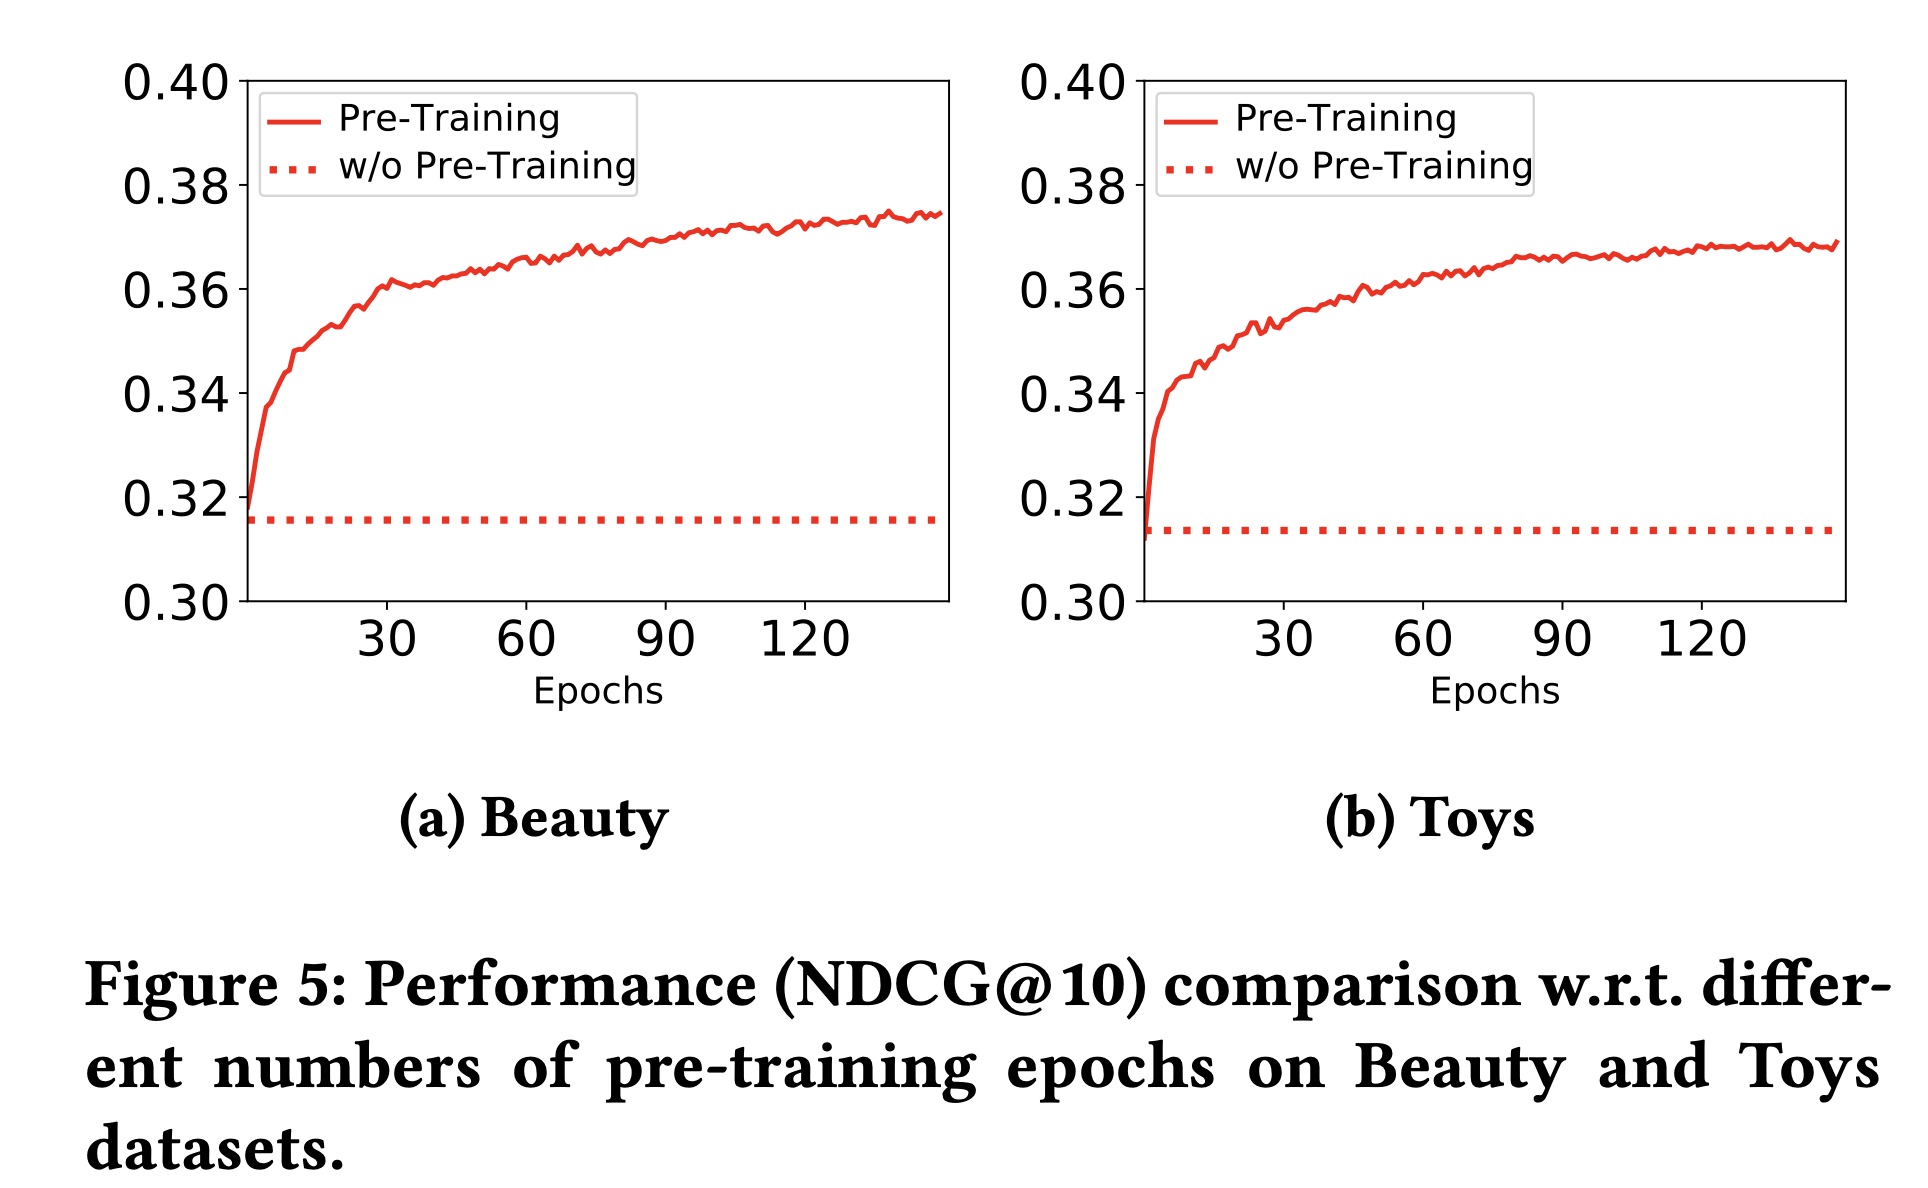
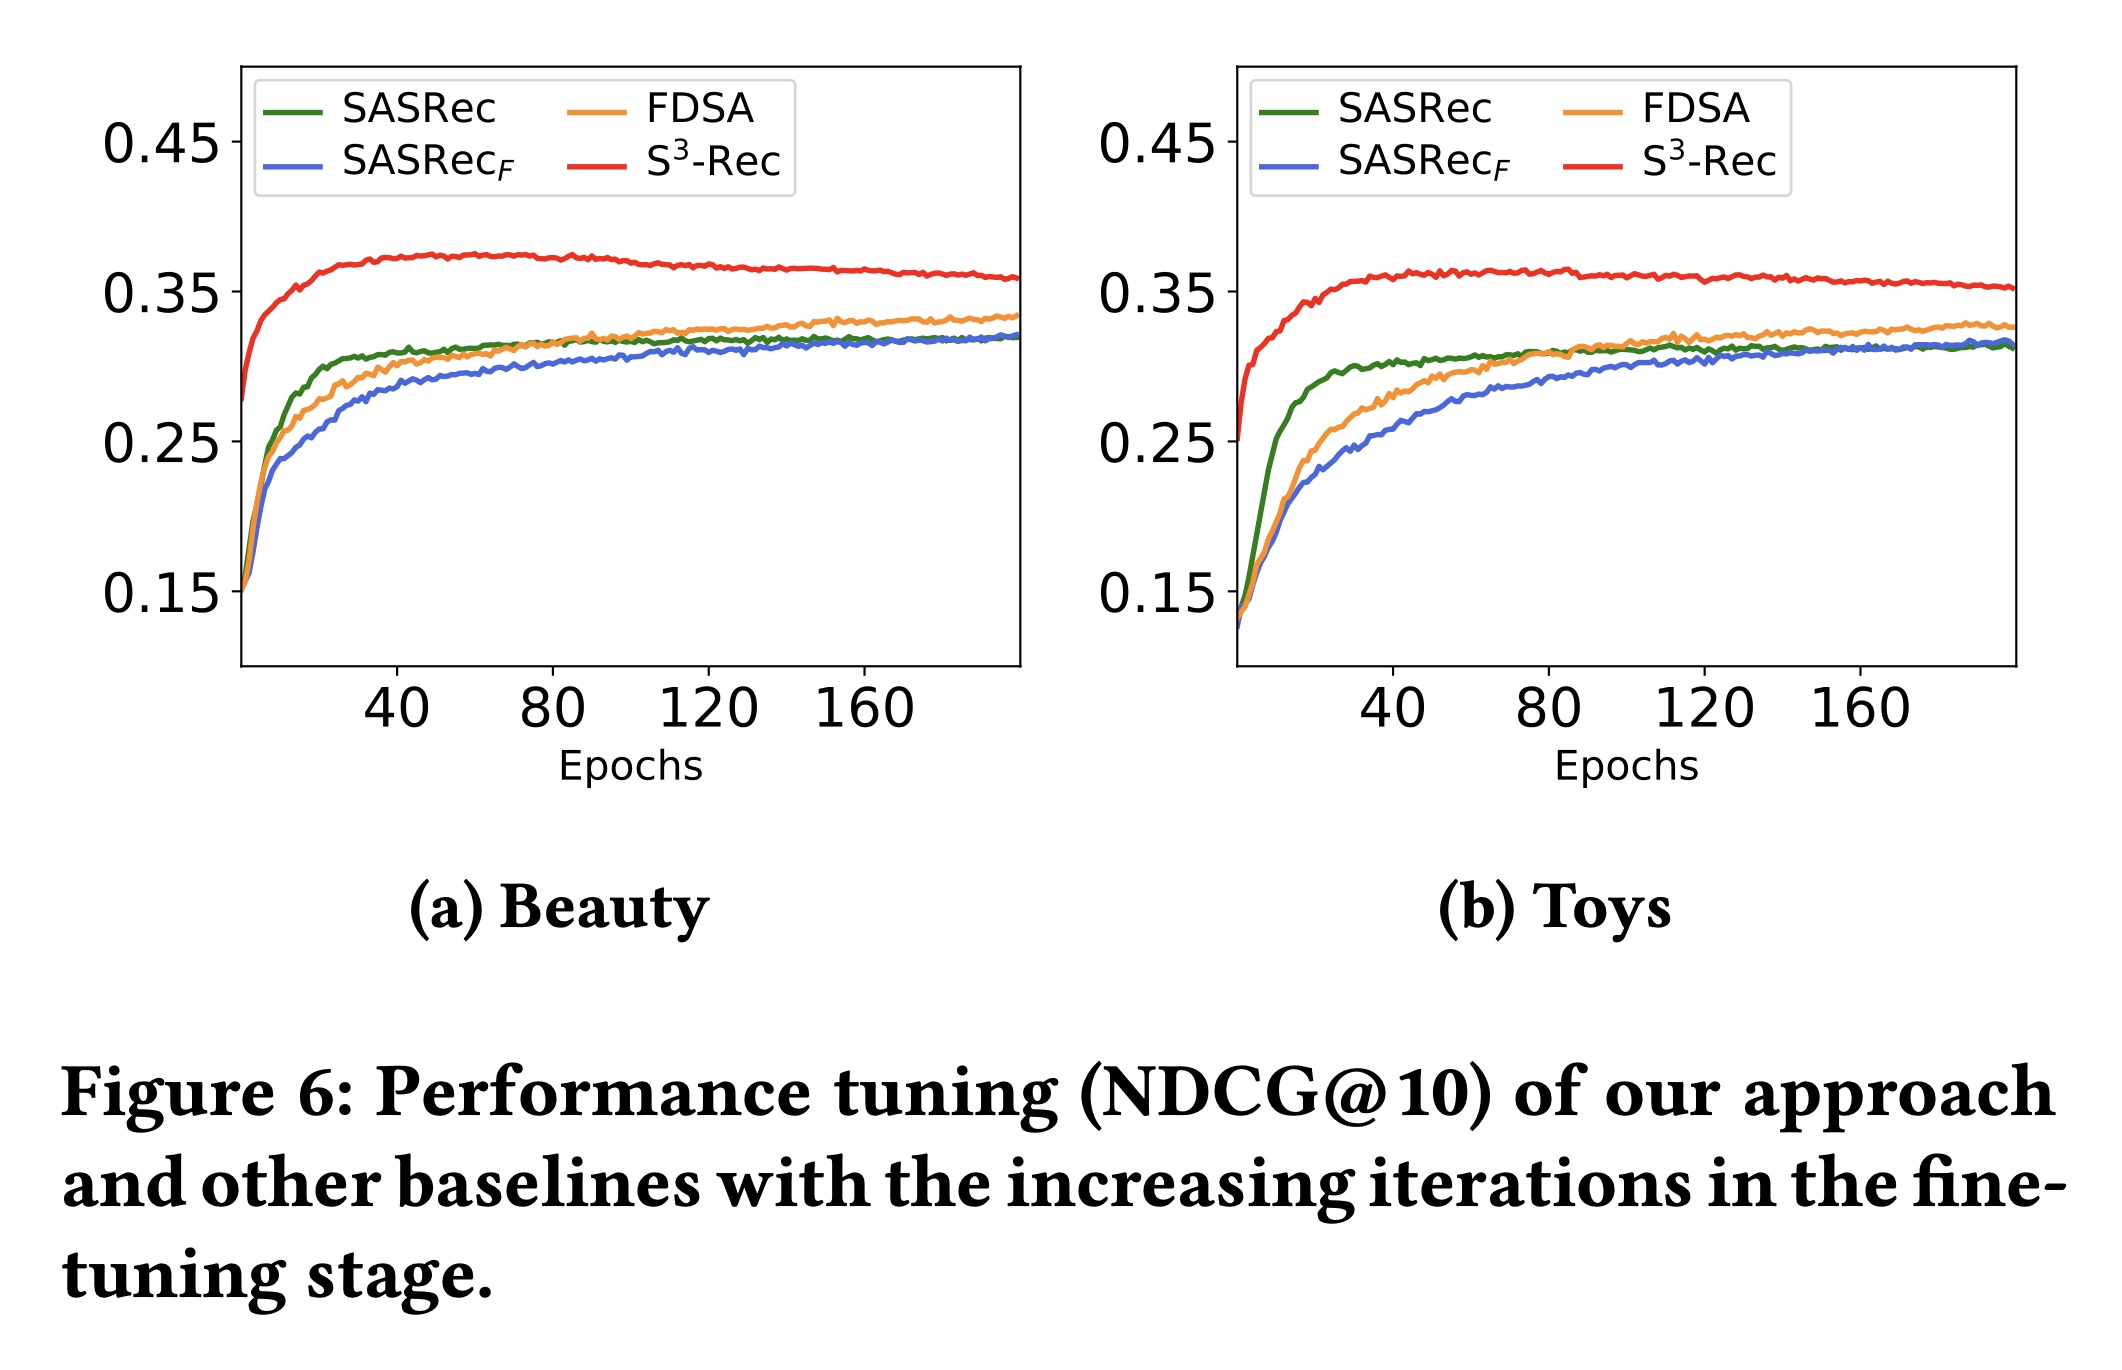
收敛速度比较:在获得
attribute, item, and sequence的enhanced representations后,我们在推荐任务上对模型进行微调。为了检验在最终推荐任务上的收敛速度,我们逐渐增加微调阶段的epochs,并比较我们的模型和其他基线模型的性能。Figure 6展示了在美妆和玩具数据集上的结果。可以观察到:我们的模型收敛速度快,在大约40 epochs后达到最佳性能。与我们的模型相比,基线模型需要更多epochs才能达到稳定性能。这一结果表明,我们的方法可以利用
pre-trained parameters帮助模型更快收敛并取得更好的性能。