一、SUM [2024]
《Scaling User Modeling: Large-scale Online User Representations for Ads Personalization in Meta》
有效的
user representations在个性化广告中至关重要。然而,对training throughput、serving latency和memory的严格约束,通常限制了在线广告排序模型的复杂度和input feature set。这一挑战在Meta这样的大型系统中被放大,该系统包含数百个具有不同规格的模型,使得为每个模型定制user representation learning并不实际。为应对这些挑战,我们提出了Scaling User Modeling: SUM,这是一个已广泛部署在Meta广告排序系统中的框架,旨在促进跨数百个广告模型的高效且scalable的sharing of online user representation。SUM利用少数指定的upstream user models,通过先进的建模技术从海量user features中合成user embeddings。这些embeddings随后作为downstream online ads ranking models的输入,促进高效的representation sharing。为适应user features的动态特性(dynamic nature)并确保embedding freshness,我们设计了SUM Online Asynchronous Platform: SOAP,这是一个无延迟的online serving系统,辅以model freshness和embedding stabilization,使得能够在每个user request时进行频繁的user model updates和online inference of user embeddings。我们分享了SUM框架的实际部署经验,并通过全面实验验证了其优越性。迄今为止,SUM已部署到Meta数百个广告排序模型中,每天处理数千亿次user requests,产生了显著的在线指标增益并提升了基础设施效率。Personalization是现代在线广告的基石,既提升广告主回报,也提升用户体验。personalization的核心是user understanding,这在传统上依赖人工的engineered features和简单的架构。基于深度学习的推荐系统的出现改变了这一范式,利用复杂神经网络模型学习错综复杂的user representations。然而,training throughput、serving latency和host memory等实际约束限制了它们充分利用大量用户数据的能力。在Meta这样的大型系统中,该系统包含许多不同模型,每天处理数千亿次user requests,这些局限性更加明显,导致effective user representation learning中出现若干相互关联的挑战:Sub-optimal Representations:模型独立地学习user representations往往产生较差结果。Feature Redundancy:跨模型重叠的user features导致training pipelines中不必要的duplication,带来高存储开销。Data Scarcity for Specialized Models:服务小众细分市场的模型缺乏robust user understanding所需的大量训练数据。Intensive Tailoring:为每个模型的specific performance needs而定制架构和feature selection是不可扩展的。
解决这些挑战对于支持日益增长的
user modeling的复杂度,并高效地将representation learning进展扩展到众多模型至关重要。为应对这些挑战,我们引入了
Scaling User Modeling: SUM,这是一个在Meta Ads中革新user modeling的在线框架。SUM旨在利用先进建模技术,同时遵守实际约束,并促进跨模型的高效的、可扩展的representation sharing。SUM采用upstream-downstream范式(Figure 1),灵感来自近期user history modeling工作(《Pinner-Former: Sequence Modeling for User Representation at Pinterest》、《Practice on Long Sequential User Behavior Modeling for Click-Through Rate Prediction》、《General-Purpose User Embeddings Based on Mobile App Usage》)。我们的方法包括训练少量的large-scale upstream user models,采用复杂架构,在diverse supervisions下,如clicks和conversions。user models处理大量user-side signal (features),以合成紧凑的user embeddings (representations)。这些embeddings随后被无缝集成到各种downstream production models中,传播先进的user modeling和representation sharing。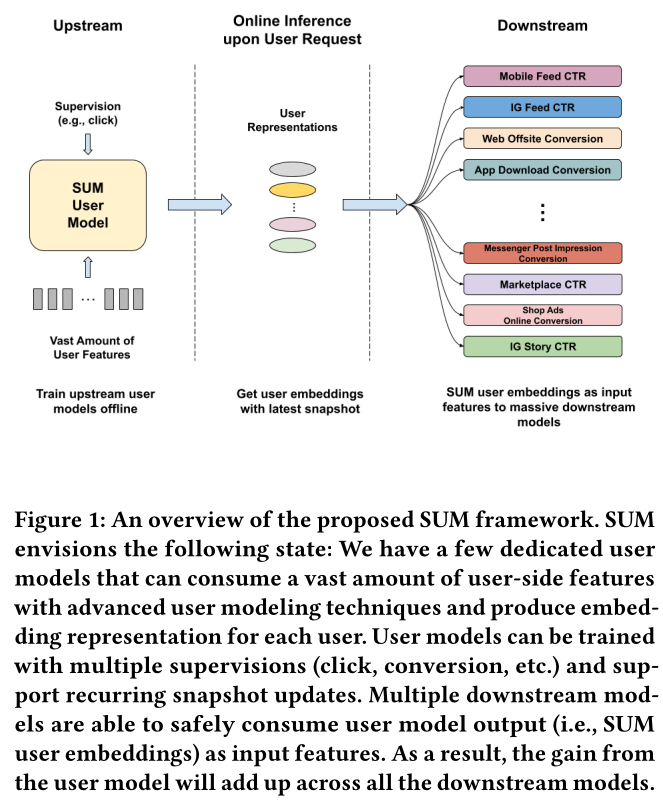
SUM的一个关键设计是其对user features的dynamic nature的适应性。我们的serving系统,SUM Online Asynchronous Platform: SOAP,是一个关键组件,支持无延迟且异步的serving,实现embedding freshness,同时克服latency limit,无论模型复杂度如何,大幅超越传统基于离线的解决方案。与SOAP互补,我们设计了a recurrent training regimen,并通过均值池化技术来增强,以保持model freshness并稳定user embeddings。自首次部署以来,
SUM已部署到Meta数百个production ads ranking models中,在离线和在线业务指标上均带来显著提升。其有效性和适应性也促使其扩展到Meta的feed models和quality models。本文主要贡献如下:我们提出
SUM,一个在线user modeling框架,专注于在production constraints内最优利用所有现有user features和复杂模型,并将representation learning扩展到数百个模型。我们详细介绍了一个大规模用户模型架构,对于从大量
input user features中学习有意义的user representations至关重要,该架构作为SUM模型的骨干。我们提出
SOAP,一个无延迟的在线serving系统设计,平衡feature freshness与serving constraints,超越离线解决方案并增强可扩展性。我们提供广泛实验研究和部署
SUM的实际见解,包括如均值池化等策略,以缓解频繁模型更新带来的embedding distribution shifts。
1.1 相关工作
Personalization一直处于广告排序和推荐系统研究的前沿。人们已经提出了大量建模技术来为用户提供定制化的广告。Factorization Machines(《Factorization Machines》、《Factorization Machines with LibFM》)使用矩阵分解(matrix factorization)将高维稀疏特征转换为低维向量。Collaborative Filtering(《Empirical Analysis of Predictive Algorithms for Collaborative Filtering》、《Factorization Meets the Neighborhood: A Multifaceted Collaborative Filtering Model》、《Item-Based Collaborative Filtering Recommendation Algorithms》)利用similar users and items的模式来预测用户的personalized recommendations。
深度学习的普及使现代广告排序模型和推荐系统能够从大规模数据集中学习高阶的和非线性的
interactions(《Wide & Deep Learning for Recommender Systems》、《DeepFM: A Factorization-Machine Based Neural Network for CTR Prediction》、《Neural Collaborative Filtering》、《Deep & Cross Network for Ad Click Predictions》、《DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-Scale Learning to Rank Systems》)。诸如Recurrent Neural Networks: RNNs(《Sequential User-Based Recurrent Neural Network Recommendations》)、Transformers(《Pinner-Former: Sequence Modeling for User Representation at Pinterest》、《TransAct: Transformer-Based Realtime User Action Model for Recommendation at Pinterest》)和Graph Neural Networks: GNNs(《TwHIN: Embedding the Twitter Heterogeneous Information Network for Personalized 》、《Recommendation Billion-Scale Commodity Embedding for E-Commerce Recommendation in Alibaba》)等前沿模型进一步推进了personalization的深度和广度。尽管如此,严格的
infrastructural constraints通常限制在线模型中模型架构的复杂度和user features的范围,抑制最优user representation。因此,工业界采用了embedding-based的方法,利用upstream-downstream范式。upstream model通常离线被训练和更新,以生成condensed embeddings。这些
condensed embeddings将作为downstream online production models的输入特征被消费。
这样,
latency constraints被放宽,允许更大的模型复杂度。embeddings主要包括item embeddings和user embeddings。对于
item embeddings:来自
Twitter的TwHin(《TwHIN: Embedding the Twitter Heterogeneous Information Network for Personalized Recommendation》)从a heterogeneous knowledge graph中推导embeddings,捕获用户、推文和广告的细微差别。来自
Pinterest的PinSage(《Graph Convolutional Neural Networks for Web-Scale Recommender Systems》)结合random walks与graph convolutions来学习graph node embeddings。Airbnb(《Real-Time Personalization Using Embeddings for Search Ranking at Airbnb》)提取listing embeddings以改善search ranking,这些embeddings离线被预计算并每日存储,以便online serving期间实时可用。ItemSage(《ItemSage: Learning Product Embeddings for Shopping Recommendations at Pinterest》)利用transformer-based架构从多模态中学习product embeddings,计算成本高昂。它采用offline serving方案,执行每日batch inference。
鉴于
item features固有的稳定性,此类offline serving方案带来的embedding staleness仍然可以接受。但对于SUM使用的user features,它显著损害user embedding性能,如后续章节所讨论,这使得确保embedding freshness对SUM productionization至关重要。对于
user embeddings:来自
Pinterest的PinnerFormer(《Pinner-Former: Sequence Modeling for User Representation at Pinterest》)建模user sequences,依赖a daily offline batch setting以减少infra pressure。腾讯
《General-Purpose User Embeddings Based on Mobile App Usage 》学习user app usage embeddings,并为active users每日更新,而upstream model更新频率低得多,以避免embedding distribution shift及相应downstream model更新。阿里
《Practice on Long Sequential User Behavior Modeling for Click-Through Rate Prediction》通过end-to-end learning来挖掘long-term user behavior,将user modeling部分与整个模型解耦,并存储最新user embeddings以便在线轻松访问。user embedding updates由user behavior events触发,而非traffic request触发。
先前研究主要集中于学习
user history behavior,并额外努力构建和维护user-centric behaviors的data pipelines。而本工作专注于探索一种可行解决方案,以支持日益增长复杂度的user modeling,这种复杂度无法直接添加到production ads models中,并在大规模广告排序系统中高效扩展user representation sharing。
1.2 模型架构
本节中,我们介绍上游
SUM用户模型的设计。
1.2.1 预备知识
如
Figure 2所示,SUM user model利用广受认可的DLRM架构(《Deep Learning Recommendation Model for Personalization and Recommendation Systems》)。它分为两个主要组件:user tower和mixed tower。user tower处理广泛的user-side input features,将其转换为a refined set of SUM user embeddings。这些embeddings随后被传送到mixed tower,在那里它们与广告相关的其他类型特征进一步交互。本质上这是一种
Model Split方案,将一个模型拆分为两个部分:一部分是
user-dependent,这部分就是SUM的主体。它依赖于user profile和user history actions,但是不依赖于context和target item。这使得这部分可以near real-time来inference,从而节省latency。另一部分是
target item相关的(包括context)。这部分依赖于实时的request,并实时inference。
好处是这一套
online user representation可以共享到多个场景。缺点是,user-item feature cross是late cross,导致模型的表达能力有所欠缺。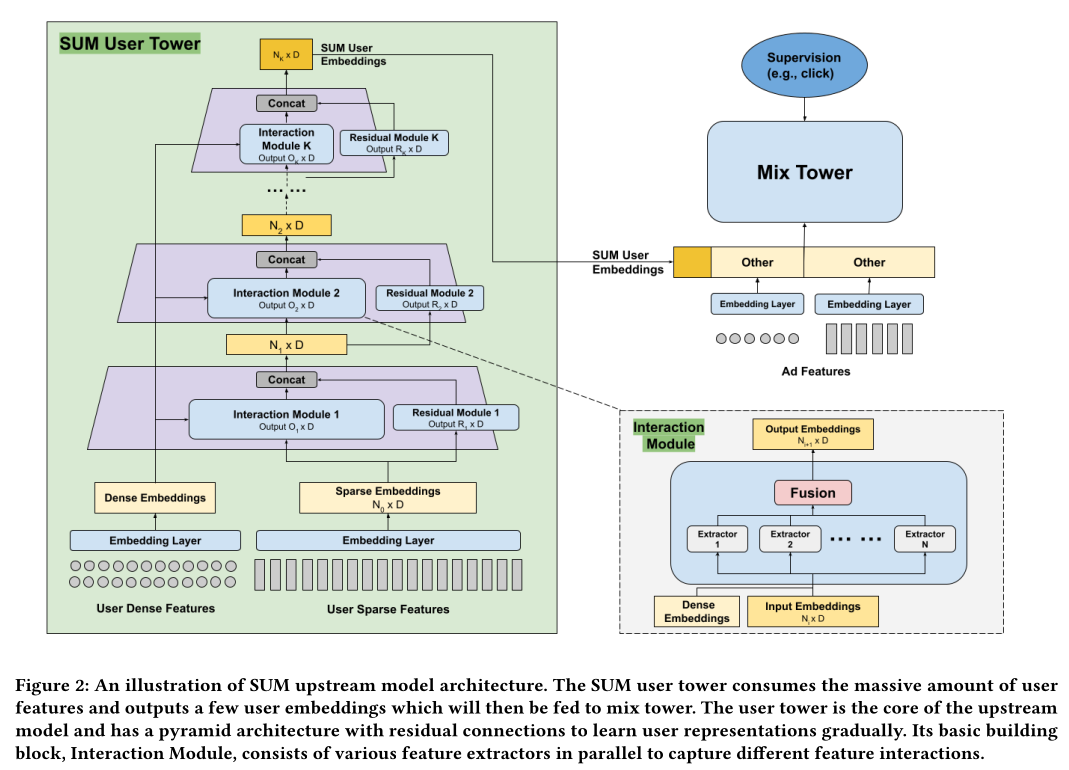
我们将
input user features分为两大类:dense和sparse。dense features是数值变量或连续变量,例如某页面的点击频率。sparse features通常是具有高基数的categorical变量或二元变量,包括user ID和page ID。这些sparse features是存储密集型和计算密集型,需要具有极大参数量的embedding lookup tables来将原始值映射到dense embeddings。
标准模型通常处理少于
300 user sparse features,而更紧凑的模型限制在100以下。相比之下,SUM user models显著更广,容纳多得多的user features,远超下游模型所管理的特征。
1.2.2 User Tower
user tower采用类似金字塔的结构,通过连续的Interaction Modules有条理地压缩这些input features。应用Residual connections(《Deep Residual Learning for Image Recognition》)以促进训练并保留原始信息。在dense features和sparse features通过initial embedding layers后,假设我们有sparse embeddings和dense embeddings,user tower将它们合并为output user embeddings,其中对于第
Interaction Module,其中:
Interaction、Residual分别表示Figure 2中的Interaction Module和Residual Moddule。Interaction Module的输入。sparse embeddings。注意,对于每一层的
sparse embeddings,而不包含dense embeddings。initial embedding layer后的raw dense embeddings。
这里
output user embeddings进行交互。Residual Moddule通常是MLP。Interaction Module集成多个并行的feature extractors,旨在捕获一系列complementary interactions。feature extractor有不同选项,部分列出如下。MLP:它用于学习通用的非线性low-level implicit representations。Dot Compression with Attention:Compressing the pairwise dot product matrix是提高模型容量和效率的有效方式。我们结合带attention和residual connections的先进dot compression来学习high-level explicit representations,公式为:其中:
input size以提高模型效率。对于
dense features,对于
sparse features,sparse embeddings的一组加权和。这里的
sparse embeddings。
attention权重,residual分支。
Deep Cross Net:DCN(《Deep & Cross Network for Ad Click Predictions》、《DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-Scale Learning to Rank Systems》)通过有效的explicit feature crosses和implicit feature crosses来学习expressive representations。其基本组件是cross layer,可由以下公式说明。其中:
bias。通过堆叠多个
cross layers,模型可以捕获高阶verctor-level and bit-level interactions。MLP-Mixer:MLP-Mixer(《MLP-Mixer: An all-MLP Architecture for Vision》)是一种全MLP架构,最初为计算机视觉而设计。该架构可视为一种独特的CNN,使用1x1卷积进行channel mixing,并使用single-channel depth-wise convolutions进行token mixing,分别如下公式所示:这里的乘积是矩阵乘积。
其中:
1.2.3 Mix Tower
mix tower采用DHEN风格架构(《DHEN: A Deep and Hierarchical Ensemble Network for Large-Scale Click-Through Rate Prediction》)。除了来自user tower的SUM user embeddings外,它不包含任何user-side features作为输入。这一战略设计选择旨在提升upstream training throughput,并鼓励模型主要通过user tower来refine user representations。我们的经验表明,更复杂的mix tower架构虽然显示出更强的upstream model预测性能,但不会给user embeddings质量带来显著改善,也不会产生downstream收益。我们利用
a multi-task cross-entropy loss:其中:
final loss中的重要性。
1.3 Online Serving System: SOAP
与
《ItemSage: Learning Product Embeddings for Shopping Recommendations at Pinterest》、《TwHIN: Embedding the Twitter Heterogeneous Information Network for Personalized Recommendation》、《Graph Convolutional Neural Networks for Web-Scale Recommender Systems》使用的相对稳定的item features相比,SUM user tower中的user features经常剧烈变化。相当一部分这些特征是categorical变量,面临the introduction of new ids和shifting semantic meanings of existing ids的挑战。在这种情况下,offline-based serving的方案,无论是batch inference(《ItemSage: Learning Product Embeddings for Shopping Recommendations at Pinterest》、《Pinner-Former: Sequence Modeling for User Representation at Pinterest》)还是event-triggered inference(《Practice on Long Sequential User Behavior Modeling for Click-Through Rate Prediction》),其embedding staleness都会不利地影响downstream性能,如实验章节所讨论。因此我们决定在每次user request时在线推理user embeddings。然而,online inference的latency budget通常很紧张。通常,一旦收到user request,只有30ms窗口来执行推理并将user embeddings转发给downstream ranking models,从而限制user model的复杂度,并进而限制SUM user embeddings的representative power。为应对上述挑战,我们设计了
SUM Online Asynchronous Platform: SOAP,它利用一种新颖的异步服务范式,专为SUM online inference而定制。如Figure 3所示,当downstream model收到user request时,SOAP Compute Center使用latest snapshot来计算current embedding,随后将其写入Feature Store。同时,客户端立即从Feature Store读取该用户的previous embeddings,并将average pooled embedding转发给downstream model,而不等待Compute Center’s inference结束。这样,SOAP将feature write path与read path解耦。current embedding的计算和更新作为异步调用被触发。通过将昂贵的且latency-intensive的write path与read path分离,异步服务有效消除了latency limit,理论上可支持inference latency任意长的复杂用户模型(实践中,inference latency仍会成比例影响serving功耗,但不再是hard blocker)。它显著优于offline-based的方法,同时牺牲少量实时性以提升scaling潜力,从而产生更好的ROI,如实验章节详述。为进一步减少
inference时间,SOAP中仅serveSUM user model的user tower以生成user embeddings,而不是serve整个模型。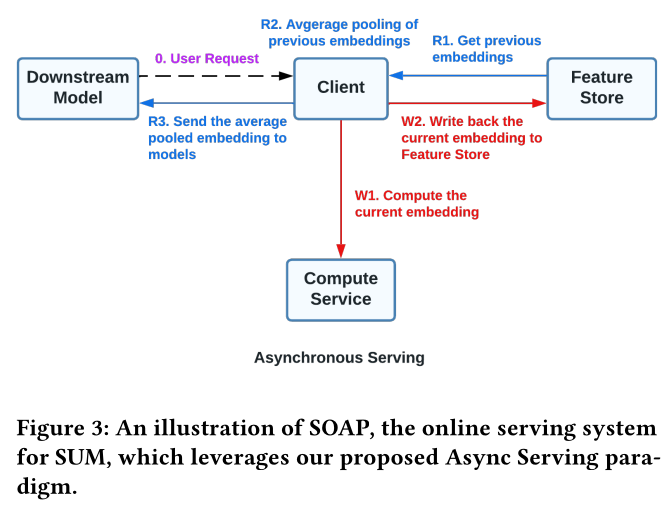
1.4 Productionization
Model Training:SUM user model以recurring的方式离线训练,这使模型能够保留historical patterns,同时增量地适应user preferences的演变。这种频繁的snapshot发布,结合online inference,使SUM能够持续向downstream models提供最新的user embeddings。“
recurring训练” 指的是周期性、滚动式的离线训练:不是只训练一次就固定不动,而是按照固定节奏(如每天)用最新数据重新训练或继续训练SUM用户模型,并发布新的模型快照(snapshot),供线上推理使用。Embedding Distribution Shift:然而,随着recurring training,user model不断发布new snapshots。这意味着即使对于相同的inference input,computed user embeddings也会随时间变化。我们称这一现象为"embedding distribution shift"。如实验章节所示,它显著损害user embeddings的有效性。有两种选项可以缓解embedding distribution shift。Option 1:一种是确保新版本的embedding features在inference中被使用之前,已被downstream models在训练中见过。此选项需要改变model training、model serving和feature logging,给我们的系统带来额外复杂性。Option 2:另一种是通过强制新版本与先前版本是相似的,从而减少distribution shift。这可以通过各种方式完成,例如正则化(《TwHIN: Embedding the Twitter Heterogeneous Information Network for Personalized Recommendation》)、蒸馏和post processing with average pooling。
我们提出通过将最近
2个cached embeddings和当前computed embedding进行均值池化,作为该用户final current embedding来缓解此问题。均值池化在广告排序和推荐系统中已被广泛采用,尤其用于应对冷启动问题(《On the Consistency of Average Embeddings for Item Recommendation》、《Real-Time Personalization Using Embeddings for Search Ranking at Airbnb》、《Billion-Scale Commodity Embedding for E-Commerce Recommendation in Alibaba》)。我们选择此选项,因为它成本低、带来良好性能,并免费增加feature coverage。Feature Storage Optimization:在生产中,我们通常配置2 SUM user embeddings,每个维度为96。在研究了feature storage efficiency之间具有良好的ROI。为进一步减少online and offline storage use,两个user embeddings从fp32被量化到fp16;我们评估了这种量化不会导致downstream performance差异。Distributed Inference:为解除SUM user model的内存约束以获得更多性能收益,我们为user tower引入了分布式推理(Distributed Inference: DI),使online inference工作负载能够有效分布在多个主机上。
1.5 实验
数据集:在本工作中,所有实验都在工业数据集上完成。我们没有使用公共数据集,因为将其应用到我们的
serving系统存在差距,且与内部模型的巨大差异使其不适合下游实验。评估指标:
Normalized Entropy:我们使用归一化熵(Normalized Entropy: NE)作为评估模型离线预测性能的指标。它衡量模型预测用户何时点击广告的准确程度。越低越好。其中:
label,impression点击的估计概率,而CTR。
Feature Importance Ranking:我们使用特征重要性排名(Feature Importance Ranking: FI) (《A feature selection based on perturbation theory》)来评估一个特征对模型的重要程度。user model所生成的SUM embeddings作为输入被馈送到各种production models。通过分析SUM embeddings与一个模型其他可用特征相比的FI ranks,我们可以理解SUM user embeddings的相对价值和影响。
FB CTR SUM User Model:在实践中,我们维护几个SUM user models,每个都在不同数据集和supervisions下训练。作为后续讨论的代表性例子,我们将聚焦于FB CTR SUM user model。FB CTR SUM user model利用Facebook mobile app feed的训练数据集,包含约每日6 billion的样本,并以CTR prediction任务为目标。user tower由四个顺序堆叠的Interaction Modules组成(即,MLP, Dot Compression with Attention, and the MLP-Mixer作为feature extractors。它处理约600 user-side sparse features和1,000 user-side dense features。结果,user tower占用160 GB大小,并需要390M inference FLOPs。
1.5.1 Downstream Offline Results
Table 1列出了FB CTR SUM在一些下游模型上的离线NE性能。从
Table 1可见,SUM embeddings在各种下游任务中带来统计显著的NE gain,例如CTR prediction、inline conversion prediction、mobile app install conversion prediction以及offsite conversion prediction in various domains。这强调了SUM强大的表征能力和泛化性。预期它们在CTR任务中显示更高增益,因为它们训练于CTR数据。一个特殊情况是
Instagram模型上相对较小的增益,突出需要Instagram SUM模型来弥合FB和Instagram之间的领域差异。此外,在
Messenger inbox等模型复杂度低和特征数量少的小模型上,large-scale user representation sharing的好处更为显著。
值得注意的是,
adding SUM embeddings给下游模型带来的training throughput或其他infra metrics change变化几乎可以忽略,因为embedding features是dense representations,不需要sparse features所需的计算密集型embedding look-up tables。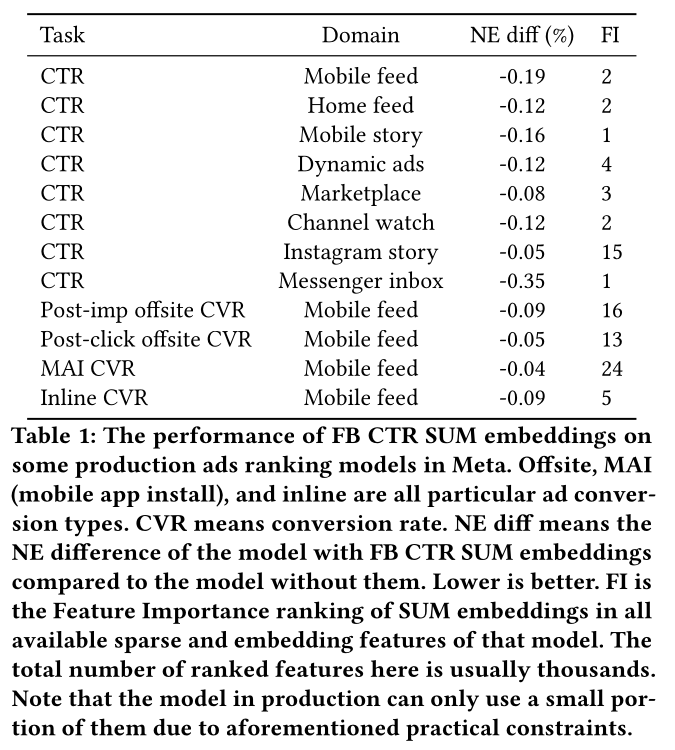
1.5.2 Online Performance
SUM已部署到Meta数百个production ads models,在离线和在线业务指标上取得显著增益,惠及IG、FAM、Shop Ads、Messenger Ads等不同平台。在线A/B测试显示,SUM总共带来2.67%在线广告指标增益(0.2%增益在内部可视为统计显著)。值得注意的是,在实现这些增益的同时,相比于直接将相同复杂度引入每个下游模型,SUM成功避免了15.3%的serving容量增加。
1.5.3 Async Serving
我们进行实验比较
4种不同serving方案。Frozen User Model:user model仅被训练一次,我们持续使用initial snapshot来评估新数据并生成user embeddings。此setting顺利工作的一个重要前提是仅消费稳定的content-based features作为input,而非short-lived ID features,这相当限制input feature space。鉴于我们当前
user model setup尝试利用所有现有user-side information而不区分stable features和non-stable features,frozen model setting可能无法达到user models的全部潜力。Offline Batch:初始训练完成后,user model每日recurring training。我们使用在(date - 1)上训练好的snapshot来评估(date)上的数据以生成user embeddings。通常有1天到3天的staleness,取决于下游模型的data pipeline设计。Online Real-time Serving:收到user request后,客户端从Compute Service获取当前embedding,并从Feature Store获取previous embeddings,然后转发average pooled embedding作为final current embedding给下游模型。如果Compute Service的inference未在规定延迟窗口内结束,则考虑a fallback。Online Async Serving:细节如1.3节所述。
为公平比较
real-time serving和Async serving,本组实验使用的user model是更紧凑版本,仅20M inference FLOPs,因为更大的模型会有非常高的fallback rates。结果见Table 2,显示将model serving从real-time转为Async仅造成平均10%损失,远小于从real-time转为offline batch setting的损失。此外,它为利用更复杂的user models铺平道路,强调Async Serving的好处。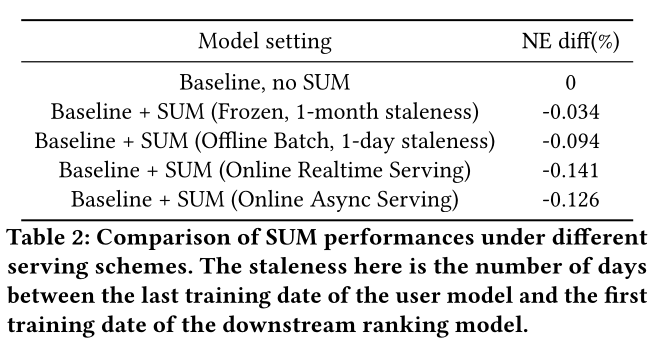
1.5.4 Embedding Distribution Shift
我们进行离线实验以理解
embedding distribution shift问题。这里SUM user model处于Offline Batch模式,以便更容易进行端到端实验,即我们对user model进行daily recurring training,并使用daily updated moving snapshots来dump user embeddings。考虑到user embeddings记为Embedding0和Embedding1。对于每个用户,我们比较连续日期embeddings之间的余弦相似度和L2范数变化,并在Table 3中报告平均值。附带说明,我们还发现Embedding1比Embedding0给下游模型带来更大的training NE增益,但Embedding0可以在Embedding1之上带来额外增益。理解为什么一个embedding比另一个更稳定,以及为什么更稳定的embedding带来更大training gains,不是本工作的重点。它可能是未来改进的潜在领域。采用均值池化之后(最近的
3个snapshot),Embedding 0/1的分布都更稳定了。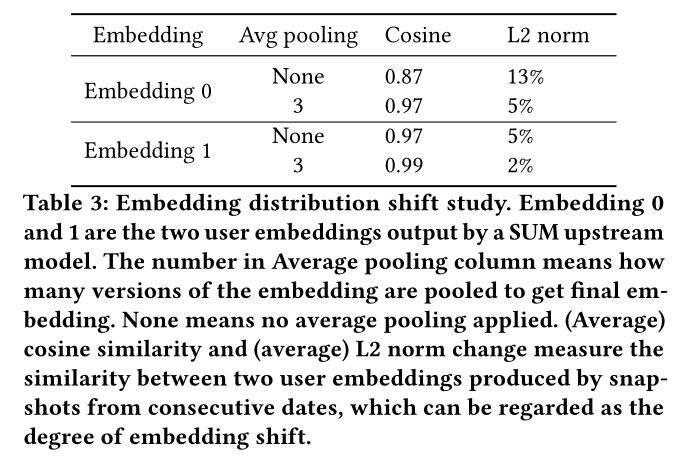
如
Table 4所示,无均值池化时,观察到良好的training NE增益,这意味着训练期间下游模型能够适应embedding distribution shift。然而,evaluation NE增益小得多,这是预期的:对于evaluation,embedding features由a new user model snapshot来生成,new version of embeddings未在下游模型训练中见过。突然变化导致更差的evaluation NE。Average pooling over 3 embeddings可以显著减少embedding shift并提高性能,尤其是在evaluation NE方面。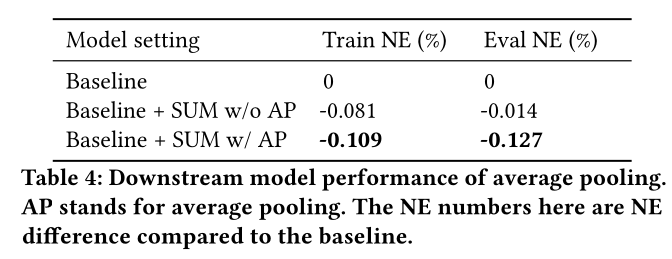
1.6 结论
本文提出
SUM,一个大规模在线个性化框架,使Meta的广告排序模型能够利用由少数SUM user models合成的强大user representations。我们创新的SOAP serving system促进SUM user embeddings的在线异步推理,辅以user model freshness和embedding stabilization。这不仅比offline serving方法增强了embedding freshness,还释放了潜力来采用更复杂用户模型。我们深入探讨部署SUM的挑战和最佳实践。实验结果及其在Meta内的成功部署证明了SUM的优越性。SUM已部署到Meta数百个production ads models,每天处理数千亿次user requests。我们相信,本工作提供了一条实用的、可扩展的且高效的路径,通过有效的user embedding sharing来改善ads personalization,并解决在线广告模型在training throughput、内存和serving功耗方面的固有限制。展望未来,我们渴望进一步改进user modeling算法和serving系统,以实现更细致的user representations。