一、TransAct V2 [2025]
《TransAct V2: Lifelong User Action Sequence Modeling on Pinterest Recommendation》
user action sequences建模已成为工业推荐系统研究中的热门焦点,特别是在点击率预测(CTR prediction)任务中。然而,工业规模的CTR模型通常依赖较短的用户序列,限制了其捕获long-term behavior的能力。此外,这些模型在point-wise排序框架中通常缺乏一个integrated action-prediction task,削弱了其预测能力。它们也很少涉及在高效地serving大规模序列模型中的基础设施挑战。在本文中,我们介绍了TransAct V2,这是一个用于Pinterest Homefeed推荐排序系统的生产模型,具有三项关键创新:(1):利用超长用户序列提升CTR预测。(2):集成Next Action Loss function以增强user action forecasting。(3):采用可扩展的、低延迟的部署方案,以适应extended user action sequences带来的计算需求。为克服延迟和存储限制,我们利用高效的数据处理策略和model-serving优化,实现了无缝的工业级部署。
我们方法的有效性通过消融研究得到进一步证实。此外,广泛的离线和在线
A/B实验证实了在包括engagement volume和推荐多样性在内的关键指标上的显著提升,展示了TransAct V2的实际影响力。在数字时代,推荐系统已成为在浩瀚的在线信息海洋中导航不可或缺的工具。通过提供个性化推荐,这些系统不仅提升了用户体验,还推动了各行业企业的
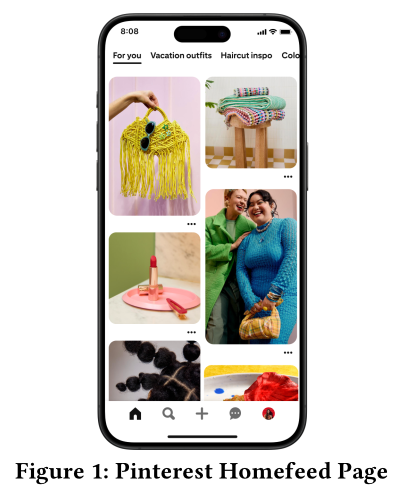
engagement增长和收入增长。Pinterest,一个领先的内容分享和社交媒体平台,充分体现了推荐系统的变革性力量。拥有数十亿的Pins和超过5亿月活跃用户的多样化用户群体,Pinterest Homefeed(如Figure 1所示)是灵感的主要来源,为用户提供高质量和相关性内容的推荐。首页(Homefeed)推荐系统使用三个阶段:召回(retrieval)、排序(ranking)和混排(blending)。当用户访问首页时:retrieval阶段首先根据用户的兴趣、画板(boards)和其他因素,从数十亿个Pins中召回数千个相关的Pins。然后,
ranking阶段被形式化为CTR预测任务,通过预测其personalized relevance从而对这些Pins进行排序。最后,根据业务需求对
ordered Pins进行混排。
尽管
user action history在CTR模型中被广泛使用,但现有方法通常难以端到端地利用lifelong user sequences进行training objectives优化。serving成本和延迟限制通常迫使模型只能使用较短的近期user action sequences(long-term behavioral patterns。最近尝试解决lifelong user sequences serving的方案要么涉及压缩(丢失信息),要么依赖昂贵的offline inference和caching(《TWIN: TWo-stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》、《TWIN V2: Scaling Ultra-Long User Behavior Sequence Modeling for Enhanced CTR Prediction at Kuaishou》)。此外,这些模型通常只编码user actions,缺乏为提升CTR准确性而进行next-action prediction所需的表达能力。在本文中,我们提出了
TransAct V2,这是一个在CTR预测框架内整合real-time user squence和lifelong user sequence的新颖模型。通过采用新的next-action prediction任务,TransAct V2增强了对用户偏好的理解并提高了推荐多样性。我们的系统设计能够高效处理完整的lifelong sequence(TransAct V2目前已在Pinterest Homefeed的生产流量中提供服务,为超过5亿用户提供个性化推荐。此次部署不仅证明了该模型在提升user engagement方面的有效性,也展示了其在解决real-world application挑战方面的实用性和可扩展性方法。我们的主要贡献如下:我们介绍了
TransAct V2,这是一种SOTA的模型,它结合了real-time user squence和lifelong user sequence,以提高user engagement和推荐多样性。我们实现了一种新颖的
next-action loss,使CTR模型能够更好地预测用户行为,从而提高预测准确性。我们为
CTR模型开发了web-scale serving solutions,确保低延迟性能和高效资源管理,并辅以全面的消融研究,突出每项优化对整体效率的贡献。
1.1 相关工作
Sequential Recommendation:序列推荐模型主要通过分析过去的行为历史来捕获用户兴趣。这些模型主要分为两类。第一类旨在直接预测用户序列中的next item,第二类则在CTR框架内对用户序列进行建模。基于Transformer的架构通过self-attention机制对item dependencies进行建模,彻底改变了序列推荐领域(《Self-attentive sequential recommendation》、《PinnerFormer: Sequence Modeling for User Representation at Pinterest》、《BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Transformer》)。尽管这些架构在模式识别方面非常有效,但它们通常用于pre-training user representations,而非端到端地学习CTR预测,随后再应用于item ranking等下游任务。在工业应用中,推荐系统通常在
ranking阶段使用CTR预测模型。最近的研究集中于使用sequential transformer encoders来处理user action sequences,作为CTR模型的一部分。两阶段
user sequence modeling,例如SIM(《Search-based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction》)、UBR4CTR(《User Behavior Retrieval for Click-Through Rate Prediction》)、TransAct(《TransAct: Transformer-based Realtime User Action Model for Recommendation at Pinterest》)、TWIN(《TWIN: TWo-stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》),首先检索relevant items,然后应用self-attention。然而,它们要么限制序列长度(限制了长期历史探索),要么依赖昂贵的offline inference和caching。TWIN v2(《TWIN V2: Scaling Ultra-Long User Behavior Sequence Modeling for Enhanced CTR Prediction at Kuaishou》)尝试通过离线使用聚类算法压缩lifelong user action histories来解决某些挑战。然而,这种压缩可能会降低序列的表达能力,因为在压缩过程中关键信息可能会丢失。
此外,与能够直接预测
next action的模型类别不同,这些以CTR为中心的Transformer缺乏直接的next-action prediction能力。Efficient Sequential Model Serving:推荐系统通常是高吞吐量系统,受严格的延迟约束。每个request涉及使用序列模型对数千个candidates进行排序,这在实时处理long user action sequences时带来了挑战。因此,许多研究采用离线序列压缩(offline sequence compression)技术,如TWIN v2(《TWIN V2: Scaling Ultra-Long User Behavior Sequence Modeling for Enhanced CTR Prediction at Kuaishou》)和Trinity(《Trinity: Syncretizing Multi-/Long-tail/Long-term Interests All in One》)中的聚类方法,而不是实时管理长序列。离线序列压缩方法是次优的,因为它们与被排序的candidate无关。使用实时用户序列使我们能够建模用户序列与candidate的交互,为模型提供更丰富的排序信息。值得注意的是,TWIN(《TWIN: TWo-stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》)使用一个单独的模型进行压缩,需要实时模型更新。另一种近期方法采用生成式架构,如
HSTU(《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》),但这些方法通常需要拥有数万亿参数的模型才能表现良好。生成式推荐模型也比常规CTR模型计算开销更大。考虑到这些因素,我们的工作集中在CTR预测上,因为它能更有效地应对工业级applications典型的延迟和成本约束。
1.2 方法论
我们首先描述
ranking模型的架构,然后探讨lifelong sequence modeling和Next Action Loss。最后,我们详细介绍TransAct V2的serving和日志系统。
1.2.1 预备知识:Ranking Model
Pinterest的首页排序模型(Homefeed ranking model)采用point-wise的多任务学习(multi-task learning: MTL)架构。如Figure 2所示,模型以context features、creator features、item features和user features作为输入,来预测用户交互的概率。与现有的CTR模型类似,它采用标准的Wide & Deep架构(《Wide & deep learning for recommender systems》),在应用feature interaction layers(《Improving feature interactions at Pinterest under industry constraints》)和多层感知机(MLPs)来生成head scores之前,对各种特征(包括用户序列)进行编码。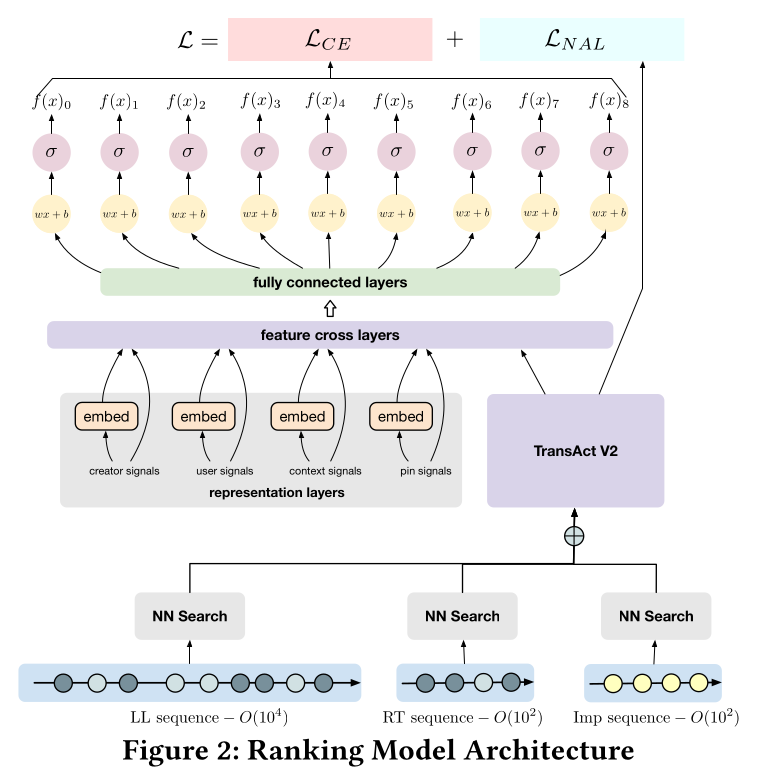
每个训练样本由
pairinput feature set,action heads相关联的label vector,action heads的集合。action headlabel。我们排序模型的核心损失函数是weighted cross-entropy loss,专为优化multi-label classification任务而定制。我们将multi-head prediction loss function定义如下:其中:
action head的预测概率。action headaction head
除了
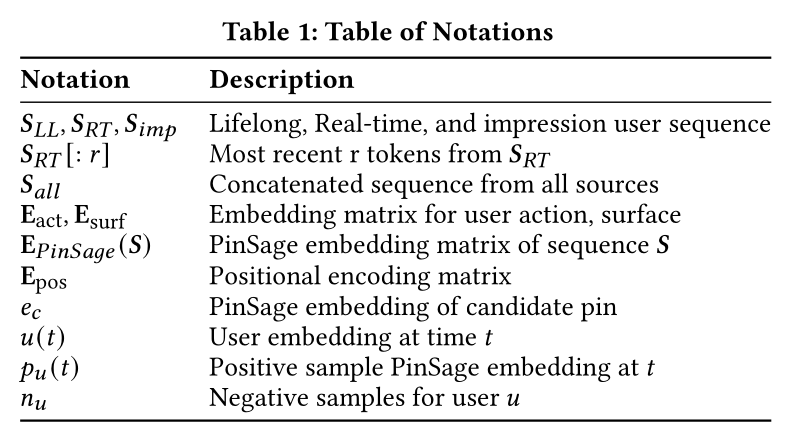
multi-head prediction之外,我们还引入了next-action prediction作为辅助任务,通过最小化Next Action Loss: NAL来优化。本文中采用的符号如下表所示。
1.2.2 TransAct V2
在本文中,我们介绍了
TransAct V2,这是一个基于Transformer的模型,它在CTR预测模型内整体性地结合了real-time action sequences和lifelong user action sequences,以提升user engagement和推荐多样性。实时序列通常捕获短期用户行为,聚焦于他们最近的兴趣。虽然这对即时相关性(immediate relevance)有效,但往往忽视了用户更长期的历史兴趣,导致关注范围狭窄,缺乏多样性。这种趋势可能导致回声室效应(echo-chamber effects),即用户反复接触相似内容,阻碍了他们发现新兴趣的能力。此类局限性可能对用户留存(user retention)产生不利影响,并降低整体的长期用户体验。通过整合life-long user sequences,我们的模型旨在平衡用户的即时偏好与历史模式,从而促进更丰富的、更多样化的交互生态。这种方法不仅能提高内容多样性,还能增加持续的user engagement。Lifelong User Sequence Features:在为TransAct V2构建lifelong (LL) user sequenceextended period)内有意义的交互行为。该序列由显式的用户行为组成,例如repins、clicks和hides,不包括单纯的impressions,以确保所捕获数据的相关性。lifelong user sequence的最大长度是基于过去两年内用户行为历史长度按访问频率加权后的第90百分位数来选择的。这种加权至关重要,因为它反映了那些对engagement和收入贡献显著的、最频繁访问用户的行为。每个lifelong sequence token具有四个特征:action timestamp、action type(如果与同一Pin有多次交互,则为multi-hot vector)、action surface(例如,homefeed、search),以及封装Pin content的32-d PinSage embedding(《Graph Convolutional Neural Networks for Web-Scale Recommender Systems》)。当用户与同一Pin进行多次交互时,action type可以表示为multi-hot vector。例如,用户可能先对某个Pin进行放大查看,随后又调整其大小。注意:这种 “最大序列长度选择” 方案会偏向于更长的序列。假设
90%的用户序列长度< 2000,但高频用户的序列长度普遍在5000–10000。如果不加权:取
90百分位数,那么最大序列长度为2000。如果加权:那么
90百分位数可能达到8000。
结果:模型能覆盖到高频用户的长周期兴趣。使得模型对高频用户的预测更准。
real-time sequencesimpression sequencesPinSage embedding是最大的数据组成部分。为优化存储和处理,我们应用仿射量化(affine quantization),将原始的32维fp16 PinSage embedding转换为32维int8 vector,将其大小减半:缩放因子
0.65通过对input distribution进行归一化,确保了精度并最小化data loss。Modeling Lifelong User Sequence:最近邻搜索(
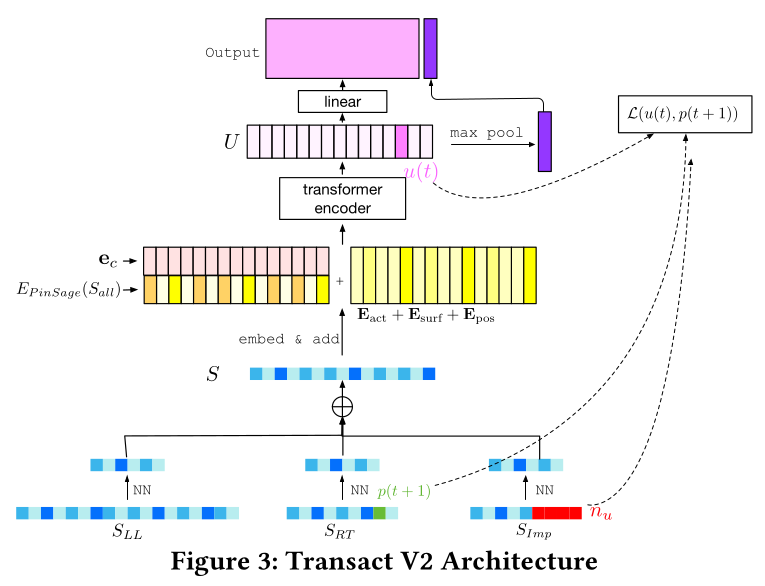
Nearest Neighbor Search):如Figure 3所示,我们使用相同的transformer encoder处理real-time user sequences和lifelong user sequences。遵循与TransAct(《TransAct: Transformer-based Realtime User Action Model for Recommendation at Pinterest》)类似的方法,我们首先以candidate item(记作lifelong sequencereal-time sequenceimpression sequenceactions,无论这些actions与candidate item的相似度如何。Next Action Loss提供negative samples的。最近邻搜索会从每个
其中
candidate PinSage embeddingitem的PinSage embedding之间的点积,然后基于相似度选择前其中:
PinSage Embedding矩阵。需要注意的是,
final sequencetransformer encoder处理的计算成本保持可控。Feature Encoding:为了整合用户序列中每个token的元数据(action type、surface),我们使用trainable embedding tables将它们投影到低维向量。action type sequence被投影到embedding matrixaction type embedding的维度。类似地,
surface feature被嵌入为surface embedding的维度。positional encoding被实现为一个可学习的参数positional embedding的维度。
对于
token,我们将它的Pinsage embedding与candidate pin的PinSage embeddingearly fusion方法(《TransAct: Transformer-based Realtime User Action Model for Recommendation at Pinterest》)。为使所有组件可加,我们设置final encoded user action sequence通过将所有上述组件相加而成。注意,
token Pinsage embedding与canddidiate Pinsage embedding拼接起来了。此外,
engaged pin的embedding进行拼接。Transformer Encoder:transformer encoder进行处理,每层使用单个attention head。模型维度设置为64,每层内的前馈网络维度为32。请注意,我们对transformer encoder应用了causal mask。关于超参数选择的更多细节将在实验章节中提供。transformer encoder的输出为什么应用了
causal mask?这是为了next action prediction而准备的,防止信息泄漏。第一个是
multi-head prediction任务。如Figure 3所示,在max pooling layer以产生输出。该输出将被馈送到Figure 2中的feature crossing layers以进行multi-head prediction。注意:一共有
feature crossing layers。第二个任务是
next action prediction任务,将在下一节讨论。
1.2.3 Next Action Loss
我们已经讨论了模型如何总结
user action history。为了充分利用这些用户序列信息,我们设计了一个单独的next-action prediction任务,训练Transformer来预测用户的next action。我们的实验结果表明,这个与multi-head prediction并行的辅助任务显著提升了ranking性能。Next Action Prediction Task:具体而言,对于给定用户来自Transformer处理好的时刻user embedding来预测第pin的engagement是positive的还是negative的。prediction loss以对比损失(contrastive loss)的方式构建。对于给定用户Transformer的输出causal mask时,它也可以被视为用户embedding。我们使用PinSage embedding,并使用selection的具体细节将在下一节讨论。next action loss: NAL,记作sampled softmax: SSM损失函数。sampled softmax是对比学习中常用的技术,并已在Pinterest应用于学习user representations的推荐系统中(《PinnerFormer: Sequence Modeling for User Representation at Pinterest》)。其中:
在训练期间,
multi-head cross entropy lossNext Action Loss的关键建模设计:与允许所有tokens相互关注的标准self-attention不同,causal mask限制tokens只能关注其前面的tokens,从而在next action prediction任务中防止信息泄露。例如,当预测第action时,模型只能访问从0到actions。next action prediction的损失函数的选择是另一个重要方面。虽然交叉熵是classification任务的热门选择,但我们采用了sampled softmax loss,因为它提供了更大的灵活性来调整正负样本的比例,从而一致地获得更好的性能。在样本选择方面:
对于正样本,我们使用来自
positive engagement types的tokens。为什么正样本仅仅选择
对于负样本,我们探索了两种方法:
第一种是
in-batch random negative sampling,涉及从与用户batch中随机选择一个用户pins。这假设同一batch内的不同用户通常具有不同的engagement兴趣。第二种是
impression-based negative sampling,从pins,这表明用户对它们的兴趣较低。
我们在实验章节中的详细发现显示,
impression-based negative samples更为有效;该方法提供了一组更具挑战性的样本,从而提升了排序性能。
1.2.4 Serving 和 Logging System 的设计
在
CTR模型中使用lifelong sequence的主要挑战之一在于,由于序列长度增加而带来的显著serving与存储成本。设ranking request的平均items数量。在此条件下:相应的
feature的存储成本与网络成本与
在本工作中,
model serving和网络效率带来了巨大的挑战。若没有任何优化,serving lifelong sequence将使系统变得极其昂贵和低效。为解决serving延迟和存储瓶颈,我们提出了一种专为super long user sequence models设计的新型机器学习data pipeline,如Figure 4所示。这些优化确保我们的系统能够在不牺牲延迟、存储效率或模型性能的情况下处理显著更长的用户序列。
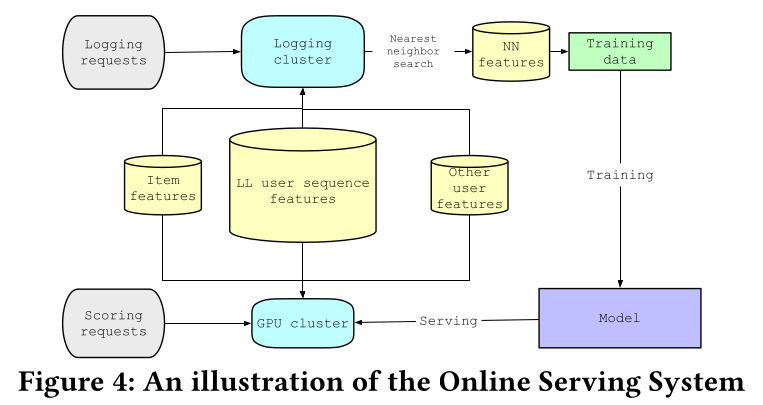
Data Pipelines:排序模型使用的所有特征通常在serving时存储在cache中,并随后被logged到训练数据中。然而,lifelong sequence特征过于庞大,无法高效地进行caching和网络传输。为解决由此产生的网络和存储成本,我们在data pipeline中实施了最近邻特征记录(nearest neighbor (NN) feature logging)策略,如Figure 4所示。我们不是传输和存储整个长度为relevant NN features记录到训练数据集中。这种方法将数据存储复杂度从我们的框架为
training和serving采用了不同的数据处理pipelines,针对两种场景进行了效率优化。在
training期间,模型从logged data中消费预先计算好的最近邻特征(nearest neighbor: NN feature),显著降低了数据加载开销。这些最近邻特征被直接送入transformer encoder。相比之下,在
serving期间,当接收到ranking request时,系统会检索目标用户的完整lifelong sequence。当user features和items的列表被发送到模型进行推理时,我们将lifelong sequence特征广播到所有items,随后进行设备端最近邻搜索以提取相关的最近邻特征。然后,这些特征被馈入transformer encoder进行推理。
这种设计平衡了存储效率、计算成本、以及
training and serving阶段之间的一致性,确保了生产环境中的可扩展性。存储效率:
Logging NN features而非完整lifelong sequence,最小化了存储和带宽成本。Training-Serving一致性:尽管特征处理路径不同,但NN feature representation保持一致。Inference可扩展性:设备端实时最近邻搜索确保了工业部署环境中的可扩展性和低延迟预测。
Serving Optimizations:为了在实时高QPS系统中serve lifelong user sequences而不产生巨大成本,我们共同优化了inference server和模型以降低延迟。Pinterest的推荐模型使用定制的C++ inference engine和CUDAGraph来减少CUDA kernel launch开销,详见TransAct(《TransAct: Transformer-based Realtime User Action Model for Recommendation at Pinterest》)。request被动态batch成mini-batches,在pageable CPU memory上准备好,复制到预先分配的pinned memory buffer(每个CUDAGraph实例一个),最后从pinned memory buffer复制到静态的GPU memory locations以进行模型前向传播。OpenAI的Triton框架最近已成为编写custom kernels以提高模型效率的强大工具。它已被广泛应用于大型语言模型训练以及推荐系统。Triton允许对张量分块和GPU L2 缓Cache(Shared Memory或静态随机存取存储器SRAM)进行更精细的控制,从而实现更智能的chaching和in-place fused operations。在我们的工作中,我们采用Triton构建custom transformer kernels来优化model serving。此外,处理CPU-to-GPU以及GPU内部的数据传输。通过将昂贵的操作融合到custom kernels中,我们减少了kernel calls的次数和中间数据传输的需求,从而提高了整体serving效率。Request Level去重:在典型的ranking setup中,单个inference request为一个用户对items进行排序。request-level特征(如user sequences)在CPU上被复制(广播)到每个item,然后传输到GPU进行推理。lifelong sequence特征在总特征大小中占据很大一部分。我们不是广播这些request-level sequence特征,而是引入了一种新的sparse tensor format,该格式存储去重后的request-level features和偏移量。如Figure 5所示,这种格式为模型提供了所有必要的元数据,使其能够在不进行广播的情况下处理request-level sequences。此外,我们开发了一个custom Triton kernel,直接在去重后的requests上执行最近邻搜索(broadcast free NN search),从而消除了在GPU上广播request-level sequence特征的需要。此优化使序列特征的PCIe数据传输减少了8倍。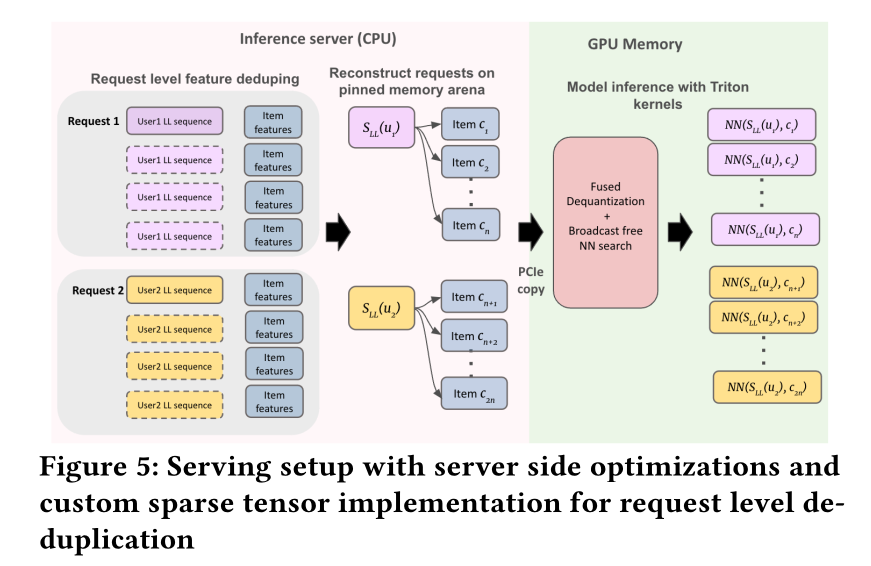
Fused Sequence Dequantization:如前面章节所述,PinSage sequence特征以量化的int8格式存储。在进行最近邻搜索之前,该张量必须被反量化(dequantized)为float16并进行归一化。在PyTorch中,L2 normalization通常涉及启动四个独立的kernels:squaring、summation、clamping和division。每个kernel处理这个相当大的张量,在高QPS下,这些操作可能成为性能瓶颈。我们将此操作与NN search kernel进行融合,与原生PyTorch实现相比,模型延迟降低了20%。Single Kernel Unified Transformer: SKUT:利用我们模型的低维度fused transformer,其前向传播性能比PyTorch快6.6倍。该Transformer实现为一个single merged custom Triton kernel。显著的延迟改进主要是通过在分块注意力(tiled attention)计算过程中动态生成QKV sequence tensors来实现的。前馈网络和layer-norm操作紧接着被fused,以生成final output tile。我们的
inference server使用Nvidia A10G GPU(8 MB共享内存)来处理Transformer inputs。鉴于维度较小,我们可以将所有Transformer权重—— 三个投影张量(64,64))以及前馈网络权重(64,32))—— 连同input tensor一起容纳在6 MB的共享内存中。这使我们能够将所有Transformer操作——QKV projection、Flash Attention、layer normalization和feed-forward network——融合成一个直接在静态随机存取存储器(SRAM)上执行的single fused operation,显著减少了GPU传输开销和kernel calls次数。Pinned Memory Arena:内存区域(Memory Arena)是一个线程本地(thread-local)的、连续预分配的内存块,在连续的inference requests之间会被重置和重用。内存预分配(pre-allocation)确保在inference过程中不会动态分配tensor memory。在inference过程中,每个size = 128的mini-batch会产生64 MB的有效载荷。这个较大的有效载荷引入了两个copy瓶颈——Pageable memory到Pinned memory的复制,以及Pinned CPU memory到GPU memory的复制。后者通过request-level去重得到了充分解决。为了补偿因这个新特性而增加的memory pinning的成本,我们实现了一个固定内存区域(Pinned Memory Arena)。我们的实现使用Memory Arena with pinned memory,并直接将整理好的mini-batches构建在其上。这完全消除了Pageable memory到Pinned memory的复制步骤,并将最终实验设置下的inference速度提高了35%。
1.3 实验
在本节中,我们将展示
TransAct V2的广泛离线和在线A/B实验结果。我们使用Pinterest的内部训练数据,将TransAct V2与基线模型进行性能比较。数据集:我们的离线训练数据集是从
Pinterest Homefeed中两周的用户活动中收集并降采样得到的。训练数据包含6.9 billion个训练实例,涉及182 million users和350 million Pins。模型使用随机初始化的权重从头开始训练,并在evaluation数据集上进行评估。evaluation数据集是在训练数据最后一天之后的7天数据。在本文中,我们所有的实验均使用
Pinterest数据集进行。我们的实验需要lifelong action sequence、real-time action sequence和impression sequence,以及元数据特征,如item embeddings、action types、surface types。据我们所知,公开可用的CTR预测数据集缺乏这些特征。
1.3.1 离线实验
指标:我们的模型性能使用
HIT@3指标进行评估。a "chunk" of recommendations,记作Pins。排序模型的每个evaluation数据实例包括一个用户标识符Pin标识符chunk标识符outputs按用户标识符和chunk标识符ranking request的结果。在每个组内,Pins根据final ranking scoreranking模型各heads的输出的线性组合:其中:
model heads的集合,head的输出的权重。从每个
chunk中选取前Pins,并计算HIT@K,记作headPins中标签为1的样本数量。例如,如果按照chunksrepin了repin行为的HIT@K为每个
headaggregated HIT@3计算如下,涵盖所有用户chunks对于
positive engagement(例如,repin、click),HIT@K越高越好。对于negative engagement(如hide),HIT@K/hide越低越好。结果:我们将我们提出的方法与现有的利用
user sequence特征的CTR预测模型进行比较。我们首先与未整合
user sequence特征的Wide & Deep(《Wide & deep learning for recommender systems》)模型进行比较。此外,我们还与
BST(《Behavior Sequence Transformer for E-Commerce Recommendation in Alibaba》)和TransAct(《TransAct: Transformer-based Realtime User Action Model for Recommendation at Pinterest》)进行比较,这两个模型都专注于real-time sequence modeling。TWIN(《TWIN: TWo-stage Interest Network for Lifelong User Behavior Modeling in CTR Prediction at Kuaishou》)未在本工作中进行比较,因为它依赖于计算昂贵的offline inference系统。诸如
BERT4Rec(《BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Transformer》)等模型由于问题表述的差异,未纳入直接比较。
如
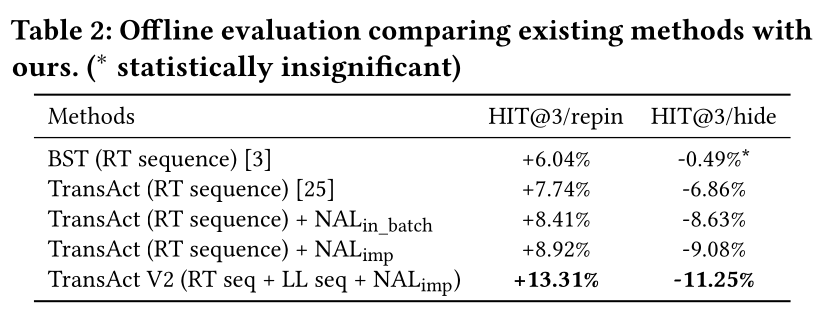
Table 2所示:TransAct V2同时结合了realtime sequence和lifelong sequence以及impression-based next action loss,取得了卓越的性能,超越了所有其他方法。它在HIT@3/repin上提高了13.31%,并将HIT@3/hide降低了11.25%,证明了其增强positive user engagement和减少negative interactions的能力。Impression-based Negative Sampling(impression-based的样本,模型受益于对用户不感兴趣内容的更细致理解,从而使ranking model的calibration更佳。因此,我们的实验证实,lifelong user sequence一起,显著提升了排序效果。
1.3.2 在线实验
在在线实验中,我们部署了离线实验中的模型。每个实验组
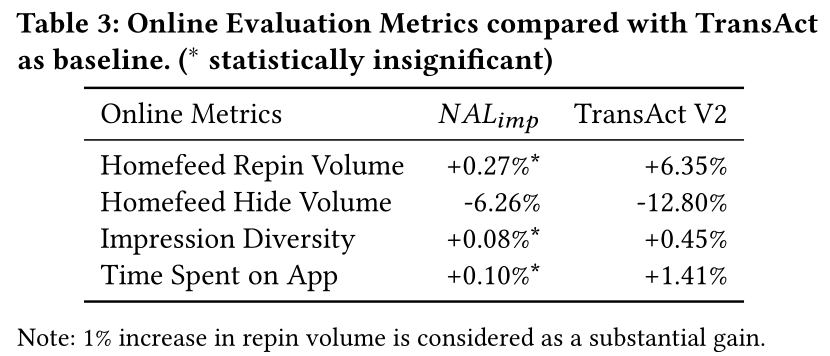
serve首页页面访客的1.5%。为保护用户体验,我们使用了Table 2中的强基线模型——TransAct (RT sequence)。指标:关键的
Homefeed指标包括:Homefeed Repin Volume:越高越好,与离线的HIT@3/repin相关。Homefeed Hide Volume:越低越好,表明不相关的推荐,以及用户体验差。我们还考虑了
Impression Diversity:越高越好,反映更广泛的内容曝光。
在线结果:
Table 3展示了我们模型的在线性能。我们观察到:Homefeed Hide Volume方面表现尤为出色,降低了6.26%。这表明使用impression-based negative sampling有效过滤了不相关的推荐,通过呈现更相关的内容改善了用户体验。集成了
TransAct V2取得了最佳的整体性能。具体而言,它使Homefeed Repin Volume显著增加了6.35%,表明该模型为用户提供了高度相关的推荐。此外,它使Homefeed Hide Volume降低了12.80%,进一步证明了该模型策划用户满意内容的能力。此外,该模型还提高了Diversity,增加了呈现给用户的内容多样性,丰富了他们的浏览体验。
1.3.3 消融研究
我们首先评估
Next Action Loss和transformer encoder的设计选择。然后,我们检查serving optimizations的不同组件。Next Action Loss Ablation:我们展示了NAL的设计选择的消融研究结果。如Table 4所示,impression-based negative sampling显著优于in-batch sampling。这是因为impressions提供了更强的、更具挑战性的负样本,改善了模型的泛化能力;并且至关重要的是,提高了模型预测negative outcomes和reducing hides的准确性。通过训练Transformer来识别并响应更细微的negative signals,模型实现了对用户偏好更全面的理解。额外的NAL消融研究见附录。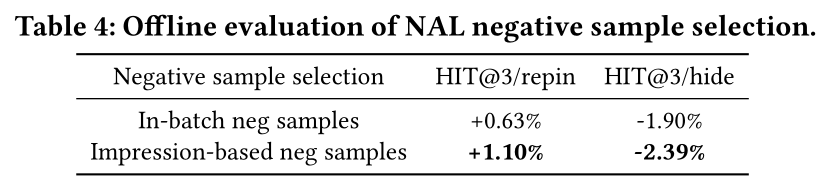
Transformer超参数:我们对Transformer超参数进行了广泛的调优,特别关注前馈网络维度和input sequence长度repin指标和inference成本/延迟之间取得平衡。综合评估确定了最佳配置:序列长度192、2层网络、前馈网络维度32。这种配置在保持良好的repin指标和低inference延迟之间取得了平衡。Figure 6显示,增加序列长度和前馈网络维度可以提高HIT@3/repin,但会显著增加inference延迟。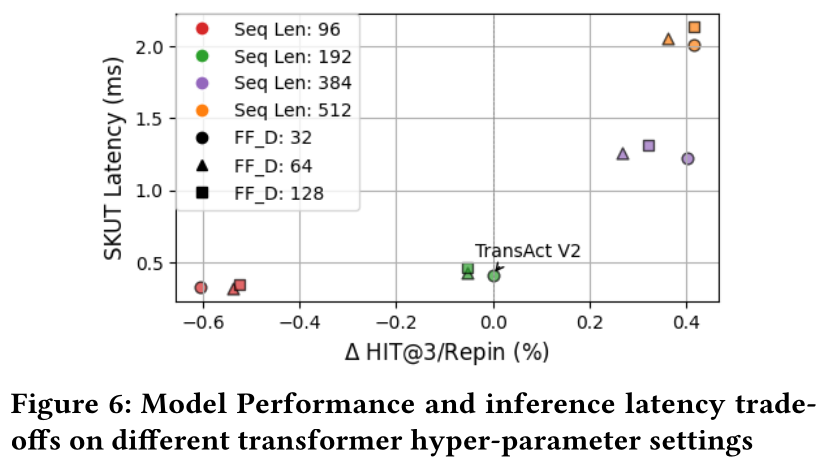
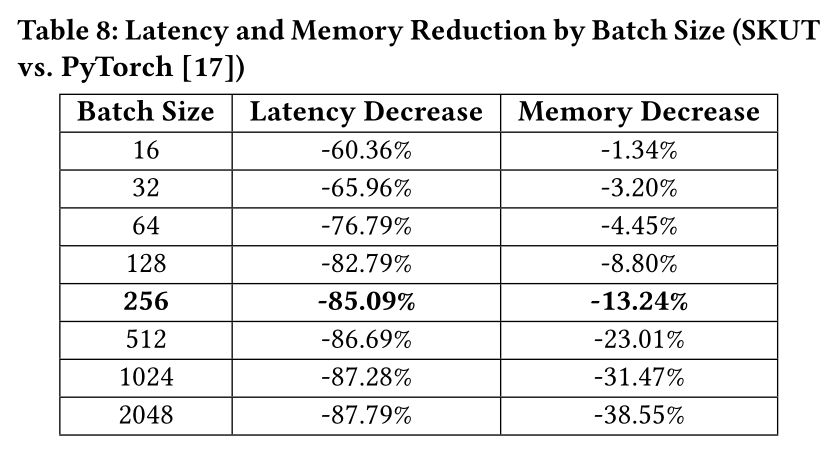
Serving Optimization Ablation:Single Kernel Unified Transformer: SKUT:我们通过在序列长度64-2048范围内测量前向传播的延迟来评估SKUT的性能。使用PyTorch的内存高效实现作为基线,在我们的生产设置(batch size = 256,序列长度192)中,SKUT实现了85.09%的延迟降低和13.24%的GPU内存占用降低。Table 5展示了SKUT在不同序列长度下相对于基线实现的优势。SKUT在不同batch size下也优于基线(详见附录B)。这些增益主要来源于避免了192时,这是由于针对production input形状进行了kernel tuning。SKUT在更长序列下也保持了相对于PyTorch实现的延迟优势。值得注意的是,未直接比较FlashAttention-2,因为它不支持自定义的masks(为了NAL屏蔽tokens、以及padding)。然而,我们仍在附录B中提供了without masks情况下的比较。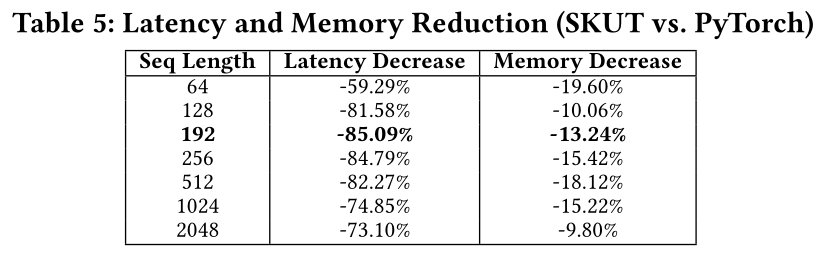
Server Optimizations:Figure 7, 8, 9中的结果来自高吞吐量在线serving环境(每主机每秒29,000个示例),旨在模拟峰值production流量。此设置包括并行的inference streams、动态的batching、batch queuing和request de-duplication,以准确反映在线延迟的减少。我们使用P99 latency(即99%的requests在1-minute window内完成的延迟)作为我们的评估指标。实时、低延迟系统通常监控P99 latency,以考虑最坏情况,同时排除异常值。Figure 7展示了我们的优化对CPU-to-GPU复制时间的影响。PinMem表示复制到Pinned Memory所产生的延迟,PCIe指通过PCIe从Pinned Memory复制到GPU的延迟。结果展示了batch size为128 - 512的情况。我们报告了基线、仅仅pinned memory arena、仅仅request de-dup、以及所有优化组合的消融数据,对应于每个batch size的4个柱状条。由于pinned memory arena only和all enabled groups直接在Pinned memory上构建batches,因此PinMem组件的值为零。通过所有优化,与基线相比,batch size = 128时复制时间改进了85%,batch size = 256时改进了82%,batch size = 512时改进了85%。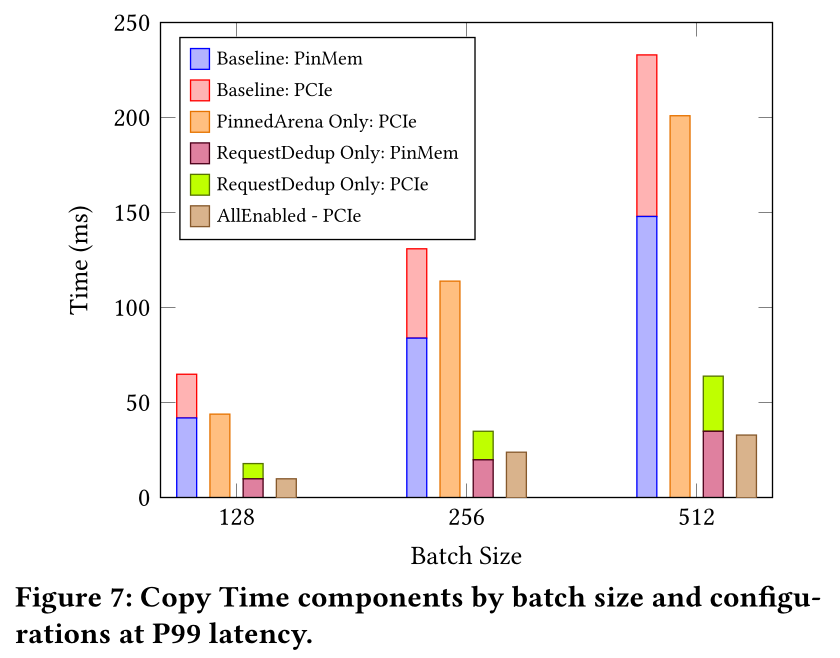
Figure 8展示了model inference延迟的改进。Model Run延迟包括CPU-to-GPU feature copy、model forward pass以及GPU-to-CPU output copy。结果展示了batch size为128、256和512下,基线、pinned memory、request deduplication以及组合方法的对比。当单独测试时,
Pinned Memory Arena对延迟降低的结果为中性至略微正向。这是因为在仅启用pinned memory arena时,高吞吐量下该设置会受到PCIe带宽的限制。然而,Request de-dup only在所有延迟和batch size大小下都显示出一致的降低效果。Model Run latency的最佳降低效果是通过叠加两种优化共同实现的,与基线相比,batch size为128、256和512的延迟分别降低了75%、75%和81%。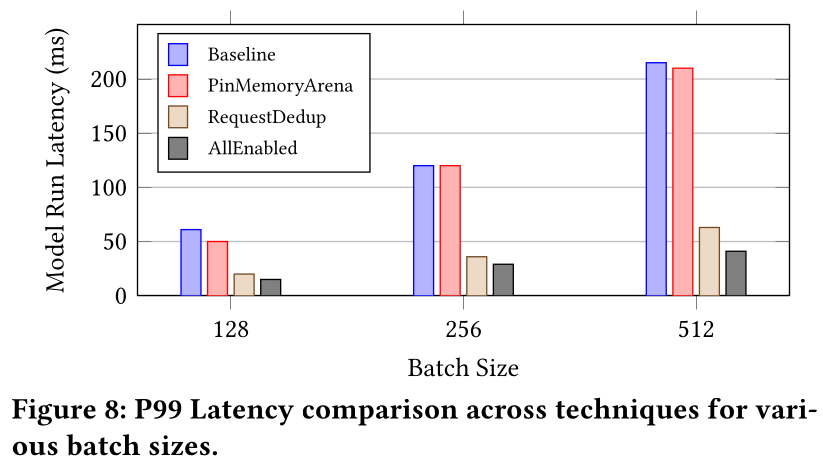
Figure 9展示了我们final optimized setup相对于基线在P50、P90和P99延迟百分位数上的改进比率。纵轴分解了端到端RPC延迟:model forward、pin memory和PCIe copy time、batch preparation time(CPU tensor construction)以及queuing delay(dynamic batching wait time)。正如预期,
model forward、pin memory和PCIe copy延迟得到了改善,这与Figure 7和Figure 8中的先前结果一致。此外,request de-dup减少了处理字节数,使batch preparation速度提高了5倍。更快的mini-batch processing将queuing delay减少了1300倍。总体而言,端到端inference延迟在P50、P90和P99上分别提升了103倍、338倍和250倍。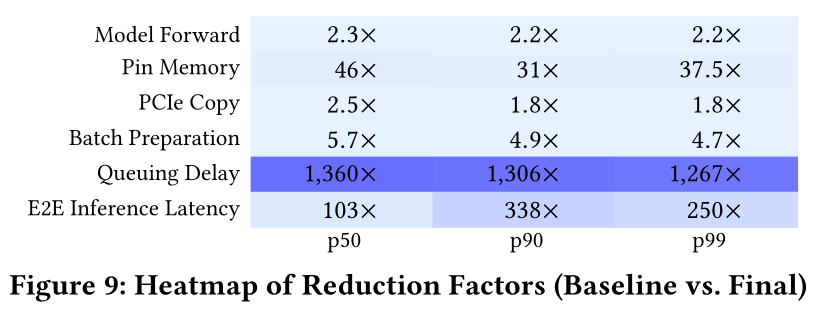
1.4 结论
本文介绍了
TransAct V2,这是一个整合real-time user sequences和lifelong user sequences以增强CTR预测的新颖模型。利用next-action loss,TransAct V2改进了action预测,提升了engagement和模型表达能力。其在Pinterest的实际应用部署展示了其高效管理extensive user histories、应对延迟和存储挑战的能力。对serving optimizations的严格消融研究证明了延迟和存储成本的降低,A/B测试证实了engagement指标的显著提升。TransAct V2推进了序列推荐领域,为部署复杂的大型模型提供了一个稳健的框架。
二、附录
2.1 NAL 的消融研究
NAL Loss Weight:我们对公式loss weightTable 6所示,调整NAL loss weight对于维持Next Action Loss task和multi-head prediction task之间的平衡是必要的。这是因为next action prediction作为一个辅助任务,而multi-head prediction是ranking model的primary objective。若
NAL的不成比例影响而损害multi-head prediction。反之,若
NAL的贡献将变得微不足道。
基于我们的消融研究,我们确定设置
loss values量级。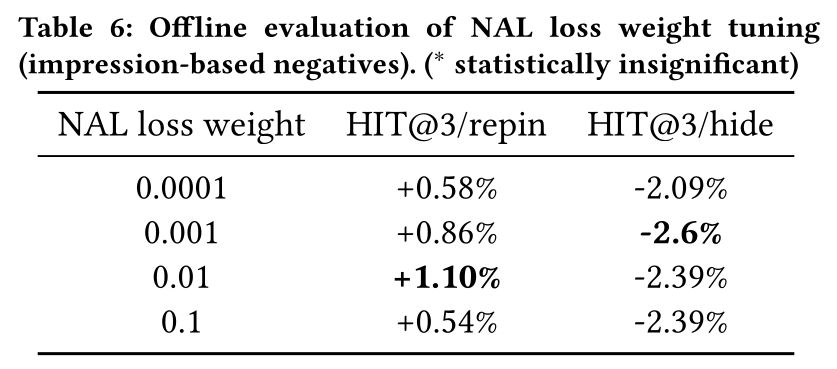
NAL Loss Type:Table 7显示,sampled softmax loss优于cross-entropy loss。cross-entropy loss通常是classification任务中最热门的选择,例如在我们的设置中预测positive or negative actions。然而,sampled softmax loss通过允许微调正负样本比例提供了更大的灵活性,如公式如
Table 7所示,sampled softmax loss相比cross-entropy loss带来了更优的结果。这一优势突显了调整sampling ratios以获得improved classification results的有效性。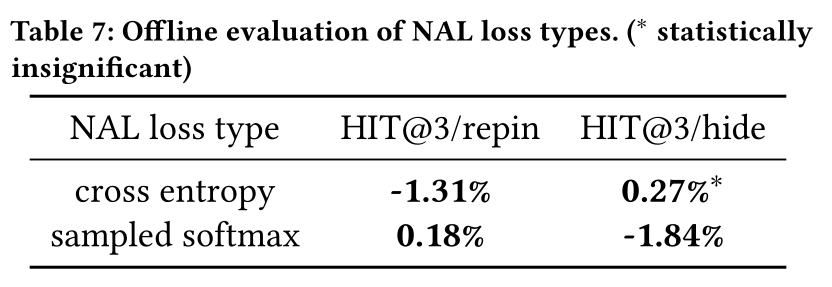
2.2 SKUT 的消融研究
Table 8中呈现的comparison强调了SKUT在不同batch size(固定序列长度为192)下相较于PyTorch内存高效实现的优越性。尽管FlashAttention-2由于不支持custom masking而不直接适用于我们的工作,但我们在without mask的情况下与SKUT进行了性能比较。我们的SKUT实现展示了显著优势,与FlashAttention-2 transformer without attention masks相比,延迟降低了66.4%,内存使用减少了5.5%。