一、ARGUS [2026]
《Scaling Recommender Transformers to One Billion Parameters》
尽管大型
Transformer模型已成功应用于许多现实世界应用,如自然语言处理、计算机视觉和语音处理,但为推荐系统scaling transformers仍然是一个具有挑战性的问题。最近,Generative Recommenders框架被提出,作为一种超越典型Deep Learning Recommendation Models: DLRMs的方法。通过将recommendation重新表述为一个sequential transduction任务,它在compute方面改善了scaling特性。然而,HSTU作者报告的最大encoder configuration仅为176 million参数——远小于语言模型中现已常见的billions参数(甚至trillions参数)。在这项工作中,我们提出了一种训练具有多达
one billion参数的大型transformer recommenders的方案。我们表明,autoregressive learning on user histories自然地分解为两个子任务,即feedback prediction和next-item prediction,并证明这种分解在广泛的transformer sizes下都能有效地scale。此外,我们报告了在一个服务数百万用户的大规模音乐平台上的成功部署。在online A/B tests中,所提出的模型将总收听时间(total listening time)提高了+2.26%,并将the likelihood of user likes提高了+6.37%,这(据我们所知)构成了该平台历史上任何deep learning-based system所报告的最大的recommendation quality改进。推荐系统是我们日常生活中不可或缺的一部分。它们帮助我们从相关曲目(
tracks)、图集(pins)和视频中找到灵感;与他人建立联系并随时了解世界;并为我们日常需求提供广泛的选择。它们还帮助创作者、艺术家和供应商找到他们的受众。为了确定展示哪些内容,推荐系统使用机器学习来预测
user feedback——例如用户是否会忽略、喜欢或不喜欢某个特定item。这项任务带来了许多挑战:item catalog庞大且不断变化,user preferences是动态的,user-item interactions是稀疏的。在这种情况下,像deep learning这样的复杂方法变得至关重要。Deep learning已被证明是处理涉及大量unstructured data(如文本或图像)问题的强大方法。传统方法严重依赖manual feature engineering和domain knowledge,而neural networks可以从raw inputs中自动学习complex patterns。此外,scaling hypothesis(《Scaling Laws for Neural Language Models》)声称,随着训练数据集大小和模型容量的增加,这种能力会显著增长。在过去十年中,scaling已在计算机视觉、自然语言处理和语音处理等领域发挥了关键作用。由于
item catalogs极其庞大且latency constraints极其严格,recommendation任务通常分多个阶段进行。第一阶段是
retrieval,使用轻量级模型从整个catalog中筛选可能的items。第二阶段是
ranking,将更复杂的架构应用于reduced set of candidates。
推荐系统主要有两种神经网络原型(
neural network archetypes):Early fusion rankers:强调跨user, item, and user-item features的feature interactions。它们通常包括一个embedding layer,后面跟着一个feature interaction layers、以及一个feedforward network: FFN。通常采用Multi-task learning来预测multiple components of user feedback。Submodules被用于构建user embeddings和item embeddings,这些embeddings可以作为上游模型而单独被训练(例如,SUM《Scaling User Modeling: Large-scale Online User Representations for Ads Personalization in Meta》),或与下游模型联合训练(例如,TransAct《TransAct: Transformer-based Realtime User Action Model for Recommendation at Pinterest》、DIN《Deep Interest Network for Click-Through Rate Prediction》)。由于这些rankers依赖于early fusion,它们不适用于retrieval。Sequential recommenders:将users视为sequences of events,通常被训练以预测future interactions(例如,SASRec(《Self-Attentive Sequential Recommendation》)、PinnerFormer《PinnerFormer: Sequence Modeling for User Representation at Pinterest》)。由于decoder layer(decoder layer生成next-item probability distribution)的线性结构,这些模型可以转换为具有独立user encoder和item encoder的双塔架构,从而在retrieval阶段实现approximate nearest neighbor search。此外,它们还可以作为下游rankers中强大的submodules(《PinnerFormer: Sequence Modeling for User Representation at Pinterest》)。
与其他
deep learning domains类似,我们的目标是在推荐系统中利用scaling hypothesis。有四个主要的scaling选项:Embeddings:Recommender模型包含大量的categorical features,其cardinalities从2到数十亿不等(《Unified embedding: battle-tested feature representations for web-scale ML systems》)。因此,针对trainable ID-based embeddings增加embedding dimensions会迅速导致非常大的embedding matrices。不幸的是,large embedding layers对于achieving good performance至关重要,因为它们代表了raw data和模型之间的信息瓶颈(参见golf analogy《Unified embedding: battle-tested feature representations for web-scale ML systems》)。例如:Meta的embedding tables范围从675B(《Wukong: Towards a Scaling Law for Large-Scale Recommendation》)到13T(《Software-hardware co-design for fast and scalable training of deep learning recommendation models》)个参数。而自
YouTubeDNN(《Deep Neural Networks for YouTube Recommendations》)以来,谷歌据报道大约有十亿个参数。即使是长期提倡
inductive PinSage embeddings(《Graph Convolutional Neural Networks for Web-Scale Recommender Systems》)的Pinterest,也在其最新工作中转向了large ID-based embedding matrices(《Taming the One-Epoch Phenomenon in Online Recommendation System by Two-stage Contrastive ID Pre-training》)。
Context length:在现代ranking系统中,大量的feature engineering已用于增加context length。这些系统中的特征数量从数百个到数千个不等。与此同时,user history for sequential recommenders仍然相对较短:the gold standard大约是100 interactions或256 interactions。Training dataset size。正如《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》所指出的,推荐系统可以以惊人的速度生成训练数据,每天生成相当于数百个GPT-3规模(《Language models are few-shot learners》)的数据集。行业标准长期以来涉及数十亿个样本:2B(《Deep Interest Network for Click- Through Rate Prediction》)、2.1B(《End-to-end training of Multimodal Model and ranking Model》)、3B(《TransAct: Transformer-based Realtime User Action Model for Recommendation at Pinterest》)、60B(《Software-hardware co-design for fast and scalable training of deep learning recommendation models》)、超过100B(《Deep Neural Networks for YouTube Recommendations》、《DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-scale Learning to Rank Systems》)、146B(《Wukong: Towards a Scaling Law for Large-Scale Recommendation》)和500B(《Wide & Deep Learning for Recommender Systems》)。Encoder capacity:在early fusion rankers中,谷歌报告其production models简化版本中的dense parts包含的参数在1M(《Recommending what video to watch next: a multitask ranking system》)到68M(《Improving Training Stability for Multitask Ranking Models in Recommender Systems》)之间。对于sequential recommenders,通常使用多达two transformer layers,四到五层较为罕见(例如,Kuaishou《KuaiFormer: Transformer-Based Retrieval at Kuaishou》)。hidden size通常保持在几百,导致最多只有几百万个参数。
尽管
embedding matrices和training datasets已经非常庞大,但context length和encoder capacity在scaling方面仍未得到充分探索。我们假设scaling potential of early fusion rankers受到specialized network layers的限制,如DCN-v2(《DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-scale Learning to Rank Systems》)或MaskNet(《MaskNet: Introducing Feature-Wise Multiplication to CTR Ranking Models by Instance-Guided Mask》),它们引入了强烈的inductive bias。相比之下,sequential recommenders没有这些结构限制,然而业界和学术界报告的encoders仍然相对较小。scaling research的一个重要进展是Meta的Generative Recommenders: GR框架(《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》)。对于user modeling,作者通过统一的生成式方法,弥合了early fusion rankers和sequential recommenders之间的差距。他们训练了a sequential model with a large context(8000 events)、大规模数据集(100B samples)和约万亿参数embedding tables。尽管如此,该工作中简要提到的最大HSTU encoder配置(24层,1024维embeddings)仅有176 million个参数。一个拥有
176 million参数的语言模型性能将远不如当前最大的语言模型。当用sequences of user-interaction events替换natural language tokens时,我们能实现类似的收益吗?成功scaling recommender transformer encoders可能会显著改善个性化服务,通过更细致地理解user interests,使全球数十亿用户受益。在这项工作中,我们专注于scaling recommender transformer encoders。本文的主要贡献如下:
与
Monty Python的亚瑟王(King Arthur)不同,我们确实实现了目标:我们将recommender transformers扩展到a billion参数,并观察到推荐性能的显著提升。我们提出了
a fundamental pre-training task,该任务自然地分解为两个互补的objectives:user feedback prediction和next-item prediction,同时在广泛的模型规模下都能有效地scaling。我们引入了一个计算高效的
fine-tuning阶段,将large transformer encoder转换为双塔架构,实现offline inference,并为下游模型提供强大的ranking feature。我们在一个拥有数百万
users和items、行业领先的音乐平台上部署了一个具有126M参数、上下文长度8192的Transformer模型。据我们所知,此次部署在该平台所有neural-network-based recommender models中取得了最大的质量提升。
我们将我们的方法命名为
ARGUS(AutoRegressive Generative User Sequential framework)。核心要点就是两个:
用
HSTU encoder在next item prediction和user feedback prediction这两个任务上混合地训练:对于
pre-trained HSTU encoder作为user tower,利用双塔模型来进行微调。
论文的内容组织比较乱,写的不清不楚。
1.1 相关工作
Scaling deep learning:AlexNet(《ImageNet Classification with Deep Convolutional Neural Networks》)是deep learning的首次重大成功,也是scaling的关键里程碑,因为ImageNet比以往任何数据集都大得多。《Revisiting Unreasonable Effectiveness of Data in Deep Learning Era》通过在大型但有噪声的JFT数据集上进行pre-training,改进了ImageNet classifier,证明了性能随数据集大小呈对数增长。《Deep Learning Scaling is Predictable, Empirically》验证了跨机器翻译、语言建模、图像处理和语音识别的scaling laws。《Exploring the Limits of Weakly Supervised Pretraining》使用来自Instagram的大规模弱监督数据来预训练ImageNet classifier。《Scaling and Benchmarking Self-Supervised Visual Representation Learning》表明,有限的模型容量会减少data scaling带来的收益;他们还强调了self-supervised learning的重要性以及识别appropriate pre-training tasks的必要性。《Scaling Laws for Neural Language Models》将scaling表述为compute allocation问题,探索模型大小和数据集大小之间的权衡;他们得出结论,更大的模型具有更高的样本效率,增加模型大小几乎总能带来更好的性能。《Training compute-optimal large language models》表明,由于suboptimal training(包括learning-rate scheduling),《Scaling Laws for Neural Language Models》提出的模型是undertrained的。《Language Models are Unsupervised Multitask Learners》深入探讨了language modeling,将next-token prediction形式化为一个extreme multi-task learning问题,从而展现出强大的scaling行为。
Early fusion neural rankers:Wide&Deep(《Wide & Deep Learning for Recommender Systems》)将一个deep neural network: DNN与一个linear model结合起来从而用于ranking,而YouTubeDNN(《Deep Neural Networks for YouTube Recommendations》)则完全放弃了linear component。关于
early fusion rankers的cross-feature和feature-interaction modeling,有大量研究。这类模型通常包含极其庞大的embedding matrices,参数多达12 trillion(《Software-hardware co-design for fast and scalable training of deep learning recommendation models》),而dense encoder part最多通常只包含数千万个参数。另一方向的研究考察了
scaling of neural rankers。《Understanding Scaling Laws for Recommendation Models》测试了scaling DLRMs从而用于CTR prediction,并得出结论:“对于所研究的模型架构,parameter scaling已失去动力,在出现更高性能的模型架构之前,data scaling是前进的道路”。Wukong(《Wukong: Towards a Scaling Law for Large-Scale Recommendation》)重新引入了stacked factorization machines的概念,并展示了scaling up到10B参数的能力。然而,据我们所知,后续工作并未复现Wukong的scaling results。与《From Features to Transformers: Redefining Ranking for Scalable Impact》类似,我们自己使用Wukong的实验也未复现报告的结果。
Sequential modeling for ranking:YouTubeDNN(《Deep Neural Networks for YouTube Recommendations》)对last-watched videos and search queries应用均值池化以形成user embeddings,然后将其用于ranking和retrieval。DIN(《Deep Interest Network for Click-Through Rate Prediction》)在user history上采用pointwise target-aware attention。BST(《Behavior sequence transformer for e-commerce recommendation in Alibaba》)、TransAct(《TransAct: Transformer-based Realtime User Action Model for Recommendation at Pinterest》)和LiRank(《LiRank: Industrial Large Scale Ranking Models at LinkedIn》)在下downstream ranker中加入了一个小型target-aware transformer,用于处理recent user history。HSTU(《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》)通过将actions和items交错放置在到单个序列中,将impression-level ranking重新定义为generative task。
Sequential modeling for retrieval:YouTubeDNN(《Deep Neural Networks for YouTube Recommendations》)将retrieval表述为预测用户next video watch。CASER(Personalized Top-N Sequential Recommendation via Convolutional Sequence Embedding)、GRU4Rec(《Session-based Recommendations with Recurrent Neural Networks》)和SASRec(《Self-Attentive Sequential Recommendation》)分别使用CNN、RNN和Transformer将用户表示为a sequence of positive user-item interactions,以预测the next positive interaction。PinnerFormer(《Pinner-Former: Sequence Modeling for User Representation at Pinterest》)额外在user history中包含negative user-item interactions,并训练以预测future positive interaction。HSTU retrieval(《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》)采用类似方法,基于full interaction history预测next positive interaction。《Latent Cross: Making Use of Context in Recurrent Recommender Systems》为YouTube提出了一个RNN-based retrieval model,而《Top-K Off-Policy Correction for a REINFORCE Recommender System》将recommendation形式化为强化学习问题,并对同一模型(《Latent Cross: Making Use of Context in Recurrent Recommender Systems》)应用了REINFORCE with off-policy correction算法。
Scaling sequential recommenders:CLUE(《Scaling law for recommendation models: towards general-purpose user representations》)使用contrastive learning在来自multiple domains的user histories上训练transformer encoder,展示了在训练数据、上下文长度和模型大小方面的scaling。《Pivotal Role of Language Modeling in Recommender Systems: Enriching Task-specific and Task-agnostic Representation Learning》将用户表示为a sequence of textual item descriptions,并训练transformer encoder来预测next item;他们也报告了scaling model size的好处。《Scaling generative pre-training for user ad activity sequences》训练了一个transformer用于next-event prediction,将events分解为separate features,并将模型大小scale到85M参数。《Scaling Law of Large Sequential Recommendation Models》训练了一个transformer用于next-item prediction,报告了比NLP更好的scaling law。《Scaling New Frontiers: Insights into Large Recommendation Models》探索了HSTU架构的扩展,我们将在后面进一步讨论。
然而,这些研究大多使用众所周知的
leave-one-out评估方案,而没有适当的时间划分(temporal split)(《A Critical Study on Data Leakage in Recommender System Offline Evaluation》、《Take a Fresh Look at Recommender Systems from an Evaluation Standpoint》)。虽然这对于小模型可能可以接受,但由于其记忆容量,对大模型省略temporal split是有问题的。HSTU(《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》)通过在专有工业数据集上使用适当的时间协议(temporal protocol)进行评估,并报告在线指标,从而解决了这个问题。作者将encoder扩展到8k context和100B样本,并引入了一种新架构。不过,所提到的最大encoder仅包含176M参数。
1.2 模型架构
本文符号如下表所示。
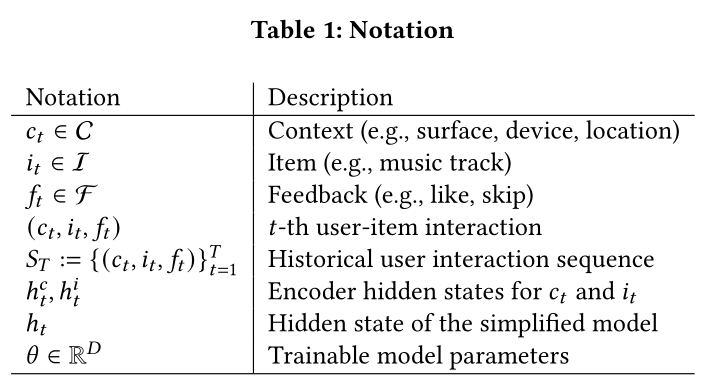
1.2.1 Pre-training
如果模型
(1)具有足够的容量,(2)在a fundamental task上,(3)使用海量数据进行预训练,那么scaling deep learning就保证会成功。在推荐系统中,user feedback会产生海量的训练数据,而transformer似乎非常适合对user-history sequences进行建模。但关键问题仍然存在:training task应该是什么?近十年来,行业标准一直是next-item prediction,即训练模型来预测next positive user-item interaction。然而,它并未在实践中显示出明显的scaling benefits。在本节中,我们提出了一个pre-training objective,该objective在广泛的模型规模下都能有效地scale。考虑大型语言模型:尽管是在有噪声的大规模
internet data上训练的,它们仍然能产生合理的回复。Prompting such a model通常会产生an average internet-style answer,这可能是次优的或仅部分准确。然而,modifying the prompt——例如,使用像"Let’s say you are very knowledgeable"这样的前缀——可以将output distribution偏向客观上更好的回复 (《Language models are few-shot learners》)。这反映了模型同时利用prefix context及其在预训练期间获得的internal world knowledge来优化其outputs的能力。在reinforcement learning术语中,模型通过结合它对环境的理解(world knowledge和abstract patterns),改进了它模仿的logging policy(internet answers)。imitation of the logging policy和world knowledge accumulation都发生在pre-training期间。受我们与大型语言模型类比的启发,我们从概念上将
recommendation重新定义为一个reinforcement learning问题,类似于《Top-K Off-Policy Correction for a REINFORCE Recommender System》:recommender system是一个agent。action space对应于被推荐给用户的items。在最简单的情况下,一个action包括recommending a single item。user interests、browsing habits、interaction patterns定义了environment,该environment独立于任何single recommender而存在。state捕获了user history并自然地满足马尔可夫性质。马尔可夫性质:数学上,对一个随机过程
policy将user states映射到item distributions。
在这个框架内,生成训练数据的
production recommender system充当logging policy——我们可以直接模仿的behavior。同时,user behavior提供了world knowledge:关于不依赖于任何particular system的preferences的洞察,这些洞察通过user feedback和organic transitions可见(organic user event指的是不受explicit system recommendations影响的events,例如search activity)。借鉴我们的语言模型类比,我们提出了一个具有dual objectives的pre-training task:(1):学习模仿(learning to imitate)先前的推荐系统。(2):从feedback和organic navigation patterns中学习user preferences。
请注意,我们的训练完全离线且是监督式的;我们不进行
online reinforcement learning。我们使用RL术语作为概念透镜(conceptual lens):next-item prediction对应于策略模仿(policy imitation)。而
feedback prediction鼓励学习user response规律,这个规律可被解释为environment modeling。
上面一大段话都是废话,它们介绍了一些关于强化学习的概念。实际上,本篇论文跟强化学习无关。
Next-item prediction:在我们的方法中,模型看到a sequence of context-item-feedback tripletscontextual features(如surface),item,user feedback。next-item prediction task是:我们在
all item interactions上训练,包括non-positive feedback。至关重要的是,interaction surface,这表明exposure是recommended的还是organic的;并且对于recommended impressions,通常标识该surface特定的serving policy。因此,以interaction types:它可以重现surface-specific recommendation behavior,同时也能学习反映user preferences的organic navigation patterns。为了优化此任务,我们使用
logQ-corrected sampled softmax(《Sampling-bias-corrected neural modeling for large corpus item recommendations》)和mixed negative sampling(《Mixed Negative Sampling for Learning Two-tower Neural Networks in Recommendations》):其中:
context-aware embeddingitem embeddingin-batch negatives和items。mixed sampler下negative sampling probability的估计(使用a count-min sketch来维护,如《Sampling-bias-corrected neural modeling for large corpus item recommendations》中所述)。这句话里的
其中:
in-batch通道取负样本时,itemin-batch negatives的采样概率,它等于freq()表示给定样本被采样到batch中的概率,freq()难以精确统计,因此用count-min sketch来近似估计。in-batch通道取负样本的概率,它等于uniform通道取负样本时,itemuniform通道取负样本的概率,它等于
为什么要做
logQ校正?核心原因是:负样本不是均匀采样的,直接算sampled softmax会有偏差。如果不做logQ校正,相当于假设每个负样本被采到的概率一样,即但实际上:
in-batch negatives偏向热门item,热门item会作为负样本频繁出现。如果直接把它计入分母,模型会以为 “这个item经常是负样本”,从而过度压低热门item的分数。这会引入流行度偏差,损害推荐质量。[0.01, 100]。
Feedback prediction:虽然next-item prediction捕获了logging policy behavior patterns和organic user behavior patterns,但modeling actual user preferences需要一个额外的feedback-prediction component:在实践中,
feedback通常是多变量(multivariate)的(例如,skip/like,listening duration),并且可以分解为为简化起见,我们假设这些组件在给定状态下是条件独立的:
这将
feedback prediction变成了一个multi-task learning问题。overall loss为:其中:其中
feedback维度的logit。此objective通过显式建模用户对items的反应来补充next-item prediction。我们将这两个
objectives组合成final pre-training loss:如
Figure 1所示。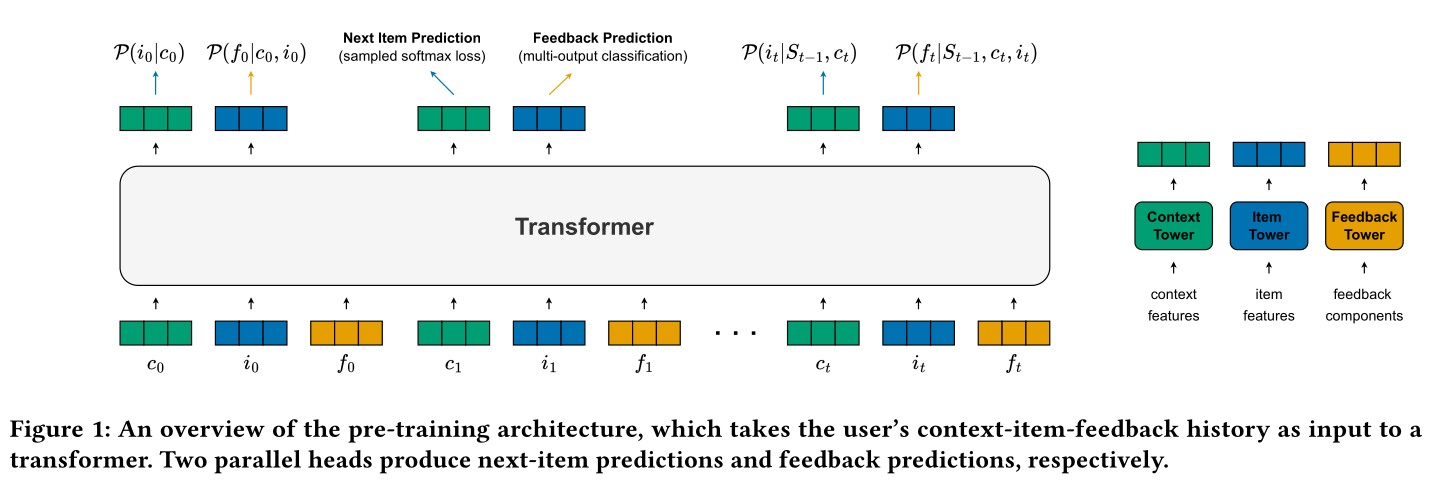
Differences with SASRec:传统的序列模型如SASRec(《Self-Attentive Sequential Recommendation》)也依赖于next-item prediction,但通常只考虑positive interactions。这将item被展示的可能性与获得positive feedback的可能性混为一谈,并忽略了许多neutral interactions(这些neutral interactions对modeling real-world behavior至关重要)。相比之下,我们的模型既包含了系统推荐产生的
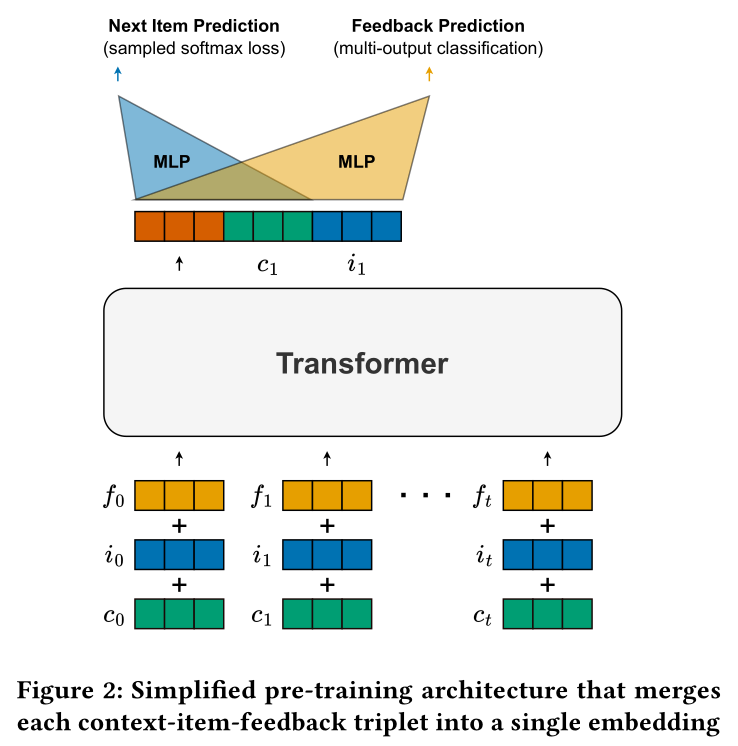
impressions(无论user response如何),也包含了user-driven (organic) events,并显式地对user feedback进行建模。Simplified architecture:将每个user-item interaction表示为三元组interactions的序列的长度为long user histories的计算成本很高。为降低复杂度,我们将每个三元组进行合并为一个interaction embedding。具体来说,encoder现在对每个interaction输出一个hidden stateFigure 2)。这种压缩在
context和item信息的表示方式、以及跨任务重用方面引入了权衡。对于
next-item prediction,我们无法再获得a fully context-aware hidden stateprevious hidden statecurrent context embeddingMLP投影来近似它:因为
target item类似地,对于
feedback prediction,我们失去了对target item的直接访问(target awareness《Deep Interest Network for Click-Through Rate Prediction》)。我们将target-aware state近似为:.
这一段也讲的不清不楚。本质上就是
input的时候聚合为一个hidden representation。但是预测的时候:next-item prediction task:利用feedback prediction task:利用
1.2.2 Fine-tuning
有多种方法可以使我们的
pre-trained model适配下游任务。在这项工作中,我们专注于fine-tuning,并将其他适配方法留待未来工作。我们的主要下游目标是
item reranking。一种广泛采用的训练方法是impression-aware pointwise training(《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》),定义为:其中:
用户
itemlike)。user、item和user-item features(《Deep Learning Recommendation Model for Personalization and Recommendation Systems》)的ranking模型。
在实践中,
pointwise loss可以根据application被替换为pairwise loss或listwise loss。在我们的生产环境中,我们使用一个pairwise ranking objective,这将在实验章节中详细讨论。从概念上讲,这个
ranking objective与modeling feedbackpre-training goal一致。然而,practical considerations和task-specific constraints促使我们采用a separate fine-tuning procedure:Domain shift:我们的pre-training domain比final task domain更广泛:模型最初暴露于所有contexts(包括purely organic contexts)的feedback,而final ranking只需要预测recommended items的feedback。在fine-tuning期间,我们将training限制在recommendation-based contexts的items上。Daily inference:Pre-training假设data delivery是零延迟的,并依赖于资源密集型的real-time inference。由于效率考虑,我们更倾向于将计算卸载到offline batch workloads。一种常见的方法(《Pinner-Former: Sequence Modeling for User Representation at Pinterest》)是训练一个具有simulated data delivery delay的双塔模型:我们每天计算一次user embeddings和item embeddings,将user embeddings存储在key-value system中,然后在serving时使用点积。Causal pre-training:模拟24-hour data delivery delay、或在pre-training期间采用复杂的pairwise ranking loss或listwise ranking loss,这将需要更复杂的attention masking方案。相比之下,我们的fine-tuning过程保留了pre-training期间使用的简单causal masking。
Figure 3说明了我们为解决上述挑战而设计的impression-aware, one-pass, two-tower fine-tuning过程。我们对用户的整个历史通过a causal transformer进行单次前向传递,形成a sequence of user representations。Impressions(recommended items)形成a separate sequence,并通过timestamp和simulated latency与user hidden states进行匹配。然后我们计算每个impression的embedding与相应user representation之间的点积以获得ranking score,并将结果馈入合适的ranking loss function(例如,pointwise或listwise):其中:
impressed item的embedding,timestamp-aligned user representation。我们将此配置作为一个连贯的
scaling方案,而不是一组独立的启发式方法(a set of independent heuristics)。虽然像feedback prediction或pecific attention mechanisms这样的individual components可以进一步进行消融研究,但我们的结果表明,这种特定组合提供了一条稳定且可复现的路径,可以将scaling recommender transformers到billion-parameter规模。Figure 3其实就是双塔方案(微调阶段):Historical Impressions:这是item tower。下面的
inputs -> Transformer -> Historical user states:这就是user tower。
微调期间,对于
user tower,一次inference会输出多个user representation(对应于不同的时间戳);然后将多个target impression item与这些user representation配对,每个user represenation可能对应多个target impression item,每个配对作为正样本。然后随机采样一些作为负样本。这比每个target impression item都重新编码用户历史高效得多。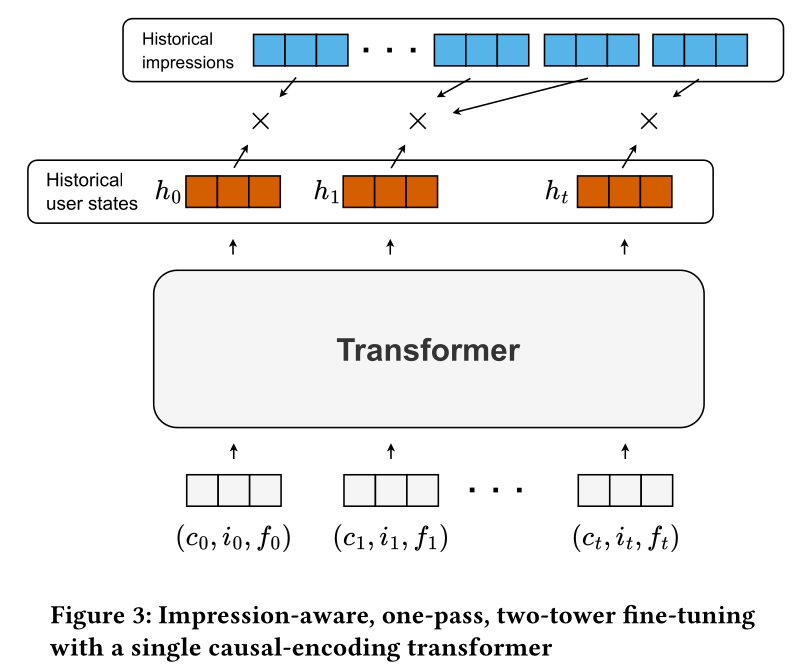
1.3 实验
我们旨在回答以下研究问题:
RQ1:ARGUS是否有效scale?RQ2:HSTU与标准transformer encoder相比如何?RQ3:我们的两阶段training pipeline是否必要?我们能简化它吗?RQ4:context length scaling是否能提高音乐领域的推荐质量?RQ5:ARGUS在现实世界的推荐场景中表现如何?
数据集:数据集的选择基于以下标准:
Scalability:数据集必须足够大,以支持训练和评估具有数亿甚至数十亿参数的模型。小型数据集要么会导致one-epoch训练下的欠拟合,要么会在multiple epochs训练时过拟合。Content Coverage:为了按上述定义来同时学习next-item prediction和feedback- prediction任务,数据集应同时包括impressed items和user feedback,以及各种contexts——recommendation-based and organic ones。Applicability:数据集应反映现实世界的使用场景,并适用于在生产环境中验证模型。理想情况下,能够进行A/B test。
由于没有公开数据集(据我们所知)满足这些要求,我们通过从我们的音乐流媒体平台中采样数千万用户的一年的活动数据,构建了自己的数据集。该数据集包含超过
300B user-item interactions跨数百万items,包括ItemID、ArtistID和其他item features。它涵盖了implicit signals(如listening duration和skips),explicit feedback(如likes),以及contextual features(包括surface type、device、以及recommendation settings)。对于
pre-training,我们将每个用户的history划分为fixed-length chunks。每个chunk被视为一个单独的训练样本。对于fine-tuning,我们使用pairwise logistic loss,从时间上相邻的且具有不同feedback outcomes的interactions中形成impression pairs。Baselines:为了评估model scaling和两阶段训练的效果,我们主要在相同的architecture family内比较模型。我们将modeling family固定为应用于user interaction histories的标准transformer,它作为研究scaling behavior的一般性的和代表性的基线。此外,我们还通过将transformer替换为HSTU来进行encoder replacement比较,HSTU的作者认为其在推荐任务上比transformer具有更好的可扩展性。我们下游
utility的主要benchmark是面对我们的production ranking model:一个gradient-boosted decision tree: GBDT的ensemble模型,使用pairwise logistic loss在数千个特征上训练。这些特征包括标准启发式方法(counters、ratios)、手工设计的信号,以及来自早期几代transformer-based two-tower models的输出。我们在后续章节中更详细地描述了这些先前的模型。对于下游评估,我们不与传统的
sequential recommenders(如SASRec)进行比较。此类模型通常针对next-item prediction进行优化,主要用于retrieval-style settings,而不是impression-level ranking;因此,它们不太适合我们的ranking setup,并且会明显表现不佳。我们也不与HSTU的target-aware ranking formulations进行比较:它们依赖于real-time data和explicit target awareness(以candidate item为条件),这在计算上比我们天级别处理user sequences和offline inference的two-tower setup昂贵得多。Evaluation Metrics:我们使用global temporal split来评估模型,将training period之后的一周作为测试集。与scaling studies中常用的random splits不同,严格的temporal evaluation对于大规模模型至关重要。它可以防止因数据泄露(记住future interactions)导致的性能高估,并从根本上测试模型对distribution shift的鲁棒性。为了评估
pre-trained model,我们关注两个核心能力:next-item prediction和user feedback modeling:Feedback prediction:我们根据从经验频率(empirical frequencies)中估计而来的baseline feedback distribution来测量归一化熵(normalized entropy)(如《Practical Lessons from Predicting Clicks on Ads at Facebook》中所述)。Next-item prediction:Normalized entropy是相对于a unigram item distribution(从user-item interactions计算到)计算而来的,使用与training相同的sampled softmax setup(8192个均匀负样本、以及8192个in-batch负样本)。
pre-training之后,我们在两种场景下评估模型对impressions进行排序的能力:(1):独立排序:模型直接对impressions进行排序。(2):Feature integration:模型的output作为一个额外特征提供给我们的production ranker。
我们测量
pairwise accuracy,它将模型的ordering与实际的user preferences进行比较。形式上,设impression pairpositive feedback多于skipped track差于完成率高于某个阈值的track,后者又差于explicit like)。那么:然后,我们定义相对于我们
production ranker的pair accuracy uplift:其中:
production ranker的pairwise accuracy。Positive PAU表示相对于baseline的改进,而Negative PAU表示性能下降。与标准的ROC-AUC(它对所有可比较的pairs进行聚合)不同,我们的指标将comparisons限制在a user sequence内时间相邻的impressions。为什么不用
AUC而用PAU?standalone ranking中的negative uplift(例如,Large的-4.78%)应在上下文中解释:我们的模型以离线模式运行,具有24小时的数据延迟,并且仅使用user history。相比之下,production baseline是一个复杂的ensemble模型,利用serving时可用的数百个实时特征。一个单一的offline transformer能够接近这一性能水平的事实凸显了其表达能力。实现细节:所有实验均使用
PyTorch 2.x和分布式数据并行(Distributed Data Parallel: DDP),在64-256个A100 80GB GPU上运行。训练持续时间从1 day到1week不等,具体取决于模型大小。遵循生产实践(《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》),我们对数据集训练一个epoch。除非另有说明,所有模型均使用以下配置进行训练:ARGUS (simplified):没有context-item-feedback interleaving;每个interaction以单个embedding来表达。Unified embeddings for categorical features(《Unified embedding: battle-tested feature representations for web-scale ML systems》):我们对item ID使用3-way lookup。所有实验中使用的相同embedding matrix size,包含130M参数(512k个大小为256的embeddings)。请注意,这些是额外参数,不计入encoder size。Absolute trainable positional embeddings。Output embedding size:对users和items均为512。Sequence length:512(pre-training),2048(fine-tuning)。Encoder:medium transformer configuration(L10 H1024)。Latency simulation during fine-tuning:matching impressions to user states延迟24小时。
Table 2总结了主要超参数。我们为backbone与task-specific heads分配不同的学习率:backbone参数使用linear warmup后接恒定学习率;而head参数使用较大的学习率,采用linear warmup后接linear decay。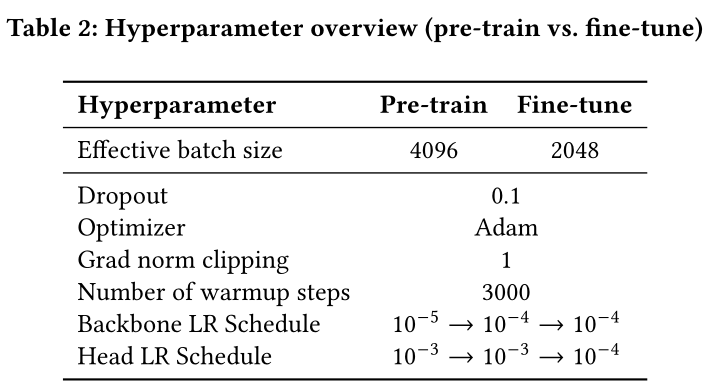
1.3.1 Scaling Hypothesis (RQ1)
在
Table 3中,我们比较了四种ARGUS encoders,范围从3.2M(Mini)到1B(Large)参数。我们在大约对数参数尺度上选择模型大小,以便能够一致地评估scaling laws。我们评估
pre-training性能(通过feedback and next-item prediction的normalized entropy)和下游性能(通过对temporally adjacent item impressions的pairwise accuracy uplift)。随着模型大小的增加,我们观察到所有指标的一致改进。
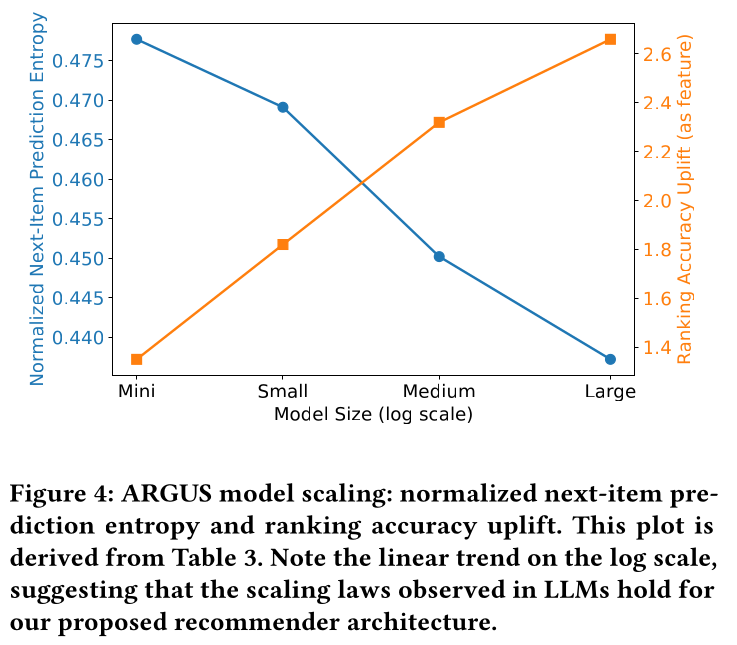
Feedback prediction entropy提高了3% ~ 7%,next-item entropy下降了超过10%,pairwise accuracy uplift增加了+1.35%(Mini)到+2.66%(Large)。这些结果,也在Figure 4中展示,表明transformer-based recommenders存在清晰的scaling趋势。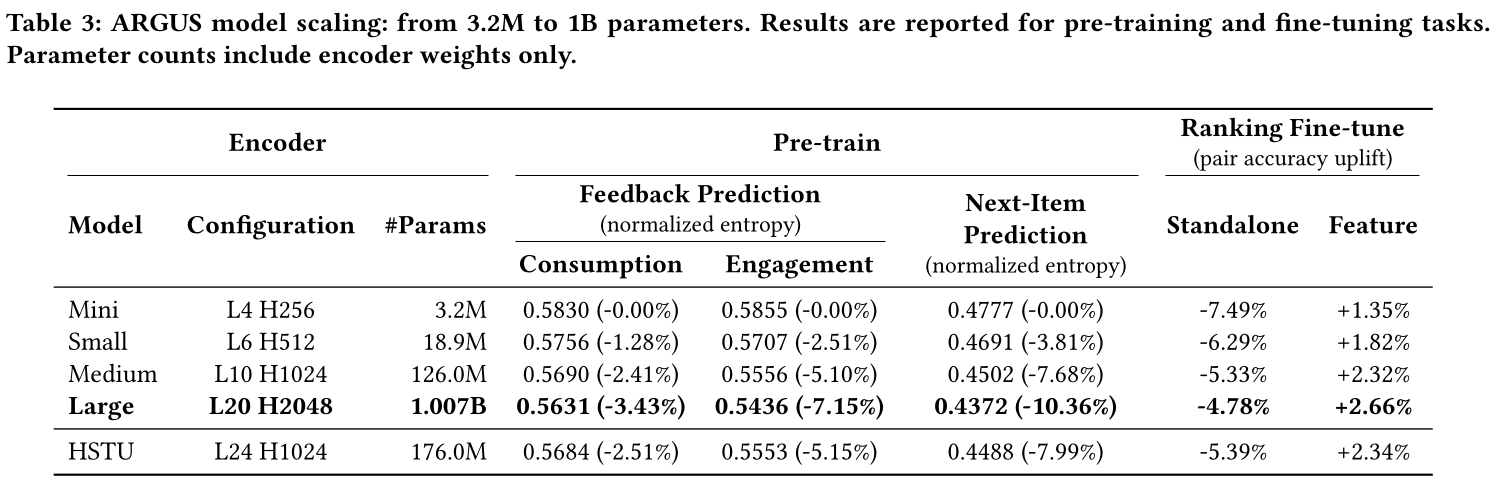
1.3.2 Encoder: Transformers vs. HSTU (RQ2)
HSTU是最近提出的encoder架构,被定位为recommendation中transformer的替代方案。作者认为它能更好地捕获counting-style signals,并报告了在academic benchmarks上替代transformer encoder时取得的强劲结果和有利的scaling。由于我们的工作研究transformer-based recommenders的scaling,我们将此comparison作为a sanity check:如果HSTU具有显著的scaling优势,它可能会降低在我们的设置中transformer scaling的实际相关性(practical relevance)。我们将我们的
medium transformer encoder与《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》报告的largest HSTU configuration进行比较。尽管HSTU的参数多约1.5倍,但transformer在pre-training metrics和ranking uplift方面均取得了相差无几的结果(Table 3)。总体而言,在我们的setup中,我们没有观察到HSTU相对于标准transformer具有明显的scaling-driven的优势。
1.3.3 Two-Stage Training Pipeline (RQ3)
我们通过分离
pre-training和fine-tuning的贡献来评估我们两阶段方法的有效性。Table 4中的结果表明,这两个组成部分对于获得最佳性能都是必要的。在没有
pre-training的情况下,即使进行整整一年的fine-tuning,feature setting也只能达到+1.17%的提升,远低于pre-trained fine-tuned model(+2.32%)。有趣的是,即使在
pre-training之后,fine-tuning也必须保持较大规模。使用相同的pre-trained backbone,将fine-tuning时间从一周延长到一年,可将feature-based uplift从+0.63%提高到+2.32%,这是一个显著的收益。这表明,与常见的LLM流程(fine-tuning set相对于pre-training很小)不同,在我们的setting中,impression-level ranking需要相当规模的fine-tuning。
综上所述,这些结果验证了我们的流程设计:
pre-training提供了一个强大的backbone,而large-scale fine-tuning使模型与下游ranking objective对齐。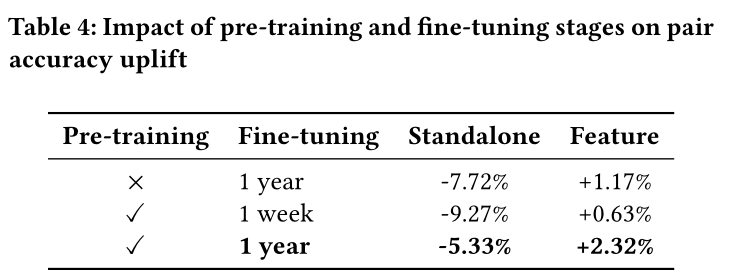
1.3.4 Context Length Scaling (RQ4)
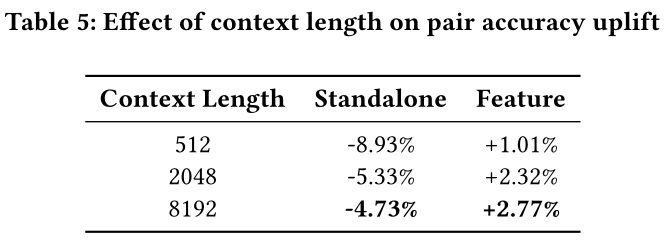
我们考察增加
context length(past historical user interactions数量)是否能提高推荐质量。我们将pre-training context length固定为512,仅改变fine-tuning context length。如
Table 5所示,longer histories在pairwise accuracy uplift方面带来了一致的改进。将上下文长度从
512 interactions增加到2048 interactions带来了显著的收益(feature-based ranking中从+1.01%到+2.32%)。进一步扩展到
8192 interactions带来了额外的提升(+2.77%),与将模型大小从100M扩展到1B参数的收益相当。
1.3.5 Real-World Experiments (RQ5)
在过去的几年里,我们将一系列
transformer-based ranking models部署到我们的音乐推荐流程中。所有先前的模型都遵循双塔架构。它们采用传统的next-item prediction pre-training(例如,预测next like),然后进行impression-level fine-tuning从而用于ranking。Table 6总结了每次部署的A/B test收益:Offline V1:在最近的512 engagement-based feedback events(例如,likes)上训练。Offline V2:扩展到consumption-based signals(例如,streams with provided completion rate information)。Offline V3:将上述两种信号类型合并为a heterogeneous user sequence。Real-time V1:通过将encoder缩减6倍从而优化low-latency inference。
每一代新模型在总收听时间(
total listening time: TLT)和like likelihood方面都带来了可测量的提升,并通过针对现有production stack的A/B tests进行评估。由于所有部署都是累积的,每次改进都建立在先前的transformer models和其他non-deep-learning enhancements的基础上。Offline V4 (ARGUS)结合了多项进步:显著更大的encoder(126M参数)、扩展的user context(最多8192 events)以及本文提出的training pipeline。ARGUS实现了迄今为止最强的transformer-driven online gains:总收听时间增加了+2.26%,like likelihood增加了+6.37%。虽然理想情况下我们希望测量最大的1B configuration的在线提升,但由于大规模在线实验的高计算成本,这超出了范围。
自本文初次提交以来,我们进一步将
ARGUS的一个较小的real-time variant直接集成到production ranker中,观察到与daily offline embeddings结合时具有互补的收益。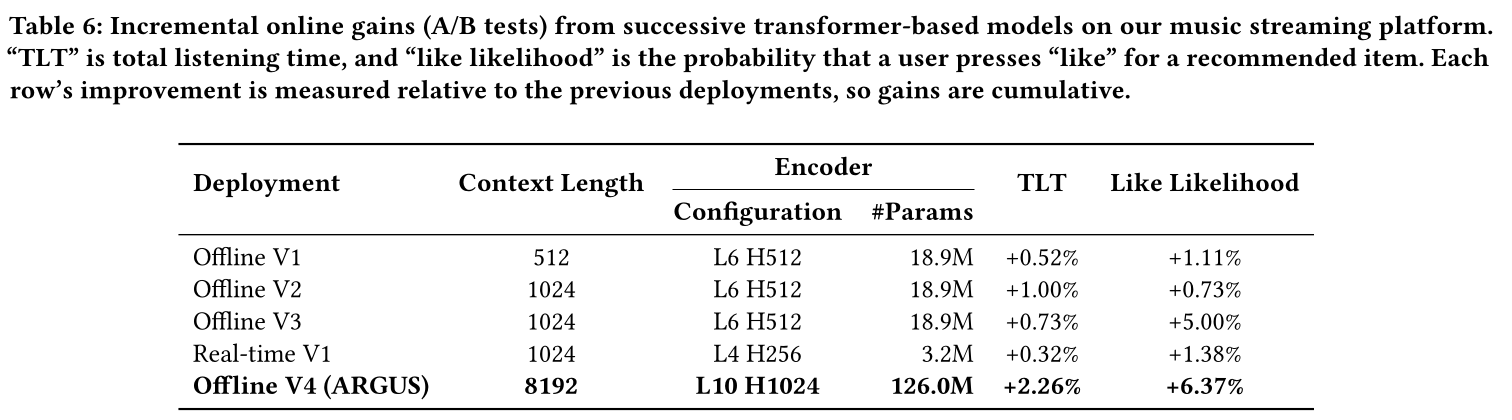
1.4 讨论
Relation to HSTU:除了实验章节中的encoder comparison外,我们还强调了HSTU和ARGUS之间的几个实际差异,这些差异对于解释结果很重要。Two pipelines vs. a unified formulation:原始的HSTU论文采用了两种不同的过程:一个包含了
interleaved item-action tokens的ranking task。一个包含
negative interactions但将predictions限制在positive events的retrieval task。
相比之下,
ARGUS利用统一的pre-training objective,结合了feedback prediction(在概念上类似于HSTU的ranking loss)和第二项任务(预测all item interactions,包括negative interactions)。Context modeling:HSTU将context changes表示为separate events。ARGUS将context视为每个interaction的一部分:要么作为stream中的an explicit token(full version),要么融合到a single interaction embedding中(simplified version)。Serving cost for ranking:ARGUS被设计为在serving时成本低廉,尤其是在offline setting中:我们fine-tune为双塔模型,每日刷新user embedding并使用dot-product scoring。这使得impression-level ranking比real-time target-aware方案便宜得多(real-time target-aware方案需要将user state与每个candidate item联合地编码)。
Practical Considerations:Generalization across domains:虽然本文专注于音乐推荐,但我们在其他large-scale domains也应用了相同的架构,包括电子商务市场、杂货配送和广告,观察到了一致的收益。Cold start:ARGUS不依赖于an itemID lookup:item representations可以从任意content and metadata features来形成,并且可以完全省略ItemID feature。在我们跨多个领域的部署中,我们尝试了不同的item-feature configurations,并观察到了一致的性能,表明该方法没有fundamental cold-start limitations。Additional fine-tuning scenarios:自初次提交以来,我们探索了impression-level ranking之外的additional fine-tuning场景。特别是,在几个领域,我们已经部署了一个candidate-generation model:使用相同的pre-training方案,我们微调backbone以预测future positive interactions。我们还测试了更具挑战性的objectives,例如生成用户的整个next session,并发现相同的backbone可以支持这些更丰富的targets。
1.5 结论
我们提出了一个
scalable的框架,用于训练大型recommender transformer,并成功部署在现实世界的音乐推荐系统中。受强化学习和大型语言模型进展的启发,我们引入了一种新颖的autoregressive pre-training task,该任务统一了next-item prediction和feed-back prediction,鼓励模型既模仿observed behavior,又进行超越它的泛化。