一、 PLUM [2026]
《PLUM: Adapting Pre-trained Language Models for Industrial-scale Generative Recommendations》
大型语言模型(
Large Language Models: LLM)为信息任务带来了新的建模范式和计算范式。推荐系统是一个关键的应用领域,有望从这些大型模型中固有的sequence modeling能力和世界知识中显著受益。在本文中,我们介绍了PLUM,一个旨在将pre-trained LLMs适配于工业级推荐任务的框架。PLUM包括使用Semantic IDs的item tokenization、在domain-specific data上的continued pre-training: CPT,以及针对recommendation objectives的task-specific fine-tuning。在fine-tuning方面,我们特别关注generative retrieval,其中模型被直接训练为基于user context来生成Semantic IDs of recommended items。我们在大规模内部视频推荐数据集上进行了全面的实验。我们的结果表明,与使用large embedding tables构建的经过高度优化的production model相比,PLUM在检索方面取得了实质性的改进。我们还展示了模型检索性能的scaling研究、我们在CPT方面的经验、对Semantic IDs的一些增强,以及training和inference方法的概述(这些方法使得该框架能够在YouTube上向数十亿用户发布)。推荐系统在现代数字平台中至关重要,深刻影响着用户发现内容和与之互动的方式。过去几十年见证了深度学习模型在推荐系统的检索阶段(
retrieval stage)和排序阶段(ranking stage)取得的显著成功。尽管使用了神经网络,但industrial recommenders中的主导范式仍然依赖于大规模embedding tables来表示high-cardinality categorical features,如item IDs。在这些Large Embedding Models: LEMs中,绝大多数参数位于这些embedding tables中。虽然这种架构选择在记忆user-item interactions方面非常有效,但它阻碍了更深的、更复杂的网络的潜在收益。这种专注于扩大embedding tables的scaling方法论,与LLM的scaling方法论形成对比,后者强调增加神经网络规模以学习compositions of compact input tokens。The success of LLMs激发了一种新兴范式转变从而用于构建推荐模型。LLM中固有的sequence modeling能力和庞大的世界知识为构建更智能、更个性化的推荐系统提供了机会。然而,将LLM适配于推荐任务并非易事。主要挑战在于弥合领域差距(domain gap):LLM并未在target domain的user behavior data和item corpus上被预训练,这使得它们更难从user activities和细微的item quality中理解user preferences。因此,直接应用现成的LLM到推荐任务中,即使在小型公共数据集上也显示出持续的性能差距。其次,基于large embedding tables的traditional input representation带来了scaling挑战。这些tables需要大量的训练数据,使得训练大型Transformer架构成本高昂。本文朝着教会
LLM解决推荐任务的方向迈出了一步。我们介绍了PLUM,一个用于有效地将pre-trained LLMs适配于工业级generative recommendation的框架。PLUM包括三个关键阶段:Item tokenization:语料库中的每个item由a sequence of discrete tokens来表示,称作Semantic IDs: SIDs。基于先前使用RQ-VAE的工作,我们引入了一套新技术(称为SID-v2),用于整合user behavioral signals和multi-modal content embeddings,并通过multi-resolution codebooks和progressive masking来改善hierarchical integrity。Continued pre-training: CPT:在此阶段,pre-trained LLM的vocabulary被扩展以包含新的SID tokens。模型在a mixture of domain-specific item data and user sequences, and general-domain text data上进一步被预训练,以将新的SID modality与模型现有知识进行对齐。Task-specific fine-tuning:最后,模型针对specific recommendation objectives进行微调。虽然PLUM可以支持各种下游任务,但本文重点关注其在generative retrieval中的应用,其中a decoder-only model被训练为自回归地生成SIDs of next items,其中用户可能与这些next items进行互动。Generative retrieval不需要维护a separate index of an item corpus,并且绕过了embedding-based retrieval中的dot-product limitation(《On the Theoretical Limitations of Embedding-Based Retrieval》)。
PLUM框架旨在解决上述挑战。continued pre-training: CPT通过enriching the pre-trained LLMs with domain corpus and user behavior patterns来弥合domain gap。我们观察到CPT后的模型可以展示出basic few-shot learning capability,从而根据SID input来生成text tokens。SID-based input representation绕过了Large Embedding Models的scaling bottleneck。我们的实验表明,通过将模型复杂度从input embeddings转移到神经网络,基于PLUM的generative retrieval相比a production Transformer-based retrieval model with large embedding tables可以实现显著更好的样本效率。因此,尽管PLUM retrieval使用的Transformer架构的dense parameters是Large Embedding Models的100倍,但由于更快的收敛速度,retrieval任务的overall training cost与Large Embedding Models相当。我们还观察到了有效的scaling:retrieval性能持续提升,逼近一个Mixture-of-Experts: MoE模型,其activated parameters超过900M(总参数约4.2B)。除了这些贡献之外,我们还将分享在大规模生产环境中部署
PLUM-based retrieval的实际经验,特别是在online A/B testing中对PLUM retrieval和Large Embedding Model-based retrieval的比较。PLUM框架已在YouTube推荐中投入生产,通过online inference和offline inference为多个核心页面同时提供长视频和短视频的retrieval服务。
1.1 相关工作
我们看到了受
LLM最新进展启发的两条主要研究路线。第一条路线关注使用
Transformer架构(或其变体)来scaling upLarge Embedding Models的神经网络组件。第二条路线聚焦于
token-based generative recommendation,并将recommendation retrieval重新定义为seq2seq transduction任务。
Sequential Recommendations:modeling user sequences and feature interactions一直是改进推荐模型的关键领域,从使用经典sequential neural networks(《Session-based Recommendations with Recurrent Neural Networks》、《Self-Attentive Sequential Recommendation》)到设计定制化的feature interaction components(《DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-scale Learning to Rank Systems》、《Wukong: Towards a Scaling Law for Large-Scale Recommendation》)。最近,新兴趋势是使用
Transformer-like架构将user history和heterogeneous features统一到单个序列中(《MTGR: Industrial-Scale Generative Recommendation Framework in Meituan》、《Towards Large-scale Generative Ranking》、《Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations》),显示出相比traditional MLP架构更好的scaling。此外,训练范式本身也在向
LLM的方向演变,一些工作采用self-supervised pre-training objectives,随后进行task-specific fine-tuning(《PinFM: Foundation Model for User Activity Sequences at a Billion-scale Visual Discovery Platform》、《Foundation Model for Personalized Recommendation》)。所有这些进展的共同点是它们持续依赖大规模
embedding tables来表示categorical features。我们的工作通过用compact input tokens替换large embedding tables来脱离这一范式。除了SID,我们还通过tokenizing numerical features或直接使用dense embedding features作为soft tokens,来使用LLM处理heterogeneous features。Semantic IDs and Quantization:representing items as sequences of discrete tokens(即,Semantic IDs: SIDs)的概念,已成为traditional ID embeddings的一种强大替代方案。这种方法允许将items视为一种“语言”,并可由sequence models进行处理。早期工作证明了training retrieval models from scratch以预测SIDs的可行性(《Recommender systems with generative retrieval》);后续研究显示,SIDs可以被哈希处理以替代random item ID embeddings,从而增强ranking models的泛化能力(《Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendation》、《Enhancing Embedding Representation Stability in Recommendation Systems with Semantic ID》)。近期大量研究致力于通过将
diverse signals融入quantization过程,来提升SIDs的质量和表达能力。这包括融合multi-modal content features(《MMQ: Multimodal Mixture-of-Quantization Tokenization for Semantic ID Generation and User Behavioral Adaptation》),以及从user behaviors中注入collaborative filtering signals(《BBQRec: Behavior-Bind Quantization for Multi- Modal Sequential Recommendation》、《Semantic IDs for Joint Generative Search and Recommendation》、《Recommender systems with generative retrieval》、《DAS: Dual-Aligned Semantic IDs Empowered Industrial Recommender System》)。PLUM与这一研究方向并行。与
MMQ(《MMQ: Multimodal Mixture-of-Quantization Tokenization for Semantic ID Generation and User Behavioral Adaptation》)(为每种模态生成不同tokens)不同,我们简单地将multiple content embeddings拼接起来,然后通过MLP进行编码,从而提供了supporting more embeddings的灵活性。在融入
user behaviors方面,多数工作是在quantization过程中将协同过滤(collaborative-filtering: CF)item embeddings与content embeddings融合,但CF-based item embeddings通常随item popularity变化而动态变化,需要频繁地重新训练quantizer及下游模型。我们通过在a contrastive training objective中使用CF signals来引导quantizer从content information中捕获有用信息,从而避免了这一问题。
此外,我们还提出了另外两项关键创新,以改进
SID training与generative retrieval之间的对齐。Generative Retrieval and Alignment:generative retrieval将recommendation retrieval重新定义为sequence-to-sequence任务,其中模型以自回归方式直接生成the SIDs of relevant items。自从在document search(《Transformer memory as a differentiable search index》)和recommendation(《Recommender systems with generative retrieval》)领域的开创性工作以来,这一想法在业界获得了显著关注(例如,《Generative Recommendation with Semantic IDs: A Practitioner’s Handbook》、《Semantic IDs for Music Recommendation》、《Generative Retrieval and Alignment Model: A New Paradigm for E-commerce Retrieval》、《Generative Next POI Recommendation with Semantic ID》)。例如,
OneRec(《OneRec Technical Report》)采用an encoder-decoder architecture来生成video SIDs,并利用RL training通过a reward model提升模型质量。其他工作(
《Unifying Generative and Dense Retrieval for Sequential Recommendation》、《Sparse Meets Dense: Unified Generative Recommendations with Cascaded Sparse-Dense Representations》)提出了hybrid models,同时生成SIDs和dense embeddings以缓解quantization带来的information loss。
这些方法的一个共同点是它们大多专注于
training generative models from scratch。我们的工作则侧重于将SIDs与LLMs对齐,并研究LLM pre-training和CPT对generative retrieval性能的影响。虽然一些研究(《Aligning Large Language Models with Recommendation Knowledge》、《A Decoder-only Foundation Model for Personalized Ranking and Recommendation》)探索了将LLM与推荐任务对齐,但它们的重点主要在于language interfaces。关于如何有效地将SID作为一种新模态整合的研究是有限的。
1.2 PLUM Framework
1.2.1 Semantic IDs
一个
Semantic ID: SID被概念化为:从an item’s underlying content features导出的a tuple of discrete codewords。这个过程涉及两个主要阶段:(1):将high-level content features编码为a dense semantic embedding。以及
(2):将该embedding量化(quantizing)为a hierarchical tuple of codewords。
a generative retrieval model的有效性根本上取决于SID的语义丰富性(semantic richness)和结构完整性(structural integrity)。基于foundational TIGER framework(该框架利用Residual-Quantized Variational AutoEncoder: RQ-VAE),我们对这个generation过程引入了一系列重大改进。初始方法受限于仅依赖a single content embedding source、以及在ID structure中缺乏collaborative signals。我们的方法旨在生成更全面、更对齐user behavior、且更具hierarchically coherent的SIDs。Figure 1展示了我们的training the SID model的整体设计。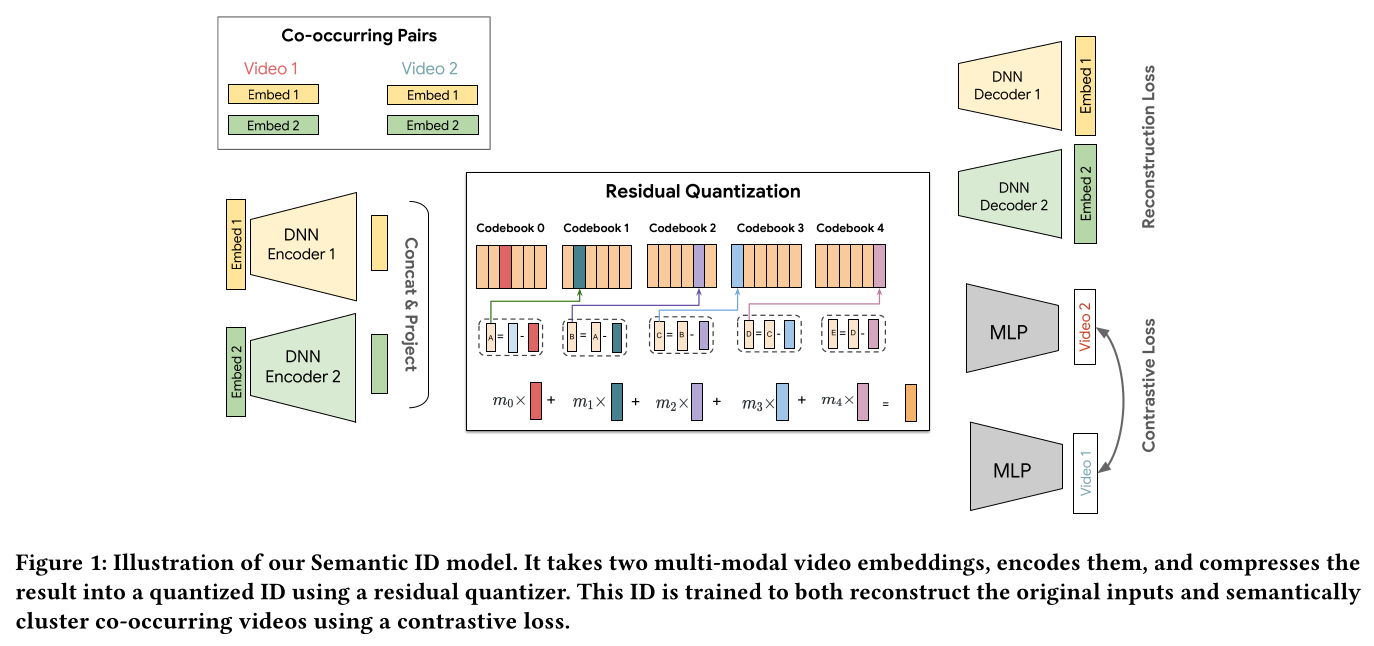
Fused Multi-Modal Content Representation:《Recommender systems with generative retrieval》中依赖a single content representation的一个主要局限性是其无法捕获复杂media items的多方面性质。例如,一个视频的完整语义含义是通过其文本元数据、视觉内容、以及音频的组合来传达的。单模态representation本质上忽略了丰富的、正交的信息来源。为了克服这一点,我们将框架设计为对
input sources的具体数量和类型是无感知的(agnostic),使其能够接收并融合multiple, heterogeneous representations。该模型被设计为:接受每个item的a set of distinct embedding vectorsmultiple representations的fusion通过一个单独的embedding encoder将
latent vector然后拼接这些
latent vectors从而得到然后紧跟着一个投影层,形成一个统一的
feature encoded vector
通过集成来自各模态的信息,我们为后续的
RQ-VAE quantization过程形成了更优的input,确保resulting SIDs对item’s content有了全面的理解。Hierarchical Refinements in Quantization:我们进一步改进RQ-VAE架构本身,以产生更高效的、更有意义的hierarchy。这涉及两个关键创新:Multi-Resolution Codebooks:先前工作《Recommender systems with generative retrieval》采用a fixed uniform-resolution codebooks,这可能参数效率低下,导致SID space庞大且稀疏,其中大多数潜在codeword combinations未被分配。我们将其替换为a multi-resolution codebook structure,其中initial SID levels具有高分辨率且最具区分性,而后续codewords编码low-entropy residuals并具有较低分辨率。具体而言,codebook cardinality作为quantization level的函数:SID。Progressive Masking:为了在residual quantization期间强制更严格且更可解释的hierarchy,我们引入了progressive masking。具体而言,我们定义了一个binary mask scalarcodebook level,使得codebook levels的总数。该mask用于在SID training中选择first r codebook levels。
RQ-VAE with Co-occurrence Contrastive Regularization:纯粹从item’s intrinsic content导出的SID可能无法完全捕获用户在recommendation context中感知的similarity。user behavior提供了一个强大的、外部的signal of video relatedness;经常被一起观看的视频通常在语义上是相关的。为了弥合content-based similarity和behavior-based similarity之间的gap,我们在ID generation阶段直接注入了一个强的collaborative signal,在RQ-VAE training objective中引入了一个co-occurrence contrastive loss项objective function旨在根据user interaction sequences中的item co-occurrence patterns来改造embedding space。该loss鼓励模型为经常一起出现的items生成相似的SID representations,同时推开不常一起出现的items的representations。具体而言,contrastive loss定义为:其中:
video representation,batch size。representation。
论文采用的是类似
SimCLR / NT-Xent的对称对比损失:不仅把原始视频positive pair。所以loss要对pairs分别计算一次,而不是只对SID Training Loss:除了《Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendations》中引入的training loss之外,我们还引入了co-occurence contrastive loss项。具体而言,overall loss定义为:其中:
multi-modal embedding的重建损失(reconstruction loss)。codebook中最近的code(对应的vector),stop-gradient算子。如Figure 1所示,final quantized vectorprogressive masking计算为每层所选codes之和:quantized vectorinput embeddings注意,这里是
knn最近邻分配,而不是knn-means自动聚类。二者区别在于:knn最近邻分配只会修改分配的cluster编号,不会移动cluster质心。所以这里需要对质心进行梯度反向传播,从而更新质心knn-means自动聚类不仅修改分配的cluster编号,也会移动cluster质心。也有很多论文直接使用的是knn-means自动聚类。
一句话总结:
KNN只改变分配;码本是否变,取决于你是否执行码本更新。经典k-means会重算质心,RQ-VAE的码本是可学习参数,需要用损失或EMA显式更新。
1.2.2 Continued Pre-training
在创建
SID vocabulary之后,continued pre-training: CPT阶段的一个主要目标是开发a base model checkpoint,其中SID tokens在语义上得到基础支撑,并与existing text tokens of the base language model进行对齐。为此,我们在一个大规模语料库(由两个主要数据源而构成)上使用next-token predictions来训练模型:User behavior data:该数据源对于personalization和捕获watch histories至关重要。在训练期间,每个样本利用user watch histories以及额外的watch features来建模user behavior sequences。Video metadata corpus:这个大规模语料库旨在建立SID与其对应文本特征之间的强关联。每个样本包括一个视频的SID、标题、描述文本、ASR字幕、频道名称(channel name)、以及人工合成生成的数据。
Table 1展示了我们的CPT训练数据模式。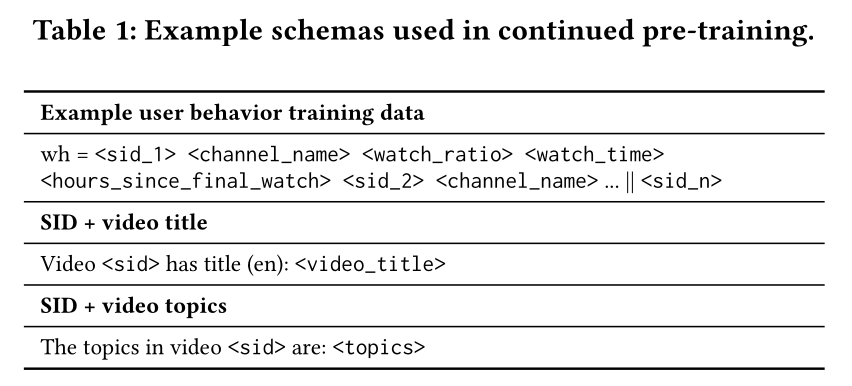
Data Mixture and Training:CPT阶段的训练集由user behavior data和video meta-data corpus的mixture组成,每个数据源各占训练样本的50%。CPT阶段进行了1 million training steps,使用batch size = 16,总计约260 billion tokens。我们设置了多项评估,以衡量generating SIDs based on user history的性能、通过held-out video metadata corpus联合建模SID和language的能力,并通过standard text benchmarks跟踪general language capabilities的退化情况。In-context Learning:CPT模型在a mixed corpus of SIDs and natural language上训练后,保留了生成自由格式文本的灵活性,并具备in-context few-shot learning的能力。我们在附录A.3中提供了一些示例。
1.2.3 Generative Retrieval
虽然
continued pre-training: CPT阶段使模型能够根据user history生成next-video SIDs,但后续的Supervised Fine-Tuning: SFT阶段对于使其专门化以完成retrieval任务至关重要。此SFT阶段使模型能够融入更丰富的feature set,特别是real-time context,并能直接针对a reward signal(这个奖励信号与user experience对齐)进行优化。这个
fine-tuning采用标准的自回归最大似然目标(autoregressive, maximum-likelihood objective)。模型学习预测ground-truth videos的SID tokens,这些ground-truth videos定义为:在给定user context和user history的情况下,来自user logs中的clicked videos。具体来说,模型被训练以最小化以下loss:其中:
clicked videoSID。而
loss中对sampled examples进行加权。
如
Figure 2所示,input prompt不仅包含SID tokens和custom tokens for numerical features,还包含可由pre-trained LLMs自然编码的其他text features。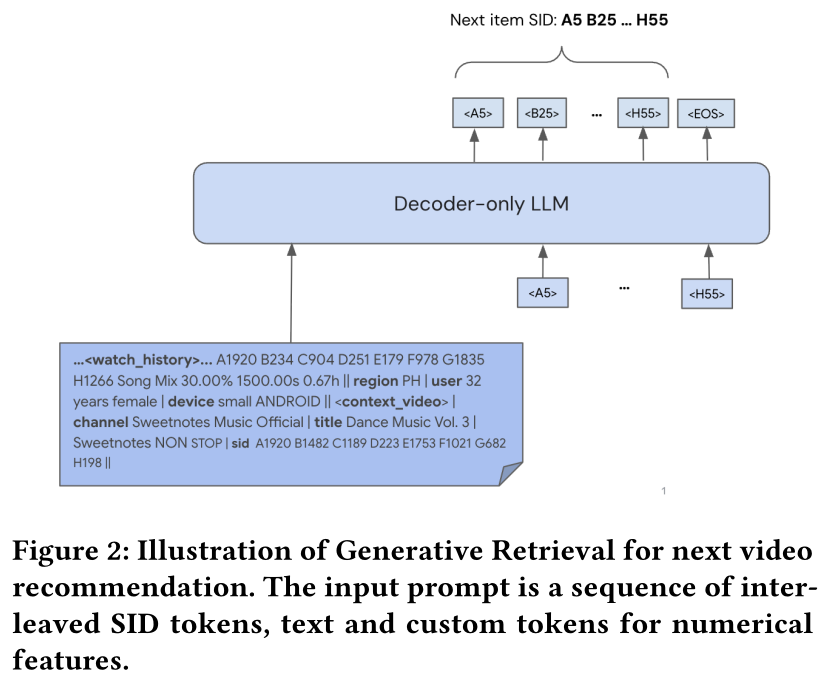
在
inference过程中,我们使用beam search来解码multiple SID sequences,这些SID sequences作为the set of retrieved candidates。每个generated SID随后被映射到我们billions-scale corpus中的一个真实视频。虽然此生成过程可能产生无效SID(幻觉)、或SID-to-video的冲突,但我们观察到:经过SFT之后的幻觉率非常低(< 5%),且SID-to-video mapping唯一性保持较高(见Table 4)。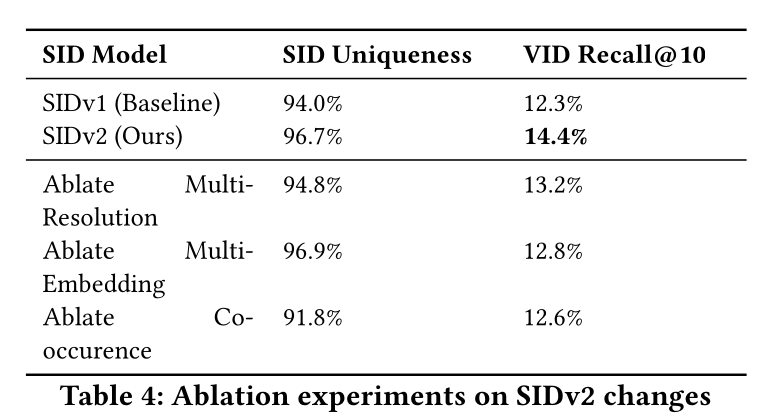
1.3 实验
在本节中,我们进行了一组全面的实验来验证
PLUM框架。我们首先将
PLUM-based generative retrieval model与一个Transformer-based large-embedding retrieval model(该模型贡献了生产中大部分impressions)进行性能比较。随后,我们展示了我们提出的
SID enhancements功能的有效性。接着,我们对
PLUM框架中的两个关键组件进行了消融研究:首先量化了
continued pre-training: CPT阶段的精确影响。然后评估了从
pre-trained LLM中初始化的价值。
最后,我们展示了详细的
scaling研究,以分析模型大小、计算量与retrieval性能之间的关系。
1.3.1 Generative Retrieval 的性能
传统的推荐系统使用
large embedding models来推荐candidates。然而,generative retrieval相比传统系统具有诸多优势。在本节中,我们研究generative retrieval在YouTube生产环境中的有效性。
a. Experiment Setup
Model:在以下实验中,我们训练了一个来自Gemini-1.5 Mixture-of-Experts: MoE家族的、拥有900M activated-param的PLUM模型,该模型同时应用于长视频(Long Form Video: LFV)和短视频(Shorts)。该模型从Gemini热启动,并按照上述描述在new engagement data上持续地微调。训练数据是a mixture of the most recent data and historical data。在serving期间,使用beam search进行解码从而得到target sequences。在我们的实验中,beam search的表现优于random decoding,尽管以牺牲一些多样性(diversity)为代价。random decoding:在自回归生成每一个SID token时,不选概率最大的token(这是确定性的结果),也不像beam search那样保留多条最优候选路径,而是按照模型输出的概率分布随机抽取next token。Baseline:我们将上述模型的性能与traditional Large Embedding Models retrieval进行比较。此baseline是表现最佳的production model,来自《Top-K Off-Policy Correction for a REINFORCE Recommender System》的早期工作以来已经过高度优化。该模型也基于Transformer架构,但其大部分参数位于embedding layer,input item IDs和output item IDs的vocab sizes约为Large Embedding Models的神经网络仅占其总参数的0.4%,而PLUM的神经网络则占其总参数的90%。
b. Experiment Results
Recommendation Quality:我们从几个不同维度评估推荐质量。首先,我们将
recommender的有效词表大小(effective vocab size)定义为覆盖95% of its impressions所需的unique videos数量。通常,较大的vocab size对于个性化发现小众内容是可取的,这表明模型具有更好的泛化能力。接下来,我们使用两个指标来比较推荐的有效性:点击率(
click-through-rate: CTR)和推荐接受度(Recommendation Acceptance)。对于推荐接受度,我们同时比较了观看视频时长(WT/View)和观看视频的完成度占比(WF/View)。
在所有情况下,我们都报告了
900M MoE模型指标与Large Embedding Models模型指标的比率,如Table 2所示。我们观察到:
PLUM模型实现了更大的effective vocab size;同时在与user reactions相关的指标上,其性能与LEM相比具有竞争力。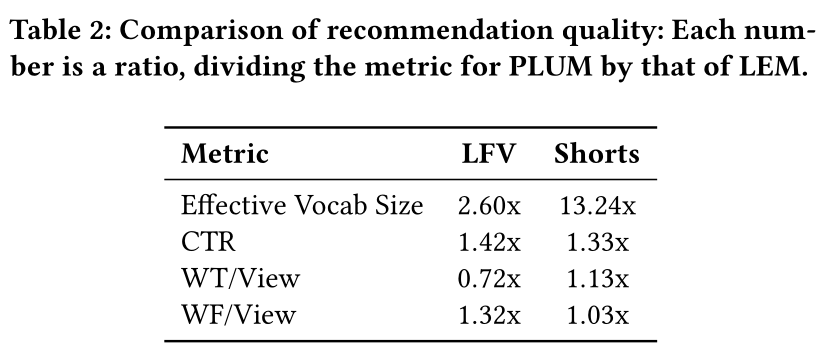
在线实验:我们通过将
PLUM模型的recommendations添加到candidate pool中进行了在线实验。为了公平比较,我们将production中表现最佳的retrieval model的配额增加(以相同数量),并将其用作baseline。我们将此修改后的production baseline记为LEM+。在Table 3中,我们报告了在LFV和Shorts上,相对于LEM+在四个关键指标上观察到的指标变动。这表明,即使没有large embedding tables,PLUM-based retrieval也能在现有系统之上增加unique value。这个
online实验用的是增加candidate而不是替代candidate,因此很难说明PLUM要比production model更好,只能说明PLUM可以作为一路额外的检索通路。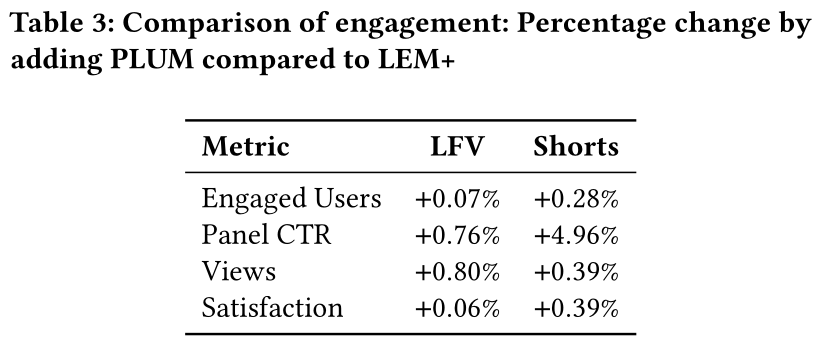
Sample Efficiency:在我们的研究中,PLUM模型具有极高的样本效率。900M MoE模型每天训练约250M个样本。相比之下,传统Large Embedding Model每天训练数十亿个样本。这种样本效率也使得这些模型在实际生产中具有实用性,尽管每个样本的训练成本要高得多。与Large Embedding Model相比,900M MoE模型训练所需的浮点运算量(FLOPs)不到Large Embedding Model模型的0.55倍。
1.3.2 Semantic IDs Ablation Study
在
Table 4中,我们讨论了我们对先前SID(Recommender systems with generative retrieval)引入的不同改动的重要性。我们将先前工作称为SIDv1,并在表中将我们提出的方法称为SIDv2。由于每个SID模型都会导致不同的indexing structure,我们报告index uniqueness,表示语料库中有多少视频在SID space中被唯一表示,以及在SID上训练GenRetrieval模型后的final Video Recall@10。Video Recall@K是通过计算在PLUM的Top K SID predictions中成功检索到a specific video的召回率来确定的。当一个SID映射到多个视频时,我们在计算召回率指标时随机采样一个视频。我们在一个简单
setting中对SIDv2的改动进行了消融实验,使用了一个900M MoE PLUM retrieval model,没有进行CPT并且prompt中没有watch history。如Table 4所示,这些实验评估了Semantic ID的uniqueness和下游的generative retrieval VID Recall@10。结果表明,所有改动都改善了generative item retrieval的召回率。值得注意的是,引入Co-occurrence alignment任务同时大大提高了Semantic ID uniqueness和召回率。
1.3.3 Impact of Continued Pre-training
为了衡量
continued pre-training阶段的重要性,我们评估了其对generative retrieval最终模型的训练效率和retrieval性能的影响。
a. Experiment Setup
我们的训练方法包含两个阶段:
continued pre-training和generative retrieval fine-tuning,每个阶段都有特定的learning objective和相应的一组超参数。为了评估每个阶段的独特贡献,我们设计了一个受控的2 x 2消融研究。这涉及四个模型配置,它们共享相同的decoder-only Transformer architecture。我们在此研究中使用MoE-900M架构。这四个模型如下:R1: retrieval SFT (random init):Transformer模型直接在generative retrieval task上训练,模型权重随机初始化。R2: retrieval SFT (LLM init):该模型从pre-trained LLM checkpoint初始化,但跳过CPT阶段。CR1: CPT (random init) + retrieval SFT:模型训练遵循PLUM的两个训练阶段,但CPT中使用的模型是随机初始化的。retrieval SFT也是LLM init的。CR2: CPT (LLM init) + retrieval SFT:这代表了我们提出框架的完整且预期的实现。retrieval SFT也是LLM init的。
b. Experiment Results
Impact of Continued Pre-training:主要结果总结在Table 5中。遵循scaling研究,四个模型中的每一个都在一个大型的、held-out next day的数据集上进行评估,我们报告recall@10作为retrieval指标。在R1和CR1(或R2和CR2)之间存在很大的性能差距,显示了CPT对retrieval fine-tuning的益处。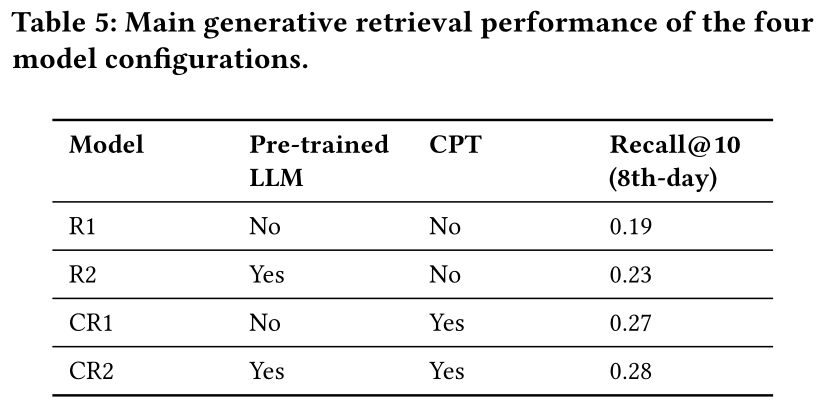
此外,
Figure 3显示了8-th day recall@10和training loss随training steps的变化。很明显,models with CPT可以更快地收敛。因此,CPT可以有益于task-specific fine-tuning的训练效率,特别是当多个下游任务共享同一个CPT模型时。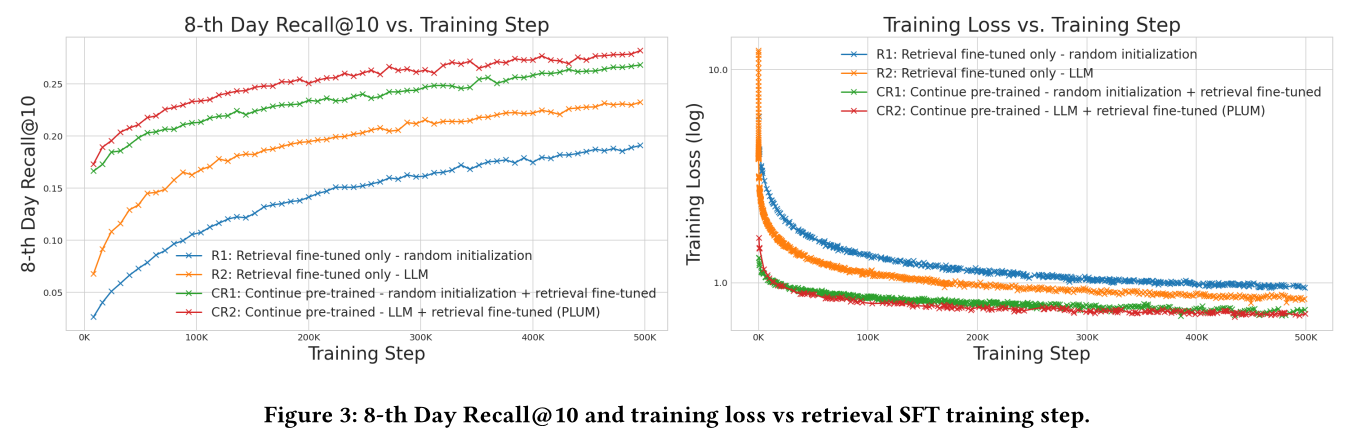
Impact of Pre-trained LLMs:现在我们来研究training from a general-purpose LLM相比training from a randomly initialized state的好处。从Table 5的结果中浮现出一个一致的模式:models initialized from a pre-trained LLM在with or without CPT的情况下始终优于其随机初始化的对应模型。我们假设这一优势主要源于pre-trained LLM对自然语言的已有理解,或者通过大规模LLM pre-training所学到的general sequence processing能力直接对recommendation有用。对这一观察的进一步研究超出了本文的范围。
1.3.4 Scaling Study
在本节中,我们使用
YouTube production data对generative retrieval models进行scaling研究。我们使用了Gemini-1.5 Mixture-of-Experts: MoE(《Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context》)模型家族的四种不同尺寸:MoE-110M、MoE-370M、MoE-900M和MoE-3B(这里的尺寸表示每个token的activated parameters数量),它们的总参数范围从不到1B到超过10B。特别地,我们的目标是回答:(1):loss如何随不同的模型尺寸和compute而scale up?(2):retrieval指标如何随不同的模型尺寸和compute而scale up?(3):对于不同的compute预算,最佳模型尺寸是什么?
a. Experiment Setup
我们的研究在一个
production规模的YouTube dataset上进行,针对candidate generation任务,其目标是根据a sequence of watch history and contextual features来预测next video ID。模型从continued pre-training checkpoints进行热启动,并在7天的数据上进行微调,然后在第二天(第8天)进行评估。完整详情请参阅附录A.1。
b. Experiment Results
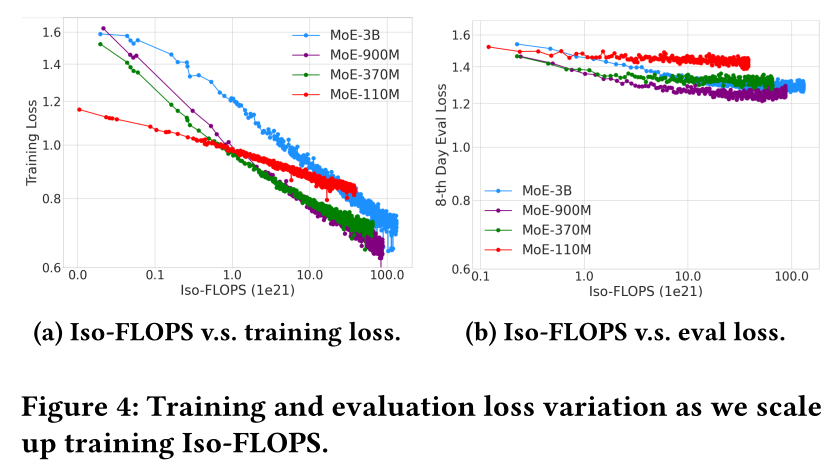
Loss Scaling with Compute and Model Size:Figure 4显示了training/evaluation loss(第8天)与training Iso-FLOPS之间的相关性。Figure 4a揭示了每个模型尺寸的Iso-FLOPS与training loss之间存在明显的幂律相关性(power-law correlation)。随着Iso-FLOPs的增加,代表训练损失前沿(training loss frontier)的最优模型尺寸(optimal model size)逐步shift。这种shift从MoE-110M(红线)开始,转移到MoE-370M(绿线),再到MoE-900M(紫线),并假设最终会到达MoE-3B(蓝线)。Figure 4b显示,在最终开始饱和之前,每个模型尺寸的Iso-FLOPS与evaluation loss之间也存在power-law correlation,我们将其归因于我们的扩展训练(extensive training)。我们还观察到,
evaluation loss frontier向更大模型shift的速度明显早于training loss,这表明更大的模型对future data distributions具有更好的泛化能力。
Retrieval Metric Scaling with Compute and Model Size:类似地,在Figure 5中我们报告了training/evaluation Recall@10(第8天)与training Iso-FLOPS之间的关系,两个轴均以对数尺度呈现。结果与Figure 4中的类似,有一点不同:在Figure 5中,evaluation Recall@10显示出更少的放缓迹象,这表明模型在生成准确的且完整的sequences从而得到correct document方面持续改进。此外,三个较小的模型已经处理了超过一个epoch的数据,其中MoE-110M训练了多达4.24 epochs,但仍未显示出过拟合迹象(见Figure 5b)。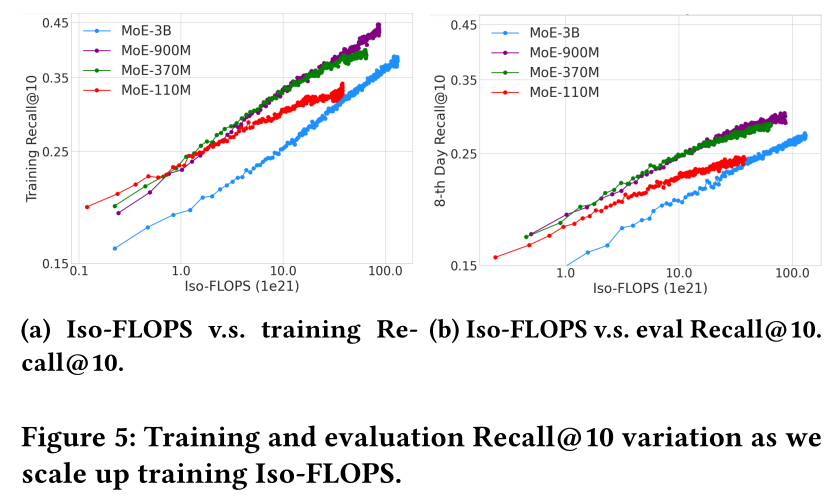
Optimal Model Size for Fixed Iso-FLOPS Budgets:在Figure 6中,我们展示了随着给定Iso-FLOPs预算的增加,optimal model size逐渐向更大模型转移。请注意,我们对每个模型使用恒定的学习率,使我们能够通过a single run直接评估每个Iso-FLOPs预算下的模型性能。与Chinchilla论文(《Training compute-optimal large language models》)类似,在Figure 6b中,对于我们考虑的大多数Iso-FLOPs预算,存在一个峰值。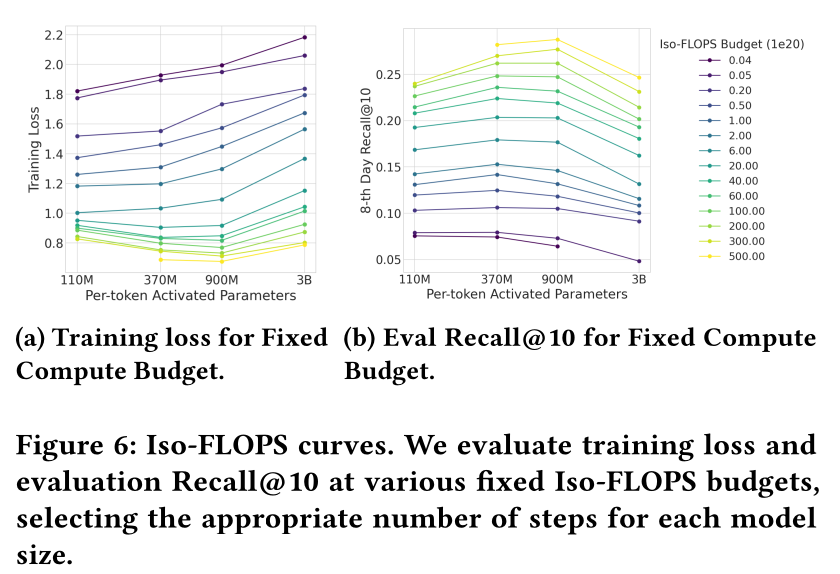
c. 局限性讨论
我们注意到,在我们考虑的计算预算下,
MoE-3B模型的表现并未超过MoE-900M模型。我们的scaling研究受到计算资源的限制。次优的超参数设置(suboptimal hyperparameter setup)可能是一个重要因素。例如,我们的初步研究表明,对于相同的模型尺寸,较大的batch size与较高的训练效率相关。由于我们为每种模型尺寸分配相同的训练资源,并使用能饱和HBM的batch size(见Table 6),较大的模型可能因其batch size相对较小而处于劣势。实际上,在训练结束时,MoE-3B模型仅处理了0.57 epochs的训练数据(约5B样本),与第二大模型相比有超过2倍的差距。我们对generative retrieval任务的scaling研究表明,compute-optimal training需要同步scale训练样本和模型尺寸。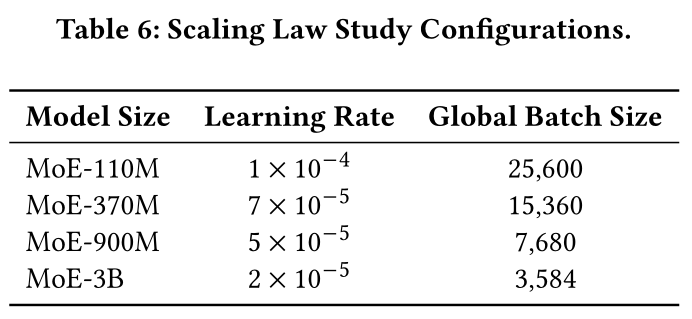
1.4 结论与未来工作
我们介绍了
PLUM,一个用于将pre-trained LLMs适配于大规模推荐任务的框架。我们的方法通过SIDv2增强了item tokenization,使用large-scale continued pre-training阶段来使LLM与user behavior对齐并将SID建立在文本基础上,随后进行supervised fine-tuning阶段,从而使模型在generative retrieval中表现出色。作为
YouTube中的a launched platform,PLUM能够为当前系统增加unique value,同时是我们第一个没有使用large embedding tables而构建的神经模型。我们的消融实验验证了CPT阶段的价值、从pre-trained LLM初始化的益处、以及我们提出的SID技术。本文是关于将LLM与现实世界推荐系统对齐的初步研究,开辟了未来的研究方向,例如将PLUM框架应用于ranking和personalized search等其他任务,开发用于candidate diversity的新的解码策略,以及实现SID和自然语言的无缝generation。
1.6 附录
A.1 Scaling Study Experiment Setup
Dataset:我们的研究是在一个production数据集上进行的,该数据集源自YouTube的一个关键surface,该surface根据当前观看的视频和其他contextual signals(例如,watch history)(参见《Recommending what video to watch next: a multitask ranking system》中的Figure 4)来推荐接下来要观看的视频。这里的推荐系统采用多阶段架构,包括candidate generation、pre-ranking和ranking等阶段。我们的研究集中于candidate generation阶段,并针对包含数十亿视频的video corpus来评估retrieval性能。Training and Evaluation:我们的
input prompt格式如下:"watch history | user features | context video features",其中watch history是按时间顺序排列的sequence of watches,每个watche由SID tokens和其他feature tokens的拼接来表示。在本研究中,input sequence length固定为1536 tokens,大约可以覆盖最近的100 watches以及其他特征。SFT labels是使用YouTube上的next watch,并采用基于user engagement and satisfaction signals的降采样机制来选择的。next watch的SID tokens被用作prediction targets。我们随机打乱了连续
7天(从2025年7月)的数据用于训练。评估在第8天进行。我们的实验使用了
1,024 Google’s v6e Tensor Processing Units: TPUs,每块配备32GB High Bandwidth Memory: HBM。我们并行运行了
4 trainers,每个trainer使用256 TPUs。
Hyperparameter Selection:我们使用MoE-900M模型进行了一项试点研究,以确定模型对global batch size和学习率的敏感性(详见附录A.2)。基于此项试点研究的经验,我们在每种情况下都将batch size设置为大致饱和HBM的程度,因为结果表明较大的batch size更可取。在学习率方面,以MoE-900M使用的scaling law研究(例如《Training compute-optimal large language models》)不同,我们采用了恒定的学习率。这种选择基于两个原因:(1):production环境中的continuous training不涉及特定的stopping step number。(2):恒定学习率可以在整个训练过程中对所有的intermediate data points进行完美且精确的插值。
不同大小模型的超参数汇总在
Table 6中。所有模型都从其对应的Continued Pre-training checkpoints(均使用Iso-FLOPSFLOPs数值均不包括Continued Pre-training training FLOPs。
A.2 Scaling Pilot Study
作为
scaling study的前期准备,我们使用MoE-900M模型进行了一项试点研究。该试点的目标是确定模型对两个超参数(global batch size和学习率)的敏感性。该试点的结果将为后续更广泛的scaling analysis提供超参数选择的依据,确保计算资源得到有效利用。Experiment Setup:我们并行运行了四个trainers,每个使用256 TPUs,并从(相同的)pre-trained checkpoint初始化。试点运行了大约两周,这段时间足以建立明确的性能趋势。"base setup" (Trainer A)使用HBM饱和的batch size。其他configurations则系统地改变这两个超参数中的一个。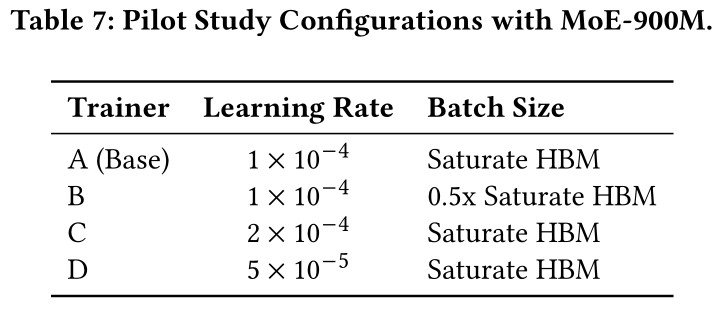
Results:Learning Rate Sensitivity:结果表明,在合理的范围内,training过程对不同的学习率具有容忍度。具体来说,在试点研究期间,基础学习率Trainer A)和较低学习率Trainer D)之间的性能差异在统计上不显著。然而,将学习率加倍至Trainer C)会导致性能显著下降,表明该学习率可能超出了该模型和数据集的理想范围。Batch Size Sensitivity:使用较小的batch size会损害训练效率。将batch size减半需要超过两倍的training steps才能达到相当的性能水平。这凸显了为了达到compute optimal training,将batch size最大化至硬件内存极限的重要性。
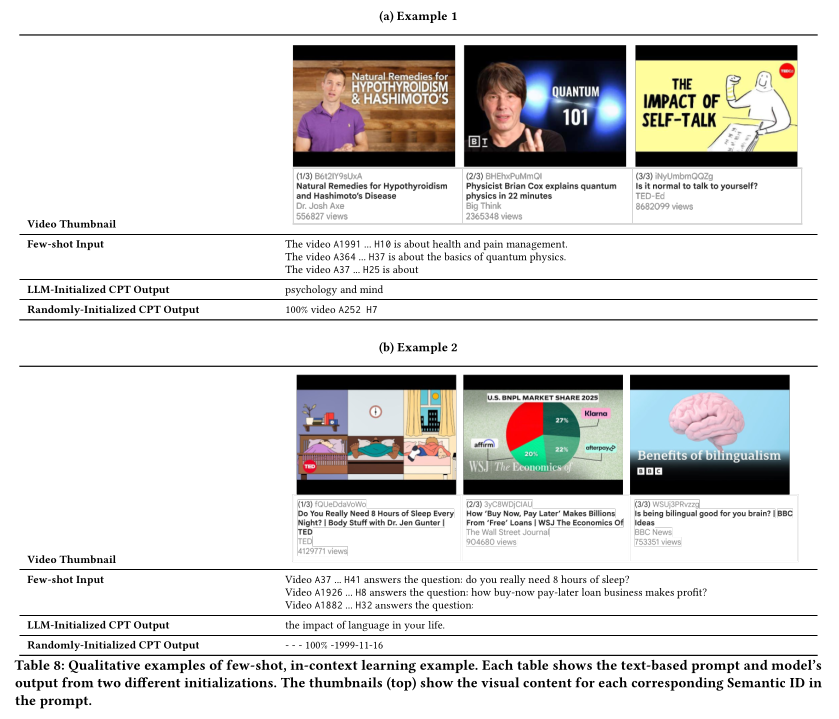
A.3 In-context Learning Examples
Table 8展示了一些示例,以演示model after CPT with Semantic IDs的in-context learning能力。基于pre-trained LLM的CPT model能够通过遵循few-shot task description,用语义上恰当的短语正确补全句子。相比之下,如果我们对randomly-initialized model应用相同的recs pre-training,该模型则难以形成连贯的短语,并且难以区分SID tokens和text tokens。